
Transformers documentation
PoolFormer
Bu model 2021-11-22 tarihinde HF papers'ta yayımlandı ve 2022-02-17 tarihinde Hugging Face Transformers'a katkıda bulunuldu.
PoolFormer
Genel Bakış
PoolFormer modeli, Sea AI Labs tarafından MetaFormer is Actually What You Need for Vision makalesinde önerilmiştir. SOTA performans elde etmek için karmaşık bir token mixer tasarlamak yerine, bu çalışmanın amacı, transformer modellerinin yetkinliğinin büyük ölçüde MetaFormer genel mimarisinden kaynaklandığını göstermektir.
Makalenin özeti aşağıdaki gibidir:
Transformers, bilgisayar görüsü görevlerinde büyük bir potansiyel göstermiştir. Genel kanı, yetkinliklerinin büyük ölçüde dikkat tabanlı token karıştırıcı modülünden kaynaklandığı yönündedir. Ancak, son çalışmalar, transformerlardaki dikkat tabanlı modülün uzamsal MLP'lerle değiştirilebileceğini ve elde edilen modellerin yine de oldukça iyi performans sergilediğini göstermektedir. Bu gözleme dayanarak, model performansına dikkat tabanlı token karıştırıcı modülünden ziyade transformerların genel mimarisinin daha temel olduğunu varsayıyoruz. Bunu doğrulamak için, transformerlardaki dikkat modülünü, yalnızca en temel token karıştırma işlemini gerçekleştiren, son derece basit bir uzamsal havuzlama operatörüyle kasıtlı olarak değiştiriyoruz. Şaşırtıcı bir şekilde, PoolFormer olarak adlandırılan türetilen modelin, birden fazla bilgisayar görüsü görevinde rekabetçi performans elde ettiğini gözlemliyoruz. Örneğin, ImageNet-1K üzerinde PoolFormer, %82,1 top-1 doğruluğa ulaşarak, iyi ayarlanmış DeiT-B/ResMLP-B24 gibi vision transformer/MLP benzeri baz modelleri, %35/%52 daha az parametre ve %48/%60 daha az MAC ile sırasıyla %0,3/%1,1 doğruluk farkıyla geride bırakmaktadır. PoolFormer'ın etkinliği, hipotezimizi doğrulamakta ve token karıştırıcıyı belirtmeden transformerlardan soyutlanan genel bir mimari olan “MetaFormer” kavramını başlatmamıza yol açmaktadır. Kapsamlı deneylere dayanarak, son dönemdeki transformer ve MLP benzeri modellerin görü görevlerinde üstün sonuçlar elde etmesindeki ana aktörün MetaFormer olduğunu savunuyoruz. Bu çalışma, token karıştırıcı modüllerine odaklanmak yerine MetaFormer'ı iyileştirmeye adanmış daha fazla gelecekteki araştırmayı gerektirmektedir. Ayrıca, önerdiğimiz PoolFormer, gelecekteki MetaFormer mimari tasarımının başlangıç baz modeli olarak hizmet verebilir.
Aşağıdaki şekil, PoolFormer mimarisini göstermektedir. orijinal makale'den alınmıştır.
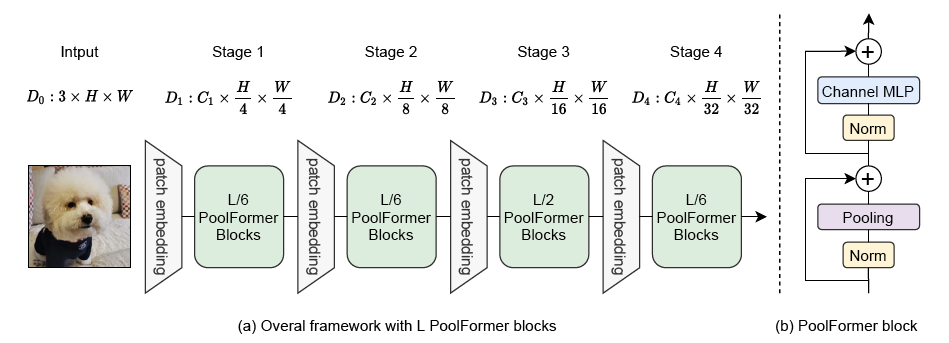
Bu model heytanay tarafından katkıda bulunmuştur. Orijinal kod burada bulunabilir.
Kullanım ipuçları
- PoolFormer hiyerarşik bir mimariye sahiptir; Attention yerine basit bir Average Pooling katmanı bulunur. Modelin tüm checkpoint'leri hub'da bulunabilir.
- Görselleri model için hazırlamak için PoolFormerImageProcessor kullanılabilir.
- PoolFormer, çoğu modelde olduğu gibi farklı boyutlarda gelir; bunların ayrıntıları aşağıdaki tabloda bulunabilir.
| Model varyantı | Derinlikler | Gizli boyutlar | Parametreler (M) | ImageNet-1k En İyi 1 |
|---|---|---|---|---|
| s12 | [2, 2, 6, 2] | [64, 128, 320, 512] | 12 | 77.2 |
| s24 | [4, 4, 12, 4] | [64, 128, 320, 512] | 21 | 80.3 |
| s36 | [6, 6, 18, 6] | [64, 128, 320, 512] | 31 | 81.4 |
| m36 | [6, 6, 18, 6] | [96, 192, 384, 768] | 56 | 82.1 |
| m48 | [8, 8, 24, 8] | [96, 192, 384, 768] | 73 | 82.5 |
Kaynaklar
PoolFormer ile başlamanıza yardımcı olmak için resmi Hugging Face ve topluluk (🌎 ile belirtilen) kaynaklarının listesi.
- Bu defter PoolFormerForImageClassification sınıfını destekler.
- Bkz: Görsel sınıflandırma görevi kılavuzu
Buraya bir kaynak eklemek isterseniz, bir Pull Request açmaktan çekinmeyin; inceleyeceğiz! Kaynağın, mevcut bir kaynağı tekrarlamak yerine ideal olarak yeni bir şeyi göstermesi beklenir.
PoolFormerConfig
sınıf transformers.PoolFormerConfig
< source >( transformers_version: str | None = Nonearchitectures: list[str] | None = Noneoutput_hidden_states: bool | None = Falsereturn_dict: bool | None = Truedtype: str | torch.dtype | None = Nonechunk_size_feed_forward: int = 0is_encoder_decoder: bool = Falseid2label: dict[int, str] | dict[str, str] | None = Nonelabel2id: dict[str, int] | dict[str, str] | None = Noneproblem_type: Literal['regression', 'single_label_classification', 'multi_label_classification'] | None = Nonenum_channels: int = 3patch_size: int | list[int] | tuple[int, int] = 16stride: int = 16pool_size: int = 3mlp_ratio: float = 4.0depths: list[int] | tuple[int, ...] = (2, 2, 6, 2)hidden_sizes: list[int] | tuple[int, ...] = (64, 128, 320, 512)patch_sizes: list[int] | tuple[int, ...] = (7, 3, 3, 3)strides: list[int] | tuple[int, ...] = (4, 2, 2, 2)padding: list[int] | tuple[int, ...] = (2, 1, 1, 1)num_encoder_blocks: int = 4drop_path_rate: float | int = 0.0hidden_act: str = 'gelu'use_layer_scale: bool = Truelayer_scale_init_value: float = 1e-05initializer_range: float = 0.02 )
Parametreler
- num_channels (
int, isteğe bağlı, varsayılan3) — Giriş kanal sayısı. - patch_size (
Union[int, list[int], tuple[int, int]], isteğe bağlı, varsayılan16) — Her yamanın boyutu (çözünürlüğü). - stride (
int, isteğe bağlı, varsayılan 16) — Girdi yamasının adımı. - pool_size (
int, isteğe bağlı, varsayılan 3) — Havuzlama penceresinin boyutu. - mlp_ratio (
float, isteğe bağlı, varsayılan4.0) — MLP gizli boyutunun gömme boyutuna oranı. - depths (
Union[list[int], tuple[int, ...]], isteğe bağlı, varsayılan(2, 2, 6, 2)) — Transformer'daki her katmanın derinliği. - hidden_sizes (
Union[list[int], tuple[int, ...]], isteğe bağlı, varsayılan(64, 128, 320, 512)) — Modelin her aşamasındaki boyutluluk (gizli boyut). - patch_sizes (
list, isteğe bağlı, varsayılan[7, 3, 3, 3]) — Her kodlayıcı bloğu için girdi yamasının boyutu. - strides (
list, isteğe bağlı, varsayılan[4, 2, 2, 2]) — Her kodlayıcı bloğu için giriş yamasının kaydırma adımı. - padding (
list, isteğe bağlı, varsayılan[2, 1, 1, 1]) — Her kodlayıcı bloğu için girdi yamasının dolgu (padding) değerleri. - num_encoder_blocks (
int, isteğe bağlı, varsayılan 4) — Encoder bloklarının sayısı. - drop_path_rate (
Union[float, int], isteğe bağlı, varsayılan0.0) — Patch füzyonu için drop path oranı. - hidden_act (
str, isteğe bağlı, varsayılangelu) — Çözücüdeki doğrusal olmayan aktivasyon fonksiyonu (fonksiyon veya dize). Örneğin,"gelu","relu","silu"vb. - use_layer_scale (
bool, isteğe bağlı, varsayılanTrue) — Layer scale kullanılıp kullanılmayacağı. - layer_scale_init_value (
float, isteğe bağlı, varsayılan1e-05) — Öz-dikkat katmanlarında kullanılacak ölçek. Baz modeller için 0.1, büyük modeller için 1e-6. Katman ölçeklemeyi devre dışı bırakmak için 0 olarak ayarlayın. - initializer_range (
float, isteğe bağlı, varsayılan0.02) — Tüm ağırlık matrislerini başlatmak için kullanılan truncated_normal_initializer'ın standart sapması.
Bu, bir PoolFormerModel yapılandırmasını depolamak için kullanılan yapılandırma sınıfıdır. Belirtilen argümanlara göre bir Poolformer modelinin örneklenmesi ve model mimarisinin tanımlanması için kullanılır. Varsayılan değerlerle bir yapılandırma örneği oluşturmak, sail/poolformer_s12 yapılandırmasına benzer bir yapılandırma üretir.
Yapılandırma nesneleri PreTrainedConfig sınıfından devralır ve model çıktılarını kontrol etmek için kullanılabilir. Daha fazla bilgi için PreTrainedConfig belgesini okuyun.
Örnek:
>>> from transformers import PoolFormerConfig, PoolFormerModel

>>> # Initializing a PoolFormer sail/poolformer_s12 style configuration
>>> configuration = PoolFormerConfig()

>>> # Initializing a model (with random weights) from the sail/poolformer_s12 style configuration
>>> model = PoolFormerModel(configuration)

>>> # Accessing the model configuration
>>> configuration = model.config
PoolFormerImageProcessor
sınıf transformers.PoolFormerImageProcessor
< source >( **kwargs: *<class 'transformers.models.poolformer.image_processing_poolformer.PoolFormerImageProcessorKwargs'> )
Parametreler
- do_convert_rgb (
bool, kwargs, isteğe bağlı, varsayılanNone) — Görselin RGB'ye dönüştürülüp dönüştürülmeyeceği. - do_resize (
bool, kwargs, isteğe bağlı, varsayılanTrue) — Görselin yeniden boyutlandırılıp boyutlandırılmayacağı. - size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None], kwargs, varsayılan{'shortest_edge' -- 224}): Modelin kabul ettiği maksimum giriş boyutlarını açıklar. - default_to_square (
bool, kwargs, isteğe bağlı, varsayılanFalse) — size bir int ise, yeniden boyutlandırma sırasında varsayılan olarak kare bir görüntü kullanılıp kullanılmayacağı. - crop_size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None], kwargs, varsayılan{'height' -- 224, 'width': 224}):center_cropuygulandıktan sonra çıktı görüntüsünün boyutu. - resample (
Annotated[Union[int, PILImageResampling, NoneType], None], kwargs, varsayılan3) — Görsel yeniden boyutlandırılıyorsa kullanılacak yeniden örnekleme filtresi. Bu,PILImageResamplingenum değerlerinden biri olabilir. Yalnızcado_resizeTrueolarak ayarlanırsa etkilidir. - do_rescale (
bool, kwargs, isteğe bağlı, varsayılanTrue) — Görselin yeniden ölçeklendirilip ölçeklendirilmeyeceği. - rescale_factor (
float, kwargs, opsiyonel, varsayılan0.00392156862745098) —do_rescaleTrueolarak ayarlandığında görüntüyü yeniden ölçeklemek için kullanılan yeniden ölçekleme faktörü. - do_normalize (
bool, kwargs, opsiyonel, varsayılanTrue) — Görselin normalize edilip edilmeyeceği. - image_mean (
Union[float, list[float], tuple[float, ...]], kwargs, opsiyonel, varsayılan[0.485, 0.456, 0.406]) — Normalizasyon için kullanılacak görüntü ortalaması. Yalnızcado_normalizeTrueolarak ayarlanırsa etkilidir. - image_std (
Union[float, list[float], tuple[float, ...]], kwargs, opsiyonel, varsayılan[0.229, 0.224, 0.225]) — Normalizasyon için kullanılacak görüntü standart sapması. Yalnızcado_normalizeTrueolarak ayarlanırsa etkilidir. - do_pad (
bool, kwargs, opsiyonel) — Görselin dolgu (padding) uygulanıp uygulanmayacağı. Dolgu, partideki en büyük boyuta veya görsel başına sabit kare bir boyuta yapılır. Kesin dolgu stratejisi modele bağlıdır. - pad_size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None], kwargs) — Görsellerin doldurulacağı boyut,{"height": int, "width" int}biçiminde. Ön işleme için sağlanan herhangi bir görsel boyutundan büyük olmalıdır.pad_sizesağlanmazsa, görseller batch içindeki en büyük yüksekliğe ve genişliğe doldurulur. Yalnızcado_pad=True.olduğunda uygulanır. - do_center_crop (
bool, kwargs, opsiyonel, varsayılanTrue) — Görselin ortadan kırpılıp kırpılmayacağı. - data_format (
Union[str, ~image_utils.ChannelDimension], kwargs, isteğe bağlı) — YalnızcaChannelDimension.FIRSTdesteklenir. Yavaş işleyicilerle uyumluluk için eklendi. - input_data_format (
Union[str, ~image_utils.ChannelDimension], kwargs, isteğe bağlı) — Girdi görüntüsü için kanal boyutu biçimi. Ayarlanmazsa, kanal boyutu biçimi girdi görüntüsünden çıkarılır. Aşağıdakilerden biri olabilir:"channels_first"veyaChannelDimension.FIRST: (num_channels, height, width) biçiminde görüntü."channels_last"veyaChannelDimension.LAST: (yükseklik, genişlik, kanal sayısı) biçiminde görüntü."none"veyaChannelDimension.NONE: (height, width) biçiminde görüntü.
- device (
Annotated[Union[str, torch.device, NoneType], None], kwargs) — Videoların işleneceği cihaz. Ayarlanmamışsa, cihaz girdi videolarından çıkarılır. - return_tensors (
Annotated[str | ~utils.generic.TensorType | None, None], kwargs) —'pt'olarak ayarlanırsa yığılmış tensörler döndürür, aksi takdirde tensör listesi döndürür. - disable_grouping (
bool, kwargs, opsiyonel) — Görsellerin boyuta göre gruplandırılmasını devre dışı bırakıp onları toplu olarak değil, bireysel olarak işlenmesini belirtir. None ise, görseller CPU üzerindeyse True, aksi halde False olarak ayarlanır. Bu seçim, burada ayrıntılandırıldığı üzere ampirik gözlemlere dayanmaktadır: https://github.com/huggingface/transformers/pull/38157 - image_seq_length (
int, kwargs, isteğe bağlı) — Girdideki her görüntü için kullanılacak görüntü jetonlarının sayısı. Geriye dönük uyumluluk için eklendi ancak gelecekteki modellerde bu, bir işlemci özniteliği olarak ayarlanmalıdır. - crop_pct (
float, kwargs, isteğe bağlı, varsayılanself.crop_pct) — Kesilecek görüntü yüzdesi. Yalnızcado_resizeTrueolarak ayarlanırsa etkilidir.
PoolFormerImageProcessor görüntü işleyicisi oluşturur.
ön işleme
< source >( images: typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor']]*argsimage_like_kwargs: dict[str, typing.Any] | None = None**kwargs: *<class 'transformers.processing_utils.ImagesKwargs'> ) → ~image_processing_base.BatchFeature
Parametreler
- images (
Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor]]) — Ön işleme uygulanacak görüntü. Piksel değerleri 0 ile 255 arasında değişen tek bir görüntü veya görüntü grubu beklenir. Piksel değerleri 0 ile 1 arasında olan görüntüler geçiriliyorsado_rescale=Falseolarak ayarlayın. - image_like_kwargs (
dict[str, Any], isteğe bağlı) — Ayrıca ön işleme yapılacak ek görüntü benzeri girdiler için geliştirici bayrağı. Girdileri kwarg olarak geçirmek işe yaramadığında yalnızca bu bayrağı kullanın. Örneğin,preprocess(images, masks=masks)tercih edilen seçenektir ancak bazı modellerde argüman öncelik sorunlarına yol açar. Bu durumlarda bunun yerinepreprocess(images, image_like_inputs={"masks": masks})kullanılabilir. - do_convert_rgb (
bool, kwargs, opsiyonel) — Görselin RGB'ye dönüştürülüp dönüştürülmemesi. - do_resize (
bool, kwargs, opsiyonel) — Görselin yeniden boyutlandırılıp boyutlandırılmayacağı. - size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None], kwargs) — Modelin kabul ettiği maksimum giriş boyutlarını açıklar. - default_to_square (
bool, kwargs, opsiyonel) — Boyut bir int ise, yeniden boyutlandırma sırasında varsayılan olarak kare bir görüntüye geçilip geçilmeyeceği. - crop_size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None], kwargs) —center_cropuygulandıktan sonra çıktı görüntüsünün boyutu. - resample (
Annotated[Union[int, PILImageResampling, NoneType], None], kwargs) — Görsel yeniden boyutlandırılıyorsa kullanılacak yeniden örnekleme filtresi. Bu,PILImageResamplingenum değerlerinden biri olabilir. Yalnızcado_resizeTrueolarak ayarlanırsa etkilidir. - do_rescale (
bool, kwargs, opsiyonel) — Görselin yeniden ölçeklendirilip ölçeklendirilmeyeceği. - rescale_factor (
float, kwargs, opsiyonel) —do_rescaleTrueolarak ayarlanırsa görüntüyü yeniden ölçeklemek için kullanılan yeniden ölçekleme faktörü. - do_normalize (
bool, kwargs, opsiyonel) — Görselin normalize edilip edilmeyeceği. - image_mean (
Union[float, list[float], tuple[float, ...]], kwargs, opsiyonel) — Normalizasyon için kullanılacak görüntü ortalaması. Yalnızcado_normalizeTrueolarak ayarlanırsa etkilidir. - image_std (
Union[float, list[float], tuple[float, ...]], kwargs, opsiyonel) — Normalizasyon için kullanılacak görüntü standart sapması. Yalnızcado_normalizeTrueolarak ayarlanmışsa etkilidir. - do_pad (
bool, kwargs, opsiyonel) — Görselin dolgu (padding) uygulanıp uygulanmayacağı. Dolgu, partideki en büyük boyuta veya görsel başına sabit kare bir boyuta yapılır. Kesin dolgu stratejisi modele bağlıdır. - pad_size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None], kwargs) — Görsellerin doldurulacağı boyut,{"height": int, "width" int}biçiminde. Ön işleme için sağlanan herhangi bir görsel boyutundan büyük olmalıdır.pad_sizesağlanmazsa, görseller batch içindeki en büyük yüksekliğe ve genişliğe doldurulur. Yalnızcado_pad=True.olduğunda uygulanır. - do_center_crop (
bool, kwargs, opsiyonel) — Görselin ortadan kırpılıp kırpılmayacağı. - data_format (
Union[str, ~image_utils.ChannelDimension], kwargs, isteğe bağlı) — YalnızcaChannelDimension.FIRSTdesteklenir. Yavaş işleyicilerle uyumluluk için eklendi. - input_data_format (
Union[str, ~image_utils.ChannelDimension], kwargs, isteğe bağlı) — Girdi görüntüsü için kanal boyutu biçimi. Ayarlanmazsa, kanal boyutu biçimi girdi görüntüsünden çıkarılır. Aşağıdakilerden biri olabilir:"channels_first"veyaChannelDimension.FIRST: (num_channels, height, width) biçiminde görüntü."channels_last"veyaChannelDimension.LAST: (yükseklik, genişlik, kanal sayısı) biçiminde görüntü."none"veyaChannelDimension.NONE: (height, width) biçiminde görüntü.
- device (
Annotated[Union[str, torch.device, NoneType], None], kwargs) — Videoların işleneceği cihaz. Ayarlanmamışsa, cihaz girdi videolarından çıkarılır. - return_tensors (
Annotated[str | ~utils.generic.TensorType | None, None], kwargs) —'pt'olarak ayarlanırsa yığılmış tensörler döndürür, aksi takdirde tensör listesi döndürür. - disable_grouping (
bool, kwargs, opsiyonel) — Görsellerin boyuta göre gruplandırılmasını devre dışı bırakıp onları toplu olarak değil, bireysel olarak işlenmesini belirtir. None ise, görseller CPU üzerindeyse True, aksi halde False olarak ayarlanır. Bu seçim, burada ayrıntılandırıldığı üzere ampirik gözlemlere dayanmaktadır: https://github.com/huggingface/transformers/pull/38157 - image_seq_length (
int, kwargs, isteğe bağlı) — Girdideki her görüntü için kullanılacak görüntü jetonlarının sayısı. Geriye dönük uyumluluk için eklendi ancak gelecekteki modellerde bu, bir işlemci özniteliği olarak ayarlanmalıdır.
Dönüş değeri
~image_processing_base.BatchFeature
- data (
dict) — call yönteminin döndürdüğü listeler/diziler/tensörler sözlüğü (‘pixel_values’ vb.). - tensor_type (
Union[None, str, TensorType], isteğe bağlı) — Başlatma sırasında PyTorch/Numpy Tensörlerindeki tamsayı listelerini dönüştürmek için burada bir tensor_type verebilirsiniz.
Bir görüntüyü veya bir görüntü grubunu ön işleme tabi tutun.
PoolFormerImageProcessorPil
sınıf transformers.PoolFormerImageProcessorPil
< source >( **kwargs: *<class 'transformers.models.poolformer.image_processing_pil_poolformer.PoolFormerImageProcessorKwargs'> )
Parametreler
- do_convert_rgb (
bool, kwargs, isteğe bağlı, varsayılanNone) — Görselin RGB'ye dönüştürülüp dönüştürülmeyeceği. - do_resize (
bool, kwargs, isteğe bağlı, varsayılanTrue) — Görselin yeniden boyutlandırılıp boyutlandırılmayacağı. - size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None], kwargs, varsayılan{'shortest_edge' -- 224}): Modelin kabul ettiği maksimum giriş boyutlarını açıklar. - default_to_square (
bool, kwargs, isteğe bağlı, varsayılanFalse) — size bir int ise, yeniden boyutlandırma sırasında varsayılan olarak kare bir görüntü kullanılıp kullanılmayacağı. - crop_size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None], kwargs, varsayılan{'height' -- 224, 'width': 224}):center_cropuygulandıktan sonra çıktı görüntüsünün boyutu. - resample (
Annotated[Union[int, PILImageResampling, NoneType], None], kwargs, varsayılan3) — Görsel yeniden boyutlandırılıyorsa kullanılacak yeniden örnekleme filtresi. Bu,PILImageResamplingenum değerlerinden biri olabilir. Yalnızcado_resizeTrueolarak ayarlanırsa etkilidir. - do_rescale (
bool, kwargs, isteğe bağlı, varsayılanTrue) — Görselin yeniden ölçeklendirilip ölçeklendirilmeyeceği. - rescale_factor (
float, kwargs, opsiyonel, varsayılan0.00392156862745098) —do_rescaleTrueolarak ayarlandığında görüntüyü yeniden ölçeklemek için kullanılan yeniden ölçekleme faktörü. - do_normalize (
bool, kwargs, opsiyonel, varsayılanTrue) — Görselin normalize edilip edilmeyeceği. - image_mean (
Union[float, list[float], tuple[float, ...]], kwargs, opsiyonel, varsayılan[0.485, 0.456, 0.406]) — Normalizasyon için kullanılacak görüntü ortalaması. Yalnızcado_normalizeTrueolarak ayarlanırsa etkilidir. - image_std (
Union[float, list[float], tuple[float, ...]], kwargs, opsiyonel, varsayılan[0.229, 0.224, 0.225]) — Normalizasyon için kullanılacak görüntü standart sapması. Yalnızcado_normalizeTrueolarak ayarlanırsa etkilidir. - do_pad (
bool, kwargs, opsiyonel) — Görselin dolgu (padding) uygulanıp uygulanmayacağı. Dolgu, partideki en büyük boyuta veya görsel başına sabit kare bir boyuta yapılır. Kesin dolgu stratejisi modele bağlıdır. - pad_size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None], kwargs) — Görsellerin doldurulacağı boyut,{"height": int, "width" int}biçiminde. Ön işleme için sağlanan herhangi bir görsel boyutundan büyük olmalıdır.pad_sizesağlanmazsa, görseller batch içindeki en büyük yüksekliğe ve genişliğe doldurulur. Yalnızcado_pad=True.olduğunda uygulanır. - do_center_crop (
bool, kwargs, opsiyonel, varsayılanTrue) — Görselin ortadan kırpılıp kırpılmayacağı. - data_format (
Union[str, ~image_utils.ChannelDimension], kwargs, isteğe bağlı) — YalnızcaChannelDimension.FIRSTdesteklenir. Yavaş işleyicilerle uyumluluk için eklendi. - input_data_format (
Union[str, ~image_utils.ChannelDimension], kwargs, isteğe bağlı) — Girdi görüntüsü için kanal boyutu biçimi. Ayarlanmazsa, kanal boyutu biçimi girdi görüntüsünden çıkarılır. Aşağıdakilerden biri olabilir:"channels_first"veyaChannelDimension.FIRST: (num_channels, height, width) biçiminde görüntü."channels_last"veyaChannelDimension.LAST: (yükseklik, genişlik, kanal sayısı) biçiminde görüntü."none"veyaChannelDimension.NONE: (height, width) biçiminde görüntü.
- device (
Annotated[Union[str, torch.device, NoneType], None], kwargs) — Videoların işleneceği cihaz. Ayarlanmamışsa, cihaz girdi videolarından çıkarılır. - return_tensors (
Annotated[str | ~utils.generic.TensorType | None, None], kwargs) —'pt'olarak ayarlanırsa yığılmış tensörler döndürür, aksi takdirde tensör listesi döndürür. - disable_grouping (
bool, kwargs, opsiyonel) — Görsellerin boyuta göre gruplandırılmasını devre dışı bırakıp onları toplu olarak değil, bireysel olarak işlenmesini belirtir. None ise, görseller CPU üzerindeyse True, aksi halde False olarak ayarlanır. Bu seçim, burada ayrıntılandırıldığı üzere ampirik gözlemlere dayanmaktadır: https://github.com/huggingface/transformers/pull/38157 - image_seq_length (
int, kwargs, isteğe bağlı) — Girdideki her görüntü için kullanılacak görüntü jetonlarının sayısı. Geriye dönük uyumluluk için eklendi ancak gelecekteki modellerde bu, bir işlemci özniteliği olarak ayarlanmalıdır. - crop_pct (
float, kwargs, isteğe bağlı, varsayılanself.crop_pct) — Kesilecek görüntü yüzdesi. Yalnızcado_resizeTrueolarak ayarlanırsa etkilidir.
PoolFormerImageProcessor görüntü işleyicisi oluşturur.
ön işleme
< source >( images: typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor']]*argsimage_like_kwargs: dict[str, typing.Any] | None = None**kwargs: *<class 'transformers.processing_utils.ImagesKwargs'> ) → ~image_processing_base.BatchFeature
Parametreler
- images (
Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor]]) — Ön işleme uygulanacak görüntü. Piksel değerleri 0 ile 255 arasında değişen tek bir görüntü veya görüntü grubu beklenir. Piksel değerleri 0 ile 1 arasında olan görüntüler geçiriliyorsado_rescale=Falseolarak ayarlayın. - image_like_kwargs (
dict[str, Any], isteğe bağlı) — Ayrıca ön işleme yapılacak ek görüntü benzeri girdiler için geliştirici bayrağı. Girdileri kwarg olarak geçirmek işe yaramadığında yalnızca bu bayrağı kullanın. Örneğin,preprocess(images, masks=masks)tercih edilen seçenektir ancak bazı modellerde argüman öncelik sorunlarına yol açar. Bu durumlarda bunun yerinepreprocess(images, image_like_inputs={"masks": masks})kullanılabilir. - do_convert_rgb (
bool, kwargs, opsiyonel) — Görselin RGB'ye dönüştürülüp dönüştürülmemesi. - do_resize (
bool, kwargs, opsiyonel) — Görselin yeniden boyutlandırılıp boyutlandırılmayacağı. - size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None], kwargs) — Modelin kabul ettiği maksimum giriş boyutlarını açıklar. - default_to_square (
bool, kwargs, opsiyonel) — Boyut bir int ise, yeniden boyutlandırma sırasında varsayılan olarak kare bir görüntüye geçilip geçilmeyeceği. - crop_size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None], kwargs) —center_cropuygulandıktan sonra çıktı görüntüsünün boyutu. - resample (
Annotated[Union[int, PILImageResampling, NoneType], None], kwargs) — Görsel yeniden boyutlandırılıyorsa kullanılacak yeniden örnekleme filtresi. Bu,PILImageResamplingenum değerlerinden biri olabilir. Yalnızcado_resizeTrueolarak ayarlanırsa etkilidir. - do_rescale (
bool, kwargs, opsiyonel) — Görselin yeniden ölçeklendirilip ölçeklendirilmeyeceği. - rescale_factor (
float, kwargs, opsiyonel) —do_rescaleTrueolarak ayarlanırsa görüntüyü yeniden ölçeklemek için kullanılan yeniden ölçekleme faktörü. - do_normalize (
bool, kwargs, opsiyonel) — Görselin normalize edilip edilmeyeceği. - image_mean (
Union[float, list[float], tuple[float, ...]], kwargs, opsiyonel) — Normalizasyon için kullanılacak görüntü ortalaması. Yalnızcado_normalizeTrueolarak ayarlanırsa etkilidir. - image_std (
Union[float, list[float], tuple[float, ...]], kwargs, opsiyonel) — Normalizasyon için kullanılacak görüntü standart sapması. Yalnızcado_normalizeTrueolarak ayarlanmışsa etkilidir. - do_pad (
bool, kwargs, opsiyonel) — Görselin dolgu (padding) uygulanıp uygulanmayacağı. Dolgu, partideki en büyük boyuta veya görsel başına sabit kare bir boyuta yapılır. Kesin dolgu stratejisi modele bağlıdır. - pad_size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None], kwargs) — Görsellerin doldurulacağı boyut,{"height": int, "width" int}biçiminde. Ön işleme için sağlanan herhangi bir görsel boyutundan büyük olmalıdır.pad_sizesağlanmazsa, görseller batch içindeki en büyük yüksekliğe ve genişliğe doldurulur. Yalnızcado_pad=True.olduğunda uygulanır. - do_center_crop (
bool, kwargs, opsiyonel) — Görselin ortadan kırpılıp kırpılmayacağı. - data_format (
Union[str, ~image_utils.ChannelDimension], kwargs, isteğe bağlı) — YalnızcaChannelDimension.FIRSTdesteklenir. Yavaş işleyicilerle uyumluluk için eklendi. - input_data_format (
Union[str, ~image_utils.ChannelDimension], kwargs, isteğe bağlı) — Girdi görüntüsü için kanal boyutu biçimi. Ayarlanmazsa, kanal boyutu biçimi girdi görüntüsünden çıkarılır. Aşağıdakilerden biri olabilir:"channels_first"veyaChannelDimension.FIRST: (num_channels, height, width) biçiminde görüntü."channels_last"veyaChannelDimension.LAST: (yükseklik, genişlik, kanal sayısı) biçiminde görüntü."none"veyaChannelDimension.NONE: (height, width) biçiminde görüntü.
- device (
Annotated[Union[str, torch.device, NoneType], None], kwargs) — Videoların işleneceği cihaz. Ayarlanmamışsa, cihaz girdi videolarından çıkarılır. - return_tensors (
Annotated[str | ~utils.generic.TensorType | None, None], kwargs) —'pt'olarak ayarlanırsa yığılmış tensörler döndürür, aksi takdirde tensör listesi döndürür. - disable_grouping (
bool, kwargs, opsiyonel) — Görsellerin boyuta göre gruplandırılmasını devre dışı bırakıp onları toplu olarak değil, bireysel olarak işlenmesini belirtir. None ise, görseller CPU üzerindeyse True, aksi halde False olarak ayarlanır. Bu seçim, burada ayrıntılandırıldığı üzere ampirik gözlemlere dayanmaktadır: https://github.com/huggingface/transformers/pull/38157 - image_seq_length (
int, kwargs, isteğe bağlı) — Girdideki her görüntü için kullanılacak görüntü jetonlarının sayısı. Geriye dönük uyumluluk için eklendi ancak gelecekteki modellerde bu, bir işlemci özniteliği olarak ayarlanmalıdır.
Dönüş değeri
~image_processing_base.BatchFeature
- data (
dict) — call yönteminin döndürdüğü listeler/diziler/tensörler sözlüğü (‘pixel_values’ vb.). - tensor_type (
Union[None, str, TensorType], isteğe bağlı) — Başlatma sırasında PyTorch/Numpy Tensörlerindeki tamsayı listelerini dönüştürmek için burada bir tensor_type verebilirsiniz.
Bir görüntüyü veya bir görüntü grubunu ön işleme tabi tutun.
PoolFormerModel
sınıf transformers.PoolFormerModel
< source >( config: PoolFormerConfig )
Parametreler
- config (PoolFormerConfig) — Modelin tüm parametrelerini içeren model yapılandırma sınıfı. Bir yapılandırma dosyasıyla başlatmak, modelle ilişkili ağırlıkları yüklemez, yalnızca yapılandırmayı yükler. Model ağırlıklarını yüklemek için from_pretrained() yöntemine bakın.
Üzerinde herhangi bir özel başlık olmadan ham gizli durumları (hidden-states) üreten çıplak Poolformer Modeli.
Bu model PreTrainedModel sınıfından devralır. Kütüphanenin tüm modelleri için uyguladığı genel yöntemler (indirme veya kaydetme, giriş gömme boyutlarını yeniden boyutlandırma, başları budama vb.) için üst sınıf belgelendirmesine bakın.
Bu model aynı zamanda bir PyTorch torch.nn.Module alt sınıfıdır. Bunu standart bir PyTorch Module olarak kullanın ve genel kullanım ve davranışla ilgili tüm konular için PyTorch dokümantasyonuna başvurun.
forward
< source >( pixel_values: typing.Optional[torch.Tensor] = Noneoutput_hidden_states: bool | None = Nonereturn_dict: bool | None = None**kwargs ) → BaseModelOutputWithNoAttention or tuple(torch.Tensor)
Parametreler
- pixel_values (
torch.Tensor, şekli(batch_size, num_channels, image_size, image_size), isteğe bağlı) — Girdi görüntülerine karşılık gelen tensörler. Piksel değerleri PoolFormerImageProcessor kullanılarak elde edilebilir. Ayrıntılar için PoolFormerImageProcessor.call() bölümüne bakın (processor_class, görüntüleri işlemek için PoolFormerImageProcessor kullanır). - output_hidden_states (
bool, isteğe bağlı) — Tüm katmanların gizli durumlarının (hidden states) döndürülüp döndürülmeyeceğini belirtir. Daha fazla ayrıntı için döndürülen tensörler altındakihidden_statesbölümüne bakın. - return_dict (
bool, isteğe bağlı) — Düz bir tuple yerine ModelOutput döndürülecek mi?
Dönüş değeri
BaseModelOutputWithNoAttention veya tuple(torch.Tensor)
BaseModelOutputWithNoAttention veya bir torch.Tensor demeti (eğer return_dict=False geçirildiyse veya config.return_dict=False ise), yapılandırmaya (PoolFormerConfig) ve girdilere bağlı olarak çeşitli öğelerden oluşur.
PoolFormerModel forward metodu, __call__ özel metodunu geçersiz kılar.
İleri geçiş tarifi bu fonksiyon içinde tanımlanmalı olsa da, sonrasında bunun yerine
Moduleörneğini çağırmak gerekir; çünkü önceki, ön ve son işleme adımlarını çalıştırmaktan sorumluyken ikincisi bunları sessizce yok sayar.
last_hidden_state (
torch.Tensor, şekli(batch_size, num_channels, height, width)) — Modelin son katmanının çıktısındaki gizli durumlar dizisi.hidden_states (
tuple(torch.Tensor), isteğe bağlı,output_hidden_states=Truegeçirildiğinde veyaconfig.output_hidden_states=Trueolduğunda döndürülür) —torch.Tensor(modelin bir gömme katmanı varsa gömme katmanının çıktısı için bir tane + her katmanın çıktısı için birer tane) içeren,(batch_size, num_channels, height, width)biçiminde bir demet.Her katmanın çıktısında modelin gizli durumları ve isteğe bağlı başlangıç gömme çıktıları.
PoolFormerForImageClassification
sınıf transformers.PoolFormerForImageClassification
< source >( config: PoolFormerConfig )
Parametreler
- config (PoolFormerConfig) — Modelin tüm parametrelerini içeren model yapılandırma sınıfı. Bir yapılandırma dosyasıyla başlatmak, modelle ilişkili ağırlıkları yüklemez, yalnızca yapılandırmayı yükler. Model ağırlıklarını yüklemek için from_pretrained() yöntemine bakın.
PoolFormer Model, üstünde bir görüntü sınıflandırma başlığı bulunan transformer
Bu model PreTrainedModel sınıfından devralır. Kütüphanenin tüm modelleri için uyguladığı genel yöntemler (indirme veya kaydetme, giriş gömme boyutlarını yeniden boyutlandırma, başları budama vb.) için üst sınıf belgelendirmesine bakın.
Bu model aynı zamanda bir PyTorch torch.nn.Module alt sınıfıdır. Bunu standart bir PyTorch Module olarak kullanın ve genel kullanım ve davranışla ilgili tüm konular için PyTorch dokümantasyonuna başvurun.
forward
< source >( pixel_values: typing.Optional[torch.Tensor] = Nonelabels: typing.Optional[torch.LongTensor] = Noneoutput_hidden_states: bool | None = Nonereturn_dict: bool | None = None**kwargs ) → ImageClassifierOutputWithNoAttention or tuple(torch.Tensor)
Parametreler
- pixel_values (
torch.Tensor, şekli(batch_size, num_channels, image_size, image_size), isteğe bağlı) — Girdi görüntülerine karşılık gelen tensörler. Piksel değerleri PoolFormerImageProcessor kullanılarak elde edilebilir. Ayrıntılar için PoolFormerImageProcessor.call() bölümüne bakın (processor_class, görüntüleri işlemek için PoolFormerImageProcessor kullanır). - labels (
torch.LongTensor, şekli(batch_size,), isteğe bağlı) — Görüntü sınıflandırma/geri dönüşüm kaybını hesaplamak için etiketler. Endeksler[0, ..., config.num_labels - 1]aralığında olmalıdır.config.num_labels == 1ise bir geri dönüşüm kaybı (Ortalama Kare kaybı) hesaplanır,config.num_labels > 1ise bir sınıflandırma kaybı (Çapraz Entropi) hesaplanır. - output_hidden_states (
bool, isteğe bağlı) — Tüm katmanların gizli durumlarının (hidden states) döndürülüp döndürülmeyeceğini belirtir. Daha fazla ayrıntı için döndürülen tensörler altındakihidden_statesbölümüne bakın. - return_dict (
bool, isteğe bağlı) — Düz bir tuple yerine ModelOutput döndürülecek mi?
Dönüş değeri
ImageClassifierOutputWithNoAttention veya tuple(torch.Tensor)
A ImageClassifierOutputWithNoAttention veya bir torch.Tensor demeti (eğer return_dict=False geçirildiyse veya config.return_dict=False ise), yapılandırmaya (PoolFormerConfig) ve girdilere bağlı olarak çeşitli öğelerden oluşur.
PoolFormerForImageClassification forward metodu, __call__ özel metodunu geçersiz kılar.
İleri geçiş tarifi bu fonksiyon içinde tanımlanmalı olsa da, sonrasında bunun yerine
Moduleörneğini çağırmak gerekir; çünkü önceki, ön ve son işleme adımlarını çalıştırmaktan sorumluyken ikincisi bunları sessizce yok sayar.
- loss (
torch.Tensor, şekli(1,), isteğe bağlı,labelssağlandığında döndürülür) — Sınıflandırma (config.num_labels==1 ise regresyon) kaybı. - logits (
torch.Tensor, şekli(batch_size, config.num_labels)) — Sınıflandırma (veya config.num_labels==1 ise regresyon) puanları (SoftMax öncesi). - hidden_states (
tuple(torch.Tensor), isteğe bağlı,output_hidden_states=Truegeçirildiğinde veyaconfig.output_hidden_states=Trueolduğunda döndürülür) —torch.Tensor(modelin bir gömme katmanı varsa gömme katmanının çıktısı için bir tane + her aşamanın çıktısı için birer tane) içeren bir tuple, şekli(batch_size, num_channels, height, width). Modelin her aşamanın çıktısındaki gizli durumları (aynı zamanda özellik haritaları olarak da adlandırılır).
Örnek:
>>> from transformers import AutoImageProcessor, PoolFormerForImageClassification
>>> import torch
>>> from datasets import load_dataset

>>> dataset = load_dataset("huggingface/cats-image")
>>> image = dataset["test"]["image"][0]

>>> image_processor = AutoImageProcessor.from_pretrained("sail/poolformer_s12")
>>> model = PoolFormerForImageClassification.from_pretrained("sail/poolformer_s12")

>>> inputs = image_processor(image, return_tensors="pt")

>>> with torch.no_grad():
...     logits = model(**inputs).logits

>>> # model predicts one of the 1000 ImageNet classes
>>> predicted_label = logits.argmax(-1).item()
>>> print(model.config.id2label[predicted_label])
...