
Transformers documentation
FastSpeech2Conformer
Bu model 2020-10-26 tarihinde HF papers'ta yayımlanmış ve 2024-01-03 tarihinde Hugging Face Transformers'a katkıda bulunmuştur.
FastSpeech2Conformer
Genel Bakış
FastSpeech2Conformer modeli, Pengcheng Guo, Florian Boyer, Xuankai Chang, Tomoki Hayashi, Yosuke Higuchi, Hirofumi Inaguma, Naoyuki Kamo, Chenda Li, Daniel Garcia-Romero, Jiatong Shi, Jing Shi, Shinji Watanabe, Kun Wei, Wangyou Zhang ve Yuekai Zhang tarafından Recent Developments On Espnet Toolkit Boosted By Conformer adlı makaleyle önerilmiştir.
Orijinal FastSpeech2 makalesinin özeti aşağıdaki gibidir:
FastSpeech (Ren ve ark., 2019) gibi otoregresif olmayan metinden konuşma (TTS) modelleri, benzer kalitede ses sentezini önceki otoregresif modellere kıyasla çok daha hızlı gerçekleştirebilir. FastSpeech modelinin eğitimi, süre tahmini için (daha fazla bilgi girdi olarak sağlamak amacıyla) otoregresif bir öğretmen modeline ve (çıktıdaki veri dağılımını basitleştirmek amacıyla) bilgi damıtmasına dayanır; bu da TTS'deki bire-bir-çoklu eşleme sorununu (yani, aynı metne birden fazla ses varyasyonunun karşılık gelmesi) hafifletebilir. Ancak FastSpeech'in birkaç dezavantajı vardır: 1) öğretmen-öğrenci damıtma hattı karmaşıktır ve zaman alıcıdır, 2) öğretmen modelinden çıkarılan süre yeterince doğru değildir ve öğretmen modelinden damıtılan hedef mel-spektrogramları, veri basitleştirmesi nedeniyle bilgi kaybına uğrar; her ikisi de ses kalitesini sınırlar. Bu makalede, FastSpeech 2'yi öneriyoruz; bu model, FastSpeech'teki sorunları ele alır ve TTS'deki bire-bir-çoklu eşleme sorununu daha iyi çözer: 1) basitleştirilmiş öğretmen çıktısı yerine doğrudan gerçek hedefle modeli eğiterek ve 2) konuşmanın daha fazla varyasyon bilgisini (ör. perde, enerji ve daha doğru süre) koşullu girdi olarak tanıtarak. Özellikle, süre, perde ve enerjiyi ses dalgasından çıkarır ve bunları eğitimde doğrudan koşullu girdi olarak kullanır, çıkarımda ise tahmin edilen değerleri kullanır. Ayrıca, tamamen uçtan uca çıkarımın avantajından yararlanarak metinden paralel olarak doğrudan ses dalgası üretmenin ilk denemesi olan FastSpeech 2s'yi tasarladık. Deneysel sonuçlar şunları göstermektedir: 1) FastSpeech 2, FastSpeech'e kıyasla 3 kat eğitim hızlanmasına ulaşır ve FastSpeech 2s daha da hızlı çıkarım hızından yararlanır; 2) FastSpeech 2 ve 2s, ses kalitesi açısından FastSpeech'i geride bırakır ve FastSpeech 2 otoregresif modelleri bile geçebilir. Ses örnekleri https://speechresearch.github.io/fastspeech2/ adresinde mevcuttur.
Bu model Connor Henderson tarafından katkıda bulunmuştur. Orijinal kod burada bulunabilir.
🤗 Model Mimarisi
FastSpeech2’nin Mel-spektrogram çözücüye sahip genel yapısı uygulandı ve ESPnet kütüphanesinde yapıldığı gibi geleneksel transformer blokları, conformer bloklarıyla değiştirildi.
FastSpeech2 Model Mimarisi

Conformer Blokları

Konvolüsyon Modülü
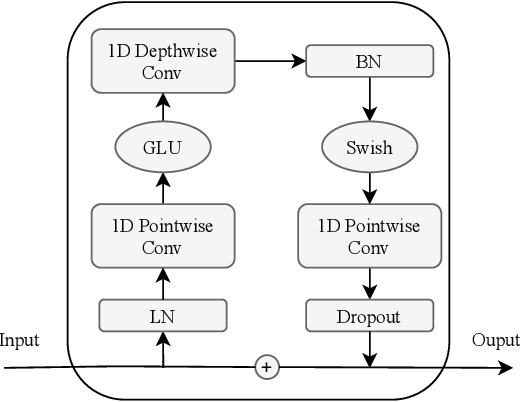
🤗 Transformers Kullanımı
FastSpeech2Conformer modelini 🤗 Transformers kütüphanesiyle yerel olarak çalıştırabilirsiniz.
- Önce 🤗 Transformers kütüphanesini ve g2p-en'i yükleyin:
pip install --upgrade pip
pip install --upgrade transformers g2p-en
- Modeli ve hifigan'ı ayrı ayrı kullanarak Transformers modelleme kodu üzerinden çıkarım yapın
import soundfile as sf

from transformers import FastSpeech2ConformerHifiGan, FastSpeech2ConformerModel, FastSpeech2ConformerTokenizer


tokenizer = FastSpeech2ConformerTokenizer.from_pretrained("espnet/fastspeech2_conformer")
inputs = tokenizer("Hello, my dog is cute.", return_tensors="pt").to(model.device)
input_ids = inputs["input_ids"]

model = FastSpeech2ConformerModel.from_pretrained("espnet/fastspeech2_conformer", device_map="auto")
output_dict = model(input_ids, return_dict=True)
spectrogram = output_dict["spectrogram"]

hifigan = FastSpeech2ConformerHifiGan.from_pretrained("espnet/fastspeech2_conformer_hifigan")
waveform = hifigan(spectrogram)

sf.write("speech.wav", waveform.squeeze().detach().numpy(), samplerate=22050)- Modeli ve hifigan'ı birleştirerek Transformers modelleme kodu üzerinden çıkarım yapın
import soundfile as sf

from transformers import FastSpeech2ConformerTokenizer, FastSpeech2ConformerWithHifiGan


tokenizer = FastSpeech2ConformerTokenizer.from_pretrained("espnet/fastspeech2_conformer")
inputs = tokenizer("Hello, my dog is cute.", return_tensors="pt").to(model.device)
input_ids = inputs["input_ids"]

model = FastSpeech2ConformerWithHifiGan.from_pretrained("espnet/fastspeech2_conformer_with_hifigan")
output_dict = model(input_ids, return_dict=True)
waveform = output_dict["waveform"]

sf.write("speech.wav", waveform.squeeze().detach().numpy(), samplerate=22050)- Bir pipeline ile çıkarım çalıştırın ve kullanılacak vokoderi belirtin
import soundfile as sf

from transformers import FastSpeech2ConformerHifiGan, pipeline


vocoder = FastSpeech2ConformerHifiGan.from_pretrained("espnet/fastspeech2_conformer_hifigan")
synthesiser = pipeline(model="espnet/fastspeech2_conformer", vocoder=vocoder)

speech = synthesiser("Hello, my dog is cooler than you!")

sf.write("speech.wav", speech["audio"].squeeze(), samplerate=speech["sampling_rate"])
FastSpeech2ConformerConfig
sınıf transformers.FastSpeech2ConformerConfig
< source >( transformers_version: str | None = Nonearchitectures: list[str] | None = Noneoutput_hidden_states: bool | None = Falsereturn_dict: bool | None = Truedtype: str | torch.dtype | None = Nonechunk_size_feed_forward: int = 0id2label: dict[int, str] | dict[str, str] | None = Nonelabel2id: dict[str, int] | dict[str, str] | None = Noneproblem_type: Literal['regression', 'single_label_classification', 'multi_label_classification'] | None = Noneis_encoder_decoder: bool = Truehidden_size: int = 384vocab_size: int = 78num_mel_bins: int = 80encoder_num_attention_heads: int = 2encoder_layers: int = 4encoder_linear_units: int = 1536decoder_layers: int = 4decoder_num_attention_heads: int = 2decoder_linear_units: int = 1536speech_decoder_postnet_layers: int = 5speech_decoder_postnet_units: int = 256speech_decoder_postnet_kernel: int = 5positionwise_conv_kernel_size: int = 3encoder_normalize_before: bool = Falsedecoder_normalize_before: bool = Falseencoder_concat_after: bool = Falsedecoder_concat_after: bool = Falsereduction_factor: int = 1speaking_speed: float = 1.0use_macaron_style_in_conformer: bool = Trueuse_cnn_in_conformer: bool = Trueencoder_kernel_size: int = 7decoder_kernel_size: int = 31duration_predictor_layers: int = 2duration_predictor_channels: int = 256duration_predictor_kernel_size: int = 3energy_predictor_layers: int = 2energy_predictor_channels: int = 256energy_predictor_kernel_size: int = 3energy_predictor_dropout: float | int = 0.5energy_embed_kernel_size: int = 1energy_embed_dropout: float | int = 0.0stop_gradient_from_energy_predictor: bool = Falsepitch_predictor_layers: int = 5pitch_predictor_channels: int = 256pitch_predictor_kernel_size: int = 5pitch_predictor_dropout: float | int = 0.5pitch_embed_kernel_size: int = 1pitch_embed_dropout: float | int = 0.0stop_gradient_from_pitch_predictor: bool = Trueencoder_dropout_rate: float | int = 0.2encoder_positional_dropout_rate: float | int = 0.2encoder_attention_dropout_rate: float | int = 0.2decoder_dropout_rate: float | int = 0.2decoder_positional_dropout_rate: float | int = 0.2decoder_attention_dropout_rate: float | int = 0.2duration_predictor_dropout_rate: float | int = 0.2speech_decoder_postnet_dropout: float | int = 0.5max_source_positions: int = 5000use_masking: bool = Trueuse_weighted_masking: bool = Falsenum_speakers: int | None = Nonenum_languages: int | None = Nonespeaker_embed_dim: int | None = Noneconvolution_bias: bool = True )
Parametreler
- is_encoder_decoder (
bool, isteğe bağlı, varsayılanTrue) — Modelin bir kodlayıcı/çözücü olarak kullanılıp kullanılmadığı. - hidden_size (
int, isteğe bağlı, varsayılan384) — Gizli temsillerin boyutu. - vocab_size (
int, isteğe bağlı, varsayılan78) — Modelin sözlük boyutu.input_idsile temsil edilebilecek farklı token sayısını belirler. - num_mel_bins (
int, isteğe bağlı, varsayılan80) — Giriş başına kullanılan mel özellik sayısı.AutoFeatureExtractorsınıfında kullanılan değerle eşleşmelidir. - encoder_num_attention_heads (
int, isteğe bağlı, varsayılan 2) — Encoder'daki dikkat başlarının sayısı. - encoder_layers (
int, isteğe bağlı, varsayılan4) — Transformer kodlayıcısındaki gizli katman sayısı. Ayarlanmazsanum_layersile aynı değeri kullanır. - encoder_linear_units (
int, isteğe bağlı, varsayılan 1536) — Encoder'ın doğrusal katmanındaki birim sayısı. - decoder_layers (
int, isteğe bağlı, varsayılan4) — Transformer decoder'ındaki gizli katman sayısı. Ayarlanmazsanum_layersile aynı değeri kullanır. - decoder_num_attention_heads (
int, isteğe bağlı, varsayılan2) — Transformer decoder'ındaki her dikkat katmanı için dikkat başı sayısı. - decoder_linear_units (
int, isteğe bağlı, varsayılan 1536) — Çözücüdeki doğrusal katmanın birim sayısı. - speech_decoder_postnet_layers (
int, isteğe bağlı, varsayılan 5) — Ses çözücüsünün post-net kısmındaki katman sayısı. - speech_decoder_postnet_units (
int, isteğe bağlı, varsayılan 256) — Ses çözücüsünün post-net katmanlarındaki birim sayısı. - speech_decoder_postnet_kernel (
int, isteğe bağlı, varsayılan 5) — Ses çözücüsünün post-net kısmındaki çekirdek boyutu. - positionwise_conv_kernel_size (
int, isteğe bağlı, varsayılan 3) — Konum bazlı katmanda kullanılan konvolüsyon çekirdeğinin boyutu. - encoder_normalize_before (
bool, isteğe bağlı, varsayılanFalse) — Encoder katmanlarından önce normalize edilecek olup olmadığını belirtir. - decoder_normalize_before (
bool, isteğe bağlı, varsayılanFalse) — Decoder katmanlarından önce normalize edilecek olup olmadığını belirtir. - encoder_concat_after (
bool, isteğe bağlı, varsayılanFalse) — Encoder katmanlarının ardından birleştirme yapılıp yapılmayacağını belirtir. - decoder_concat_after (
bool, isteğe bağlı, varsayılanFalse) — Decoder katmanlarının ardından birleştirme yapılıp yapılmayacağını belirtir. - reduction_factor (
int, isteğe bağlı, varsayılan 1) — Ses kare hızının azaltılma çarpanı. - speaking_speed (
float, isteğe bağlı, varsayılan 1.0) — Üretilen sesin hızı. - use_macaron_style_in_conformer (
bool, isteğe bağlı, varsayılanTrue) — Conformer'da macaron stilinin kullanılıp kullanılmayacağını belirtir. - use_cnn_in_conformer (
bool, isteğe bağlı, varsayılanTrue) — Conformer'da konvolüsyonel sinir ağlarının kullanılıp kullanılmayacağını belirtir. - encoder_kernel_size (
int, isteğe bağlı, varsayılan 7) — Kodlayıcıda kullanılan çekirdek boyutu. - decoder_kernel_size (
int, isteğe bağlı, varsayılan 31) — Çözücüde kullanılan çekirdek boyutu. - duration_predictor_layers (
int, isteğe bağlı, varsayılan 2) — Süre tahmincisinin katman sayısı. - duration_predictor_channels (
int, isteğe bağlı, varsayılan 256) — Süre tahmin edicisindeki kanal sayısı. - duration_predictor_kernel_size (
int, isteğe bağlı, varsayılan 3) — Süre tahmincisi (duration predictor) içinde kullanılan çekirdek boyutu. - energy_predictor_layers (
int, isteğe bağlı, varsayılan 2) — Enerji tahmincisinin katman sayısı. - energy_predictor_channels (
int, isteğe bağlı, varsayılan 256) — Enerji tahmin edicisindeki kanal sayısı. - energy_predictor_kernel_size (
int, isteğe bağlı, varsayılan 3) — Enerji tahmincisi (energy predictor) kullanılan çekirdek boyutu. - energy_predictor_dropout (
float, isteğe bağlı, varsayılan 0.5) — Enerji tahmincisinin dropout oranı. - energy_embed_kernel_size (
int, isteğe bağlı, varsayılan 1) — Energy embed katmanında kullanılan çekirdek boyutu. - energy_embed_dropout (
float, isteğe bağlı, varsayılan 0.0) — Energy embed katmanındaki dropout oranı. - stop_gradient_from_energy_predictor (
bool, isteğe bağlı, varsayılanFalse) — Enerji tahmincisinden gelen gradyanların durdurulup durdurulmayacağını belirtir. - pitch_predictor_layers (
int, isteğe bağlı, varsayılan 5) — Pitch predictor'daki katman sayısı. - pitch_predictor_channels (
int, isteğe bağlı, varsayılan 256) — Pitch predictor'daki kanal sayısı. - pitch_predictor_kernel_size (
int, isteğe bağlı, varsayılan 5) — Pitch predictor'da kullanılan çekirdek boyutu. - pitch_predictor_dropout (
float, isteğe bağlı, varsayılan 0.5) — Pitch predictor'daki dropout oranı. - pitch_embed_kernel_size (
int, isteğe bağlı, varsayılan 1) — Pitch embed katmanında kullanılan çekirdek boyutu. - pitch_embed_dropout (
float, isteğe bağlı, varsayılan 0.0) — Pitch embed katmanındaki dropout oranı. - stop_gradient_from_pitch_predictor (
bool, isteğe bağlı, varsayılanTrue) — Pitch predictor'den gelen gradyanların durdurulup durdurulmayacağını belirtir. - encoder_dropout_rate (
float, isteğe bağlı, varsayılan 0.2) — Encoder'daki dropout oranı. - encoder_positional_dropout_rate (
float, isteğe bağlı, varsayılan 0.2) — Encoder'daki konumsal dropout oranı. - encoder_attention_dropout_rate (
float, isteğe bağlı, varsayılan 0.2) — Encoder'daki dikkat dropout oranı. - decoder_dropout_rate (
float, isteğe bağlı, varsayılan 0.2) — Decoder'daki dropout oranı. - decoder_positional_dropout_rate (
float, isteğe bağlı, varsayılan 0.2) — Decoder'daki konumsal dropout oranı. - decoder_attention_dropout_rate (
float, isteğe bağlı, varsayılan 0.2) — Decoder'daki dikkat dropout oranı. - duration_predictor_dropout_rate (
float, isteğe bağlı, varsayılan 0.2) — Süre tahmincisindeki dropout oranı. - speech_decoder_postnet_dropout (
float, isteğe bağlı, varsayılan 0.5) — Ses çözücü postnet'indeki dropout oranı. - max_source_positions (
int, isteğe bağlı, varsayılan 5000) —"relative"konum gömme kullanılıyorsa, maksimum kaynak giriş konumlarını tanımlar. - use_masking (
bool, isteğe bağlı, varsayılanTrue) — Modelde maskelama kullanılıp kullanılmayacağını belirtir. - use_weighted_masking (
bool, isteğe bağlı, varsayılanFalse) — Modelde ağırlıklı maskelendirmenin kullanılıp kullanılmayacağını belirtir. - num_speakers (
int, isteğe bağlı) — Konuşmacı sayısı. > 1 olarak ayarlanırsa, konuşmacı kimliklerinin girdi olarak sağlanacağı varsayılır ve konuşmacı kimliği gömme katmanı kullanılır. - num_languages (
int, isteğe bağlı) — Dil sayısı. > 1 olarak ayarlanırsa, dil kimliklerinin girdi olarak sağlanacağı varsayılır ve dil kimliği gömme katmanı kullanılır. - speaker_embed_dim (
int, isteğe bağlı) — Konuşmacı gömme boyutu. > 0 olarak ayarlanırsa, speaker_embedding'in girdi olarak sağlanacağı varsayılır. - convolution_bias (
bool, isteğe bağlı, varsayılanTrue) — Conformer'ün konvolüsyon modülündeki konvolüsyonlarda sapma (bias) kullanılıp kullanılmayacağını belirtir.
Bu, bir FastSpeech2ConformerModel yapılandırmasını depolamak için kullanılan yapılandırma sınıfıdır. Belirtilen argümanlara göre bir Fastspeech2 Conformer modelinin örneklenmesinde, model mimarisini tanımlamak için kullanılır. Varsayılan değerlerle bir yapılandırma örneği oluşturmak, espnet/fastspeech2_conformer yapılandırmasına benzer bir yapılandırma elde edilmesini sağlar.
Yapılandırma nesneleri PreTrainedConfig sınıfından devralır ve model çıktılarını kontrol etmek için kullanılabilir. Daha fazla bilgi için PreTrainedConfig belgesini okuyun.
Örnek:
>>> from transformers import FastSpeech2ConformerModel, FastSpeech2ConformerConfig

>>> # Initializing a FastSpeech2Conformer style configuration
>>> configuration = FastSpeech2ConformerConfig()

>>> # Initializing a model from the FastSpeech2Conformer style configuration
>>> model = FastSpeech2ConformerModel(configuration)

>>> # Accessing the model configuration
>>> configuration = model.config
FastSpeech2ConformerHifiGanConfig
sınıf transformers.FastSpeech2ConformerHifiGanConfig
< source >( transformers_version: str | None = Nonearchitectures: list[str] | None = Noneoutput_hidden_states: bool | None = Falsereturn_dict: bool | None = Truedtype: str | torch.dtype | None = Nonechunk_size_feed_forward: int = 0is_encoder_decoder: bool = Falseid2label: dict[int, str] | dict[str, str] | None = Nonelabel2id: dict[str, int] | dict[str, str] | None = Noneproblem_type: Literal['regression', 'single_label_classification', 'multi_label_classification'] | None = Nonemodel_in_dim: int = 80upsample_initial_channel: int = 512upsample_rates: list[int] | tuple[int, ...] = (8, 8, 2, 2)upsample_kernel_sizes: list[int] | tuple[int, ...] = (16, 16, 4, 4)resblock_kernel_sizes: list[int] | tuple[int, ...] = (3, 7, 11)resblock_dilation_sizes: list | tuple | None = Noneinitializer_range: float = 0.01leaky_relu_slope: float = 0.1normalize_before: bool = True )
Parametreler
- model_in_dim (
int, isteğe bağlı, varsayılan 80) — Girdi log-mel spektrogramundaki frekans bini sayısı. - upsample_initial_channel (
int, isteğe bağlı, varsayılan 512) — Yukarı örnekleme ağına giren giriş kanalı sayısı. - upsample_rates (
tuple[int]veyalist[int], isteğe bağlı, varsayılan[8, 8, 2, 2]) — Yukarı örnekleme ağındaki her 1D konvolüsyonel katmanın stride değerini tanımlayan tamsayı bir demet. upsample_rates uzunluğu, konvolüsyonel katman sayısını belirler ve upsample_kernel_sizes uzunluğuyla eşleşmelidir. - upsample_kernel_sizes (
tuple[int]veyalist[int], isteğe bağlı, varsayılan[16, 16, 4, 4]) — Yukarı örneklemeli ağdaki her 1D konvolüsyon katmanının çekirdek boyutunu tanımlayan tamsayılar dizisi. upsample_kernel_sizes uzunluğu, konvolüsyon katmanlarının sayısını belirler ve upsample_rates uzunluğuyla eşleşmelidir. - resblock_kernel_sizes (
tuple[int]veyalist[int], isteğe bağlı, varsayılan[3, 7, 11]) — Çoklu algı alanı füzyonu (MRF) modülündeki 1D konvolüsyon katmanlarının çekirdek boyutlarını tanımlayan tamsayılar dizisi. - resblock_dilation_sizes (
tuple[tuple[int]]veyalist[list[int]], isteğe bağlı, varsayılan[[1, 3, 5], [1, 3, 5], [1, 3, 5]]) — Çoklu algı alanı füzyonu (MRF) modülündeki seyreltilmiş 1D konvolüsyonlu katmanların seyreltme oranlarını tanımlayan iç içe geçmiş tamsayı demeti. - initializer_range (
float, isteğe bağlı, varsayılan0.01) — Tüm ağırlık matrislerini başlatmak için kullanılan truncated_normal_initializer'ın standart sapması. - leaky_relu_slope (
float, isteğe bağlı, varsayılan 0.1) — Leaky ReLU aktivasyonunun kullandığı negatif eğimin açısı. - normalize_before (
bool, isteğe bağlı, varsayılanTrue) — Vokoderin öğrenilen ortalama ve varyans değerlerini kullanarak vokoding öncesinde spektrogramu normalize edip etmeyeceğini belirtir.
Bu, bir FastSpeech2ConformerModel yapılandırmasını depolamak için kullanılan yapılandırma sınıfıdır. Belirtilen argümanlara göre bir Fastspeech2 Conformer modelinin örneklenmesinde, model mimarisini tanımlamak için kullanılır. Varsayılan değerlerle bir yapılandırma örneklendiğinde, espnet/fastspeech2_conformer_with_hifigan ile benzer bir yapılandırma elde edilir.
Yapılandırma nesneleri PreTrainedConfig sınıfından devralır ve model çıktılarını kontrol etmek için kullanılabilir. Daha fazla bilgi için PreTrainedConfig belgesini okuyun.
Örnek:
>>> from transformers import FastSpeech2ConformerHifiGan, FastSpeech2ConformerHifiGanConfig

>>> # Initializing a FastSpeech2ConformerHifiGan configuration
>>> configuration = FastSpeech2ConformerHifiGanConfig()

>>> # Initializing a model (with random weights) from the configuration
>>> model = FastSpeech2ConformerHifiGan(configuration)

>>> # Accessing the model configuration
>>> configuration = model.config
FastSpeech2ConformerWithHifiGanConfig
sınıf transformers.FastSpeech2ConformerWithHifiGanConfig
< source >( transformers_version: str | None = Nonearchitectures: list[str] | None = Noneoutput_hidden_states: bool | None = Falsereturn_dict: bool | None = Truedtype: str | torch.dtype | None = Nonechunk_size_feed_forward: int = 0is_encoder_decoder: bool = Falseid2label: dict[int, str] | dict[str, str] | None = Nonelabel2id: dict[str, int] | dict[str, str] | None = Noneproblem_type: Literal['regression', 'single_label_classification', 'multi_label_classification'] | None = Nonemodel_config: dict | transformers.configuration_utils.PreTrainedConfig | None = Nonevocoder_config: dict | transformers.configuration_utils.PreTrainedConfig | None = None )
Bu, bir FastSpeech2ConformerModel yapılandırmasını depolamak için kullanılan yapılandırma sınıfıdır. Belirtilen argümanlara göre bir Fastspeech2 Conformer modelinin örneklenmesinde, model mimarisini tanımlamak için kullanılır. Varsayılan değerlerle bir yapılandırma örneklendiğinde, espnet/fastspeech2_conformer_with_hifigan ile benzer bir yapılandırma elde edilir.
Yapılandırma nesneleri PreTrainedConfig sınıfından devralır ve model çıktılarını kontrol etmek için kullanılabilir. Daha fazla bilgi için PreTrainedConfig belgesini okuyun.
Örnek:
>>> from transformers import (
...     FastSpeech2ConformerConfig,
...     FastSpeech2ConformerHifiGanConfig,
...     FastSpeech2ConformerWithHifiGanConfig,
...     FastSpeech2ConformerWithHifiGan,
... )

>>> # Initializing FastSpeech2ConformerWithHifiGan sub-modules configurations.
>>> model_config = FastSpeech2ConformerConfig()
>>> vocoder_config = FastSpeech2ConformerHifiGanConfig()

>>> # Initializing a FastSpeech2ConformerWithHifiGan module style configuration
>>> configuration = FastSpeech2ConformerWithHifiGanConfig(model_config.to_dict(), vocoder_config.to_dict())

>>> # Initializing a model (with random weights)
>>> model = FastSpeech2ConformerWithHifiGan(configuration)

>>> # Accessing the model configuration
>>> configuration = model.config
FastSpeech2ConformerTokenizer
sınıf transformers.FastSpeech2ConformerTokenizer
< source >( vocab_filebos_token = '<sos/eos>'eos_token = '<sos/eos>'pad_token = '<blank>'unk_token = '<unk>'should_strip_spaces = False**kwargs )
Parametreler
- vocab_file (
str) — Sözlük dosyasının yolu. - bos_token (
str, isteğe bağlı, varsayılan"<sos/eos>") — Dizinin başlangıç belirteci. Not: FastSpeech2 için bu,eos_tokenile aynıdır. - eos_token (
str, isteğe bağlı, varsayılan"<sos/eos>") — Dizi sonu belirteci. Not: FastSpeech2 için bu,bos_tokenile aynıdır. - pad_token (
str, isteğe bağlı, varsayılan"<blank>") — Doldurma için kullanılan token, örneğin farklı uzunluklardaki dizileri toplu işleme (batching) sırasında. - unk_token (
str, isteğe bağlı, varsayılan"<unk>") — Bilinmeyen token. Sözlükte yer almayan bir token, bir kimliğe dönüştürülemez ve bunun yerine bu token olarak ayarlanır. - should_strip_spaces (
bool, isteğe bağlı, varsayılanFalse) — Token listesinden boşlukların kaldırılıp kaldırılmayacağı.
FastSpeech2Conformer tokenizer'ı oluşturun.
__call__
< source >( text: TextInput | PreTokenizedInput | list[TextInput] | list[PreTokenizedInput] | None = Nonetext_pair: TextInput | PreTokenizedInput | list[TextInput] | list[PreTokenizedInput] | None = Nonetext_target: TextInput | PreTokenizedInput | list[TextInput] | list[PreTokenizedInput] | None = Nonetext_pair_target: TextInput | PreTokenizedInput | list[TextInput] | list[PreTokenizedInput] | None = Noneadd_special_tokens: bool = Truepadding: bool | str | PaddingStrategy = Falsetruncation: bool | str | TruncationStrategy | None = Nonemax_length: int | None = Nonestride: int = 0is_split_into_words: bool = Falsepad_to_multiple_of: int | None = Nonepadding_side: str | None = Nonereturn_tensors: str | TensorType | None = Nonereturn_token_type_ids: bool | None = Nonereturn_attention_mask: bool | None = Nonereturn_overflowing_tokens: bool = Falsereturn_special_tokens_mask: bool = Falsereturn_offsets_mapping: bool = Falsereturn_length: bool = Falseverbose: bool = Truetokenizer_kwargs: dict[str, Any] | None = None**kwargs ) → BatchEncoding
Parametreler
- text (
str,list[str],list[list[str]], isteğe bağlı) — Kodlanacak dizi veya dizi grubu. Her dizi bir metin veya metin listesi (önceden tokenize edilmiş metin) olabilir. Diziler metin listesi olarak (önceden tokenize edilmiş) sağlanıyorsa,is_split_into_words=Truedeğerini ayarlamalısınız (dizi grubu ile karışıklığı önlemek için). - text_pair (
str,list[str],list[list[str]], isteğe bağlı) — Kodlanacak dizi veya dizi grubu. Her dizi bir metin veya metin listesi (önceden tokenize edilmiş metin) olabilir. Diziler metin listesi olarak (önceden tokenize edilmiş) sağlanıyorsa,is_split_into_words=Truedeğerini ayarlamalısınız (dizi grubu ile belirsizliği gidermek için). - text_target (
str,list[str],list[list[str]], isteğe bağlı) — Hedef metin olarak kodlanacak dizi veya dizi grubu. Her dizi bir dize veya dize listesi (önceden tokenize edilmiş dize) olabilir. Diziler dize listesi (önceden tokenize edilmiş) olarak sağlanıyorsa,is_split_into_words=Truedeğerini ayarlamanız gerekir (dizi grubu ile belirsizliği gidermek için). - text_pair_target (
str,list[str],list[list[str]], isteğe bağlı) — Hedef metinler olarak kodlanacak dizi veya dizi partisi. Her dizi bir dize veya dize listesi (önceden tokenize edilmiş dize) olabilir. Diziler dize listesi (önceden tokenize edilmiş) olarak sağlanıyorsa,is_split_into_words=Truedeğerini ayarlamanız gerekir (dizi partisiyle olan belirsizliği gidermek için). - tokenizer_kwargs (
dict[str, Any], isteğe bağlı) — Tokenizöre iletilecek ek kwargs. Bunlar, açık parametreler ve diğer kwargs ile birleştirilir; açık parametreler önceliklidir. - add_special_tokens (
bool, isteğe bağlı, varsayılanTrue) — Dizileri kodlarken özel token eklenip eklenmeyeceğini belirtir. Bu, girdi kimliklerine otomatik olarak hangi tokenların ekleneceğini tanımlayan alttakiPretrainedTokenizerBase.build_inputs_with_special_tokensişlevini kullanır.bosveyaeostokenlarını otomatik olarak eklemek istiyorsanız bu işe yarar. - padding (
bool,strveya PaddingStrategy, isteğe bağlı, varsayılan olarakFalse) — Dolgu işlemini etkinleştirir ve kontrol eder. Aşağıdaki değerleri kabul eder:Trueveya'longest': Toplu işlemdeki en uzun dizinin uzunluğuna kadar dolgu yapılır (yalnızca tek bir dizi sağlanırsa dolgu yapılmaz).'max_length':max_lengthargümanı ile belirtilen maksimum uzunluğa veya bu argüman sağlanmadıysa modelin kabul edebileceği maksimum giriş uzunluğuna kadar doldurur.Falseveya'do_not_pad'(varsayılan): Dolgu yok (yani, farklı uzunluklarda diziler içeren bir parti çıktı olarak üretilebilir).
- truncation (
bool,strveya TruncationStrategy, isteğe bağlı, varsayılan olarakFalse) — Kesmeyi (truncation) etkinleştirir ve kontrol eder. Aşağıdaki değerleri kabul eder:Trueveya'longest_first':max_lengthargümanı ile belirtilen maksimum uzunluğa veya bu argüman sağlanmadıysa modelin kabul edebileceği maksimum giriş uzunluğuna kısaltılır. Bu işlem, token bazında kısaltma yapar; bir çift dizi (veya çift dizilerden oluşan bir batch) sağlandığında, çiftteki en uzun diziden bir token kaldırılır.'only_first':max_lengthargümanı ile belirtilen maksimum uzunluğa veya bu argüman sağlanmadıysa modelin kabul edebileceği maksimum giriş uzunluğuna kısaltır. Bir çift dizi (veya çiftlerin bir partisi) sağlandığında, yalnızca çiftin ilk dizisini kısaltır.'only_second':max_lengthargümanı ile belirtilen maksimum uzunluğa veya bu argüman sağlanmadıysa modelin kabul edebileceği maksimum girdi uzunluğuna kısaltılır. Bu, bir dizi çifti (veya çiftlerin bir partisi) sağlandığında yalnızca çiftin ikinci dizisini kısaltır.Falseveya'do_not_truncate'(varsayılan): Kesme yapılmaz (yani, modelin kabul edebileceği maksimum giriş boyutundan daha uzun dizi uzunluklarına sahip bir çıktı partisi üretilebilir).
- max_length (
int, isteğe bağlı) — Bir kesme/doldurma parametresi tarafından kullanılacak maksimum uzunluğu kontrol eder.Eğer ayarlanmazsa veya
Noneolarak ayarlanırsa, kırpma/dolgu parametrelerinden biri tarafından bir maksimum uzunluk gerekiyorsa, bu, önceden tanımlanmış modelin maksimum uzunluğunu kullanır. Modelin belirli bir maksimum giriş uzunluğu yoksa (XLNet gibi), maksimum uzunluğa kırpma/dolgu devre dışı bırakılır. - stride (
int, isteğe bağlı, varsayılan 0) —max_lengthile birlikte bir sayıya ayarlanırsa,return_overflowing_tokens=Trueolduğunda döndürülen taşan jetonlar, kısaltılmış ve taşan diziler arasında bazı örtüşme sağlamak için kısaltılmış dizinin sonundan bazı jetonları içerir. Bu argümanın değeri, örtüşen jeton sayısını tanımlar. - is_split_into_words (
bool, isteğe bağlı, varsayılanFalse) — Girdinin zaten önceden tokenize edilip edilmediğini (örneğin, kelimelere ayrılmış olup olmadığını) belirtir.Trueolarak ayarlanırsa, tokenizer, girdinin zaten kelimelere ayrılmış olduğunu (örneğin, boşluklara göre bölünerek) ve bunları tokenize edeceğini varsayar. Bu, NER veya token sınıflandırma için faydalıdır. - pad_to_multiple_of (
int, isteğe bağlı) — Belirlenirse, diziyi verilen değerin katına kadar doldurur. Bunun içinpaddingetkinleştirilmelidir. Bu, hesaplama yeteneği>= 7.5(Volta) olan NVIDIA donanımlarında Tensor Çekirdeklerinin kullanımını etkinleştirmek için özellikle faydalıdır. - padding_side (
str, isteğe bağlı) — Modelin padding uygulanması gereken tarafı. [‘right’, ‘left’] arasından seçilmelidir. Varsayılan değer, aynı ada sahip sınıf özelliğinden seçilir. - return_tensors (
strveya TensorType, isteğe bağlı) — Belirlenirse, Python tamsayı listesi yerine tensörler döndürülür. Kabul edilen değerler şunlardır:'pt': PyTorchtorch.Tensornesnelerini döndürür.'np': Numpynp.ndarraynesnelerini döndürür.
- return_token_type_ids (
bool, isteğe bağlı) — Token type ID'lerinin döndürülüp döndürülmeyeceğini belirtir. Varsayılan bırakılırsa, ilgili tokenizer'ın varsayılanına göre token type ID'lerini döndürür; bu,return_outputsözniteliği tarafından tanımlanır. - return_attention_mask (
bool, isteğe bağlı) — Dikkat maskesinin (attention mask) döndürülüp döndürülmeyeceğini belirtir. Varsayılan bırakılırsa, ilgili tokenizer'ın varsayılanına göre dikkat maskesini döndürür; bu,return_outputsözniteliği ile tanımlanır. - return_overflowing_tokens (
bool, isteğe bağlı, varsayılanFalse) — Taşan token dizilerinin döndürülüp döndürülmeyeceği. Girdi kimlikleri çiftlerinden (veya çiftlerden oluşan bir partiden)truncation_strategy = longest_firstveyaTrueile sağlanırsa, taşan tokenlar döndürülmek yerine bir hata oluşturulur. - return_special_tokens_mask (
bool, isteğe bağlı, varsayılanFalse) — Özel jeton maskesi bilgisinin döndürülüp döndürülmemesi. - return_offsets_mapping (
bool, isteğe bağlı, varsayılan olarakFalse) — Her token için(char_start, char_end)dönüp döndürmeyeceğini belirtir.Bu özellik yalnızca PreTrainedTokenizerFast sınıfından türeyen hızlı tokenizörlerde kullanılabilir; Python tokenizörü kullanılırsa bu yöntem
NotImplementedErrorhatası fırlatır. - return_length (
bool, isteğe bağlı, varsayılanFalse) — Kodlanmış girdilerin uzunluklarının döndürülüp döndürülmeyeceği. - verbose (
bool, isteğe bağlı, varsayılanTrue) — Daha fazla bilgi ve uyarı basılıp basılmayacağı. - **kwargs —
self.tokenize()yöntemine iletilir
Dönüş değeri
Aşağıdaki alanlara sahip bir BatchEncoding:
-
input_ids — Bir modele verilecek token kimliklerinin listesi.
-
token_type_ids — Bir modele verilecek token türü kimlikleri listesi (
return_token_type_ids=Trueolduğunda veya “token_type_ids”,self.model_input_namesiçinde olduğunda). -
attention_mask — Modelin hangi jetonlara dikkat etmesi gerektiğini belirleyen indeks listesi (
return_attention_mask=Trueolduğunda veyaself.model_input_namesiçinde “attention_mask” varsa). -
overflowing_tokens — Taşan token dizileri listesi (
max_lengthbelirtildiğinde vereturn_overflowing_tokens=Trueolduğunda). -
num_truncated_tokens — Kırpılan token sayısı (
max_lengthbelirtildiğinde vereturn_overflowing_tokens=Trueolduğunda). -
special_tokens_mask — 0 ve 1'lerden oluşan liste; 1 eklenen özel tokenları, 0 ise normal dizi tokenlarını belirtir (
add_special_tokens=Truevereturn_special_tokens_mask=Trueolduğunda). -
length — Girdilerin uzunluğu (
return_length=Trueolduğunda)
Bir veya birden fazla diziyi veya bir veya birden fazla dizi çiftini belirteçlere ayırmak ve model için hazırlamak için ana yöntem.
save_vocabulary
< source >( save_directory: strfilename_prefix: str | None = None ) → Tuple(str)
Sözlüğü ve özel jeton dosyasını bir dizine kaydedin.
batch_decode
< source >( sequences: list[int] | list[list[int]] | np.ndarray | torch.Tensorskip_special_tokens: bool = Falseclean_up_tokenization_spaces: bool | None = None**kwargs ) → list[str]
Parametreler
- sequences (
Union[list[int], list[list[int]], np.ndarray, torch.Tensor]) — Tokenize edilmiş girdi kimliklerinin listesi.__call__yöntemi kullanılarak elde edilebilir. - skip_special_tokens (
bool, isteğe bağlı, varsayılanFalse) — Çözümleme sırasında özel tokenların kaldırılıp kaldırılmayacağı. - clean_up_tokenization_spaces (
bool, isteğe bağlı) — Tokenizasyon boşluklarının temizlenip temizlenmeyeceğini belirtir.Noneise, varsayılan olarakself.clean_up_tokenization_spaceskullanılır. - kwargs (ek anahtar kelime argümanları, isteğe bağlı) — Altta yatan modele özgü decode yöntemine aktarılacaktır.
Dönüş değeri
list[str]
Çözümlenmiş cümlelerin listesi.
decode çağrısı yaparak token kimlikleri içeren listelerin listesini, dizelerin listesine dönüştürün.
Bu yöntem geriye dönük uyumluluk için sağlanmıştır. decode yöntemi artık toplu girdileri yerel olarak işler, bu nedenle batch_decode yerine doğrudan decode kullanabilirsiniz.
FastSpeech2ConformerModel
sınıf transformers.FastSpeech2ConformerModel
< source >( config: FastSpeech2ConformerConfig )
Parametreler
- config (FastSpeech2ConformerConfig) — Modelin tüm parametrelerini içeren model yapılandırma sınıfı. Bir yapılandırma dosyasıyla başlatmak, modelle ilişkili ağırlıkları yüklemez, yalnızca yapılandırmayı yükler. Model ağırlıklarını yüklemek için from_pretrained() yöntemine bakın.
FastSpeech2Conformer Modeli.
Bu model PreTrainedModel sınıfından devralır. Kütüphanenin tüm modelleri için uyguladığı genel yöntemler (indirme veya kaydetme, giriş gömme boyutlarını yeniden boyutlandırma, başları budama vb.) için üst sınıf belgelendirmesine bakın.
Bu model aynı zamanda bir PyTorch torch.nn.Module alt sınıfıdır. Bunu standart bir PyTorch Module olarak kullanın ve genel kullanım ve davranışla ilgili tüm konular için PyTorch dokümantasyonuna başvurun.
forward
< source >( input_ids: LongTensorattention_mask: typing.Optional[torch.LongTensor] = Nonespectrogram_labels: typing.Optional[torch.Tensor] = Noneduration_labels: typing.Optional[torch.LongTensor] = Nonepitch_labels: typing.Optional[torch.Tensor] = Noneenergy_labels: typing.Optional[torch.Tensor] = Nonespeaker_ids: typing.Optional[torch.LongTensor] = Nonelang_ids: typing.Optional[torch.LongTensor] = Nonespeaker_embedding: typing.Optional[torch.Tensor] = Nonereturn_dict: bool | None = Noneoutput_attentions: bool | None = Noneoutput_hidden_states: bool | None = None**kwargs ) → FastSpeech2ConformerModelOutput or tuple(torch.Tensor)
Parametreler
- input_ids (
torch.LongTensor, şekli(batch_size, sequence_length)) — Girdi metin vektörleri dizisi. - attention_mask (
torch.LongTensorşeklinde(batch_size, sequence_length), isteğe bağlı) — Doldurma (padding) token indekslerinde dikkat (attention) işlemi yapmaktan kaçınmak için kullanılan maske. Seçilen maske değerleri[0, 1]:- 1, maskelenmemiş jetonlar için,
- maskelenmiş jetonlar için 0.
- spectrogram_labels (
torch.Tensor, şekli(batch_size, max_spectrogram_length, num_mel_bins), isteğe bağlı, varsayılanNone) — Doldurulmuş hedef özellikler partisi. - duration_labels (
torch.LongTensor, şekli(batch_size, sequence_length + 1), isteğe bağlı, varsayılanNone) — Doldurulmuş sürelerin bir partisi. - pitch_labels (
torch.Tensor, şekli(batch_size, sequence_length + 1, 1), isteğe bağlı, varsayılanNone) — Dolgu yapılmış, token-ortalama pitch değerlerinden oluşan bir batch. - energy_labels (
torch.Tensor, şekli(batch_size, sequence_length + 1, 1), isteğe bağlı, varsayılanNone) — Dolgu yapılmış, token-ortalama enerji değerlerinin bir partisi. - speaker_ids (
torch.LongTensor, şekli(batch_size, 1), isteğe bağlı, varsayılanNone) — Modelin ses çıktısının özelliklerini koşullandırmak için kullanılan konuşmacı kimlikleri. - lang_ids (
torch.LongTensor, şekli(batch_size, 1), opsiyonel, varsayılanNone) — Modelin ses çıktısının özelliklerini koşullandırmak için kullanılan dil kimlikleri. - speaker_embedding (
torch.Tensor, şekli(batch_size, embedding_dim), isteğe bağlı, varsayılanNone) — Ses özellikleri için koşullama sinyalleri içeren gömme. - return_dict (
bool, isteğe bağlı) — Düz bir tuple yerine ModelOutput döndürülecek mi? - output_attentions (
bool, isteğe bağlı) — Tüm dikkat katmanlarının dikkat tensörlerinin döndürülüp döndürülmeyeceğini belirtir. Daha fazla ayrıntı için döndürülen tensörler altındakiattentionsbölümüne bakın. - output_hidden_states (
bool, isteğe bağlı) — Tüm katmanların gizli durumlarının (hidden states) döndürülüp döndürülmeyeceğini belirtir. Daha fazla ayrıntı için döndürülen tensörler altındakihidden_statesbölümüne bakın.
Dönüş değeri
FastSpeech2ConformerModelOutput veya tuple(torch.Tensor)
FastSpeech2ConformerModelOutput veya bir torch.Tensor demeti (eğer return_dict=False geçirildiyse veya config.return_dict=False ise), yapılandırmaya (FastSpeech2ConformerConfig) ve girdilere bağlı olarak çeşitli öğelerden oluşur.
FastSpeech2ConformerModel forward metodu, __call__ özel metodunu geçersiz kılar.
İleri geçiş tarifi bu fonksiyon içinde tanımlanmalı olsa da, sonrasında bunun yerine
Moduleörneğini çağırmak gerekir; çünkü önceki, ön ve son işleme adımlarını çalıştırmaktan sorumluyken ikincisi bunları sessizce yok sayar.
loss (
torch.Tensor, şekli(1,), isteğe bağlı,labelssağlandığında döndürülür) — Spektrogram üretme kaybı.spectrogram (
torch.Tensor, şekli(batch_size, sequence_length, num_bins), isteğe bağlı) — Tahmin edilen spektrogram.encoder_last_hidden_state (
torch.Tensor, şekli(batch_size, sequence_length, hidden_size), isteğe bağlı) — Modelin kodlayıcısının son katmanının çıktısındaki gizli durumlar dizisi.encoder_hidden_states (
tuple[torch.Tensor], isteğe bağlı,output_hidden_states=Truegeçirildiğinde veyaconfig.output_hidden_states=Trueolduğunda döndürülür) —torch.Tensor(modelin bir gömme katmanı varsa gömme katmanının çıktısı için bir tane + her katmanın çıktısı için birer tane) içeren,(batch_size, sequence_length, hidden_size)biçiminde bir demet.Her katmanın çıktısında ve başlangıç gömme çıktılarında kodlayıcının gizli durumları.
encoder_attentions (
tuple[torch.Tensor], isteğe bağlı,output_attentions=Truegeçirildiğinde veyaconfig.output_attentions=Trueolduğunda döndürülür) —torch.Tensor(katman başına bir tane) içeren bir tuple, şekli(batch_size, num_heads, sequence_length, sequence_length).Dikkat yumuşatma (attention softmax) sonrasında, öz-dikkat (self-attention) kafalarında ağırlıklı ortalamanın hesaplanmasında kullanılan kodlayıcının dikkat ağırlıkları.
decoder_hidden_states (
tuple[torch.Tensor], isteğe bağlı,output_hidden_states=Truegeçirildiğinde veyaconfig.output_hidden_states=Trueolduğunda döndürülür) —torch.Tensor(modelin bir gömme katmanı varsa gömme katmanının çıktısı için bir tane + her katmanın çıktısı için birer tane) içeren bir tuple, şekli(batch_size, sequence_length, hidden_size).Her katmanın çıktısında ve başlangıç gömme çıktılarında dekodlayıcının gizli durumları.
decoder_attentions (
tuple[torch.Tensor], isteğe bağlı,output_attentions=Truegeçirildiğinde veyaconfig.output_attentions=Trueolduğunda döndürülür) —torch.Tensor(katman başına bir tane) içeren bir tuple, şekli(batch_size, num_heads, sequence_length, sequence_length).Dikkat ağırlıkları, dikkat softmax'ından sonra, öz-dikkat kafalarında ağırlıklı ortalamanın hesaplanmasında kullanılan dekoderin
duration_outputs (
torch.LongTensor, şekli(batch_size, max_text_length + 1), opsiyonel) — Süre tahmincisinin çıktıları.pitch_outputs (
torch.Tensor, şekli(batch_size, max_text_length + 1, 1), isteğe bağlı) — Perde tahmincisinin çıktıları.energy_outputs (
torch.Tensor, şekli(batch_size, max_text_length + 1, 1), isteğe bağlı) — Enerji tahmincisinin çıktıları.
Örnek:
>>> from transformers import (
...     FastSpeech2ConformerTokenizer,
...     FastSpeech2ConformerModel,
...     FastSpeech2ConformerHifiGan,
... )

>>> tokenizer = FastSpeech2ConformerTokenizer.from_pretrained("espnet/fastspeech2_conformer")
>>> inputs = tokenizer("some text to convert to speech", return_tensors="pt")
>>> input_ids = inputs["input_ids"]

>>> model = FastSpeech2ConformerModel.from_pretrained("espnet/fastspeech2_conformer")
>>> output_dict = model(input_ids, return_dict=True)
>>> spectrogram = output_dict["spectrogram"]

>>> vocoder = FastSpeech2ConformerHifiGan.from_pretrained("espnet/fastspeech2_conformer_hifigan")
>>> waveform = vocoder(spectrogram)
>>> print(waveform.shape)
torch.Size([1, 49664])
FastSpeech2ConformerHifiGan
sınıf transformers.FastSpeech2ConformerHifiGan
< source >( config: FastSpeech2ConformerHifiGanConfig )
Parametreler
- config (FastSpeech2ConformerHifiGanConfig) — Modelin tüm parametrelerini içeren model yapılandırma sınıfı. Bir yapılandırma dosyasıyla başlatmak, modelle ilişkili ağırlıkları yüklemez, yalnızca yapılandırmayı yükler. Model ağırlıklarını yüklemek için from_pretrained() yöntemine bakın.
HiFi-GAN vokoderi.
Bu model PreTrainedModel sınıfından devralır. Kütüphanenin tüm modelleri için uyguladığı genel yöntemler (indirme veya kaydetme, giriş gömme boyutlarını yeniden boyutlandırma, başları budama vb.) için üst sınıf belgelendirmesine bakın.
Bu model aynı zamanda bir PyTorch torch.nn.Module alt sınıfıdır. Bunu standart bir PyTorch Module olarak kullanın ve genel kullanım ve davranışla ilgili tüm konular için PyTorch dokümantasyonuna başvurun.
forward
< source >( spectrogram: Tensor**kwargs ) → torch.Tensor
Parametreler
- spectrogram (
torch.Tensor) — Log-mel spektrogramları içeren tensör. Toplu (batched) olarak(batch_size, sequence_length, config.model_in_dim)biçiminde veya toplu olmayan (un-batched) olarak(sequence_length, config.model_in_dim)biçiminde olabilir.
Dönüş değeri
torch.Tensor
Ses dalgası formunu içeren tensör. Girdi spektrogramı toplu (batched) ise, şekli (batch_size, num_frames,) olacaktır. Toplu değilse, şekli (num_frames,) olacaktır.
Log-mel spektrogramunu konuşma dalgacığına dönüştürür. Bir log-mel spektrogramu partisi geçirildiğinde, bir konuşma dalgacığı partisi döndürülür. Tek bir, partilendirilmemiş log-mel spektrogramu geçirildiğinde, tek bir, partilendirilmemiş konuşma dalgacığı döndürülür.
FastSpeech2ConformerWithHifiGan
sınıf transformers.FastSpeech2ConformerWithHifiGan
< source >( config: FastSpeech2ConformerWithHifiGanConfig )
Parametreler
- config (FastSpeech2ConformerWithHifiGanConfig) — Modelin tüm parametrelerini içeren model yapılandırma sınıfı. Bir yapılandırma dosyasıyla başlatmak, modelle ilişkili ağırlıkları yüklemez, yalnızca yapılandırmayı yükler. Model ağırlıklarını yüklemek için from_pretrained() yöntemine bakın.
Bir FastSpeech2ConformerHifiGan vokoder başlığına sahip ve metinden sese (dalga formu) dönüştürme işlemini gerçekleştiren FastSpeech2ConformerModel.
Bu model PreTrainedModel sınıfından devralır. Kütüphanenin tüm modelleri için uyguladığı genel yöntemler (indirme veya kaydetme, giriş gömme boyutlarını yeniden boyutlandırma, başları budama vb.) için üst sınıf belgelendirmesine bakın.
Bu model aynı zamanda bir PyTorch torch.nn.Module alt sınıfıdır. Bunu standart bir PyTorch Module olarak kullanın ve genel kullanım ve davranışla ilgili tüm konular için PyTorch dokümantasyonuna başvurun.
forward
< source >( input_ids: LongTensorattention_mask: typing.Optional[torch.LongTensor] = Nonespectrogram_labels: typing.Optional[torch.Tensor] = Noneduration_labels: typing.Optional[torch.LongTensor] = Nonepitch_labels: typing.Optional[torch.Tensor] = Noneenergy_labels: typing.Optional[torch.Tensor] = Nonespeaker_ids: typing.Optional[torch.LongTensor] = Nonelang_ids: typing.Optional[torch.LongTensor] = Nonespeaker_embedding: typing.Optional[torch.Tensor] = Nonereturn_dict: bool | None = Noneoutput_attentions: bool | None = Noneoutput_hidden_states: bool | None = None**kwargs ) → FastSpeech2ConformerModelOutput or tuple(torch.Tensor)
Parametreler
- input_ids (
torch.LongTensor, şekli(batch_size, sequence_length)) — Girdi metin vektörleri dizisi. - attention_mask (
torch.LongTensorşeklinde(batch_size, sequence_length), isteğe bağlı) — Doldurma (padding) token indekslerinde dikkat (attention) işlemi yapmaktan kaçınmak için kullanılan maske. Seçilen maske değerleri[0, 1]:- 1, maskelenmemiş jetonlar için,
- maskelenmiş jetonlar için 0.
- spectrogram_labels (
torch.Tensor, şekli(batch_size, max_spectrogram_length, num_mel_bins), isteğe bağlı, varsayılanNone) — Doldurulmuş hedef özellikler partisi. - duration_labels (
torch.LongTensor, şekli(batch_size, sequence_length + 1), isteğe bağlı, varsayılanNone) — Doldurulmuş sürelerin bir partisi. - pitch_labels (
torch.Tensor, şekli(batch_size, sequence_length + 1, 1), isteğe bağlı, varsayılanNone) — Dolgu yapılmış, token-ortalama pitch değerlerinden oluşan bir batch. - energy_labels (
torch.Tensor, şekli(batch_size, sequence_length + 1, 1), isteğe bağlı, varsayılanNone) — Dolgu yapılmış, token-ortalama enerji değerlerinin bir partisi. - speaker_ids (
torch.LongTensor, şekli(batch_size, 1), isteğe bağlı, varsayılanNone) — Modelin ses çıktısının özelliklerini koşullandırmak için kullanılan konuşmacı kimlikleri. - lang_ids (
torch.LongTensor, şekli(batch_size, 1), opsiyonel, varsayılanNone) — Modelin ses çıktısının özelliklerini koşullandırmak için kullanılan dil kimlikleri. - speaker_embedding (
torch.Tensor, şekli(batch_size, embedding_dim), isteğe bağlı, varsayılanNone) — Ses özellikleri için koşullama sinyalleri içeren gömme. - return_dict (
bool, isteğe bağlı) — Düz bir tuple yerine ModelOutput döndürülecek mi? - output_attentions (
bool, isteğe bağlı) — Tüm dikkat katmanlarının dikkat tensörlerinin döndürülüp döndürülmeyeceğini belirtir. Daha fazla ayrıntı için döndürülen tensörler altındakiattentionsbölümüne bakın. - output_hidden_states (
bool, isteğe bağlı) — Tüm katmanların gizli durumlarının (hidden states) döndürülüp döndürülmeyeceğini belirtir. Daha fazla ayrıntı için döndürülen tensörler altındakihidden_statesbölümüne bakın.
Dönüş değeri
FastSpeech2ConformerModelOutput veya tuple(torch.Tensor)
FastSpeech2ConformerModelOutput veya bir torch.Tensor demeti (eğer return_dict=False geçirildiyse veya config.return_dict=False ise), yapılandırmaya (FastSpeech2ConformerConfig) ve girdilere bağlı olarak çeşitli öğelerden oluşur.
FastSpeech2ConformerWithHifiGan forward metodu, __call__ özel metodunu geçersiz kılar.
İleri geçiş tarifi bu fonksiyon içinde tanımlanmalı olsa da, sonrasında bunun yerine
Moduleörneğini çağırmak gerekir; çünkü önceki, ön ve son işleme adımlarını çalıştırmaktan sorumluyken ikincisi bunları sessizce yok sayar.
loss (
torch.Tensor, şekli(1,), isteğe bağlı,labelssağlandığında döndürülür) — Spektrogram üretme kaybı.spectrogram (
torch.Tensor, şekli(batch_size, sequence_length, num_bins), isteğe bağlı) — Tahmin edilen spektrogram.encoder_last_hidden_state (
torch.Tensor, şekli(batch_size, sequence_length, hidden_size), isteğe bağlı) — Modelin kodlayıcısının son katmanının çıktısındaki gizli durumlar dizisi.encoder_hidden_states (
tuple[torch.Tensor], isteğe bağlı,output_hidden_states=Truegeçirildiğinde veyaconfig.output_hidden_states=Trueolduğunda döndürülür) —torch.Tensor(modelin bir gömme katmanı varsa gömme katmanının çıktısı için bir tane + her katmanın çıktısı için birer tane) içeren,(batch_size, sequence_length, hidden_size)biçiminde bir demet.Her katmanın çıktısında ve başlangıç gömme çıktılarında kodlayıcının gizli durumları.
encoder_attentions (
tuple[torch.Tensor], isteğe bağlı,output_attentions=Truegeçirildiğinde veyaconfig.output_attentions=Trueolduğunda döndürülür) —torch.Tensor(katman başına bir tane) içeren bir tuple, şekli(batch_size, num_heads, sequence_length, sequence_length).Dikkat yumuşatma (attention softmax) sonrasında, öz-dikkat (self-attention) kafalarında ağırlıklı ortalamanın hesaplanmasında kullanılan kodlayıcının dikkat ağırlıkları.
decoder_hidden_states (
tuple[torch.Tensor], isteğe bağlı,output_hidden_states=Truegeçirildiğinde veyaconfig.output_hidden_states=Trueolduğunda döndürülür) —torch.Tensor(modelin bir gömme katmanı varsa gömme katmanının çıktısı için bir tane + her katmanın çıktısı için birer tane) içeren bir tuple, şekli(batch_size, sequence_length, hidden_size).Her katmanın çıktısında ve başlangıç gömme çıktılarında dekodlayıcının gizli durumları.
decoder_attentions (
tuple[torch.Tensor], isteğe bağlı,output_attentions=Truegeçirildiğinde veyaconfig.output_attentions=Trueolduğunda döndürülür) —torch.Tensor(katman başına bir tane) içeren bir tuple, şekli(batch_size, num_heads, sequence_length, sequence_length).Dikkat ağırlıkları, dikkat softmax'ından sonra, öz-dikkat kafalarında ağırlıklı ortalamanın hesaplanmasında kullanılan dekoderin
duration_outputs (
torch.LongTensor, şekli(batch_size, max_text_length + 1), opsiyonel) — Süre tahmincisinin çıktıları.pitch_outputs (
torch.Tensor, şekli(batch_size, max_text_length + 1, 1), isteğe bağlı) — Perde tahmincisinin çıktıları.energy_outputs (
torch.Tensor, şekli(batch_size, max_text_length + 1, 1), isteğe bağlı) — Enerji tahmincisinin çıktıları.
Örnek:
>>> from transformers import (
...     FastSpeech2ConformerTokenizer,
...     FastSpeech2ConformerWithHifiGan,
... )

>>> tokenizer = FastSpeech2ConformerTokenizer.from_pretrained("espnet/fastspeech2_conformer")
>>> inputs = tokenizer("some text to convert to speech", return_tensors="pt")
>>> input_ids = inputs["input_ids"]

>>> model = FastSpeech2ConformerWithHifiGan.from_pretrained("espnet/fastspeech2_conformer_with_hifigan")
>>> output_dict = model(input_ids, return_dict=True)
>>> waveform = output_dict["waveform"]
>>> print(waveform.shape)
torch.Size([1, 49664])