
Diffusers documentation
OmniGen
OmniGen
OmniGen: Unified Image Generation от BAAI, авторы: Shitao Xiao, Yueze Wang, Junjie Zhou, Huaying Yuan, Xingrun Xing, Ruiran Yan, Chaofan Li, Shuting Wang, Tiejun Huang, Zheng Liu.
Аннотация из статьи:
Появление больших языковых моделей (LLM) унифицировало задачи генерации текста и революционизировало взаимодействие человека с машиной. Однако в области генерации изображений единая модель, способная выполнять различные задачи в рамках одной архитектуры, по-прежнему остаётся малоизученной. В данной работе мы представляем OmniGen — новую диффузионную модель для унифицированной генерации изображений. OmniGen характеризуется следующими особенностями: 1) Унификация: OmniGen не только демонстрирует возможности генерации изображений по тексту, но и изначально поддерживает различные задачи нижнего уровня, такие как редактирование изображений, генерация по заданному объекту и условная генерация по визуальному условию. 2) Простота: Архитектура OmniGen значительно упрощена, что исключает необходимость в дополнительных плагинах. Кроме того, по сравнению с существующими диффузионными моделями, она более удобна для пользователя и может выполнять сложные задачи от начала до конца по инструкциям без необходимости дополнительных промежуточных шагов, что значительно упрощает рабочий процесс генерации изображений. 3) Перенос знаний: Благодаря обучению в унифицированном формате OmniGen эффективно переносит знания между различными задачами, справляется с невиданными ранее задачами и доменами и демонстрирует новые возможности. Мы также исследуем способности модели к рассуждениям и потенциальные применения механизма цепочки рассуждений (chain-of-thought). Данная работа представляет собой первую попытку создания универсальной модели генерации изображений, и мы опубликуем наши ресурсы по адресу https://github.com/VectorSpaceLab/OmniGen, чтобы содействовать будущему развитию в этой области.
Обязательно ознакомьтесь с руководством по планировщикам, чтобы узнать, как исследовать баланс между скоростью и качеством планировщика, а также с разделом повторное использование компонентов в разных конвейерах, чтобы узнать, как эффективно загружать одни и те же компоненты в несколько конвейеров.
Этот конвейер был предложен пользователем staoxiao. Исходная кодовая база доступна здесь. Исходные веса можно найти по адресу hf.co/shitao.
Загрузка контрольных точек модели
Веса модели могут храниться в отдельных подпапках на Hub или локально, в этом случае следует использовать метод from_pretrained().
import torch
from diffusers import OmniGenPipeline

pipe = OmniGenPipeline.from_pretrained("Shitao/OmniGen-v1-diffusers", dtype=torch.bfloat16)
Текст в изображение
Для генерации изображений по тексту передайте текстовый запрос. По умолчанию OmniGen создаёт изображение размером 1024x1024.
Вы можете задать параметры height и width, чтобы генерировать изображения другого размера.
import torch
from diffusers import OmniGenPipeline

pipe = OmniGenPipeline.from_pretrained(
    "Shitao/OmniGen-v1-diffusers",
    dtype=torch.bfloat16
)
pipe.to("cuda")  # or "mps", "xpu", "cpu"

prompt = "Realistic photo. A young woman sits on a sofa, holding a book and facing the camera. She wears delicate silver hoop earrings adorned with tiny, sparkling diamonds that catch the light, with her long chestnut hair cascading over her shoulders. Her eyes are focused and gentle, framed by long, dark lashes. She is dressed in a cozy cream sweater, which complements her warm, inviting smile. Behind her, there is a table with a cup of water in a sleek, minimalist blue mug. The background is a serene indoor setting with soft natural light filtering through a window, adorned with tasteful art and flowers, creating a cozy and peaceful ambiance. 4K, HD."
image = pipe(
    prompt=prompt,
    height=1024,
    width=1024,
    guidance_scale=3,
    generator=torch.Generator(device="cpu").manual_seed(111),
).images[0]
image.save("output.png")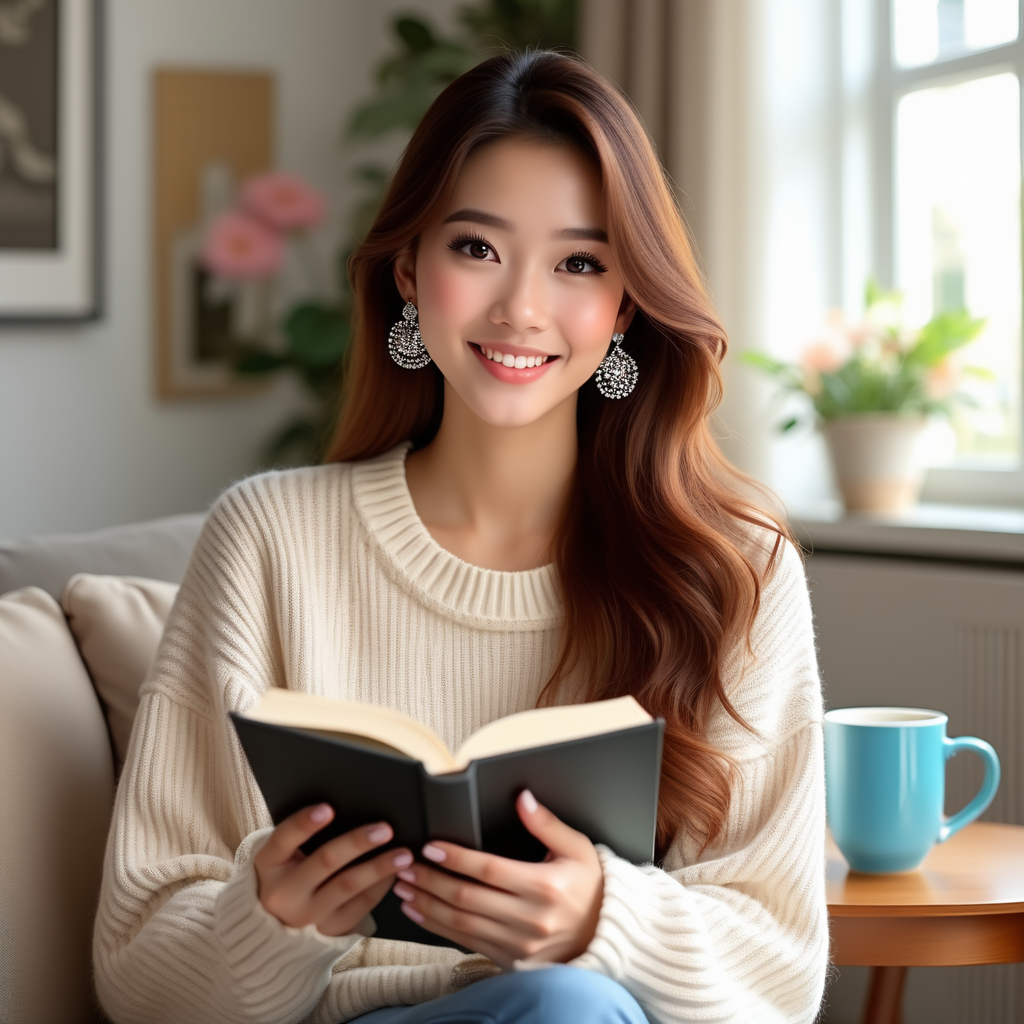
Редактирование изображений
OmniGen поддерживает мультимодальные входные данные.
Если вход включает изображение, необходимо добавить в текстовый промпт плейсхолдер <img><|image_1|></img> для представления изображения.
Рекомендуется включить use_input_image_size_as_output, чтобы отредактированное изображение сохраняло тот же размер, что и исходное.
import torch
from diffusers import OmniGenPipeline
from diffusers.utils import load_image

pipe = OmniGenPipeline.from_pretrained(
    "Shitao/OmniGen-v1-diffusers",
    dtype=torch.bfloat16
)
pipe.to("cuda")  # or "mps", "xpu", "cpu"

prompt="<img><|image_1|></img> Remove the woman's earrings. Replace the mug with a clear glass filled with sparkling iced cola."
input_images=[load_image("https://raw.githubusercontent.com/VectorSpaceLab/OmniGen/main/imgs/docs_img/t2i_woman_with_book.png")]
image = pipe(
    prompt=prompt,
    input_images=input_images,
    guidance_scale=2,
    img_guidance_scale=1.6,
    use_input_image_size_as_output=True,
    generator=torch.Generator(device="cpu").manual_seed(222)
).images[0]
image.save("output.png") 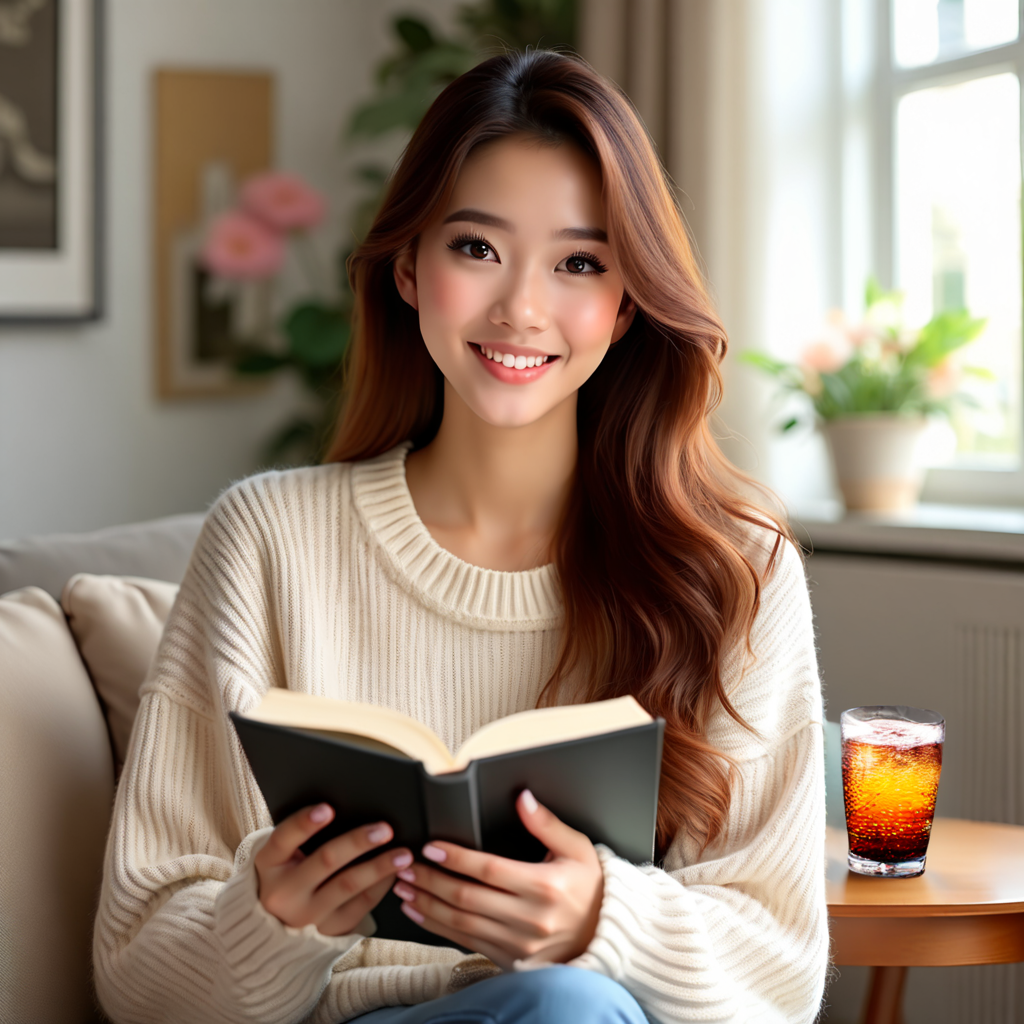
OmniGen обладает рядом интересных функций, таких как визуальное рассуждение, как показано в примере ниже.
prompt="If the woman is thirsty, what should she take? Find it in the image and highlight it in blue. <img><|image_1|></img>"
input_images=[load_image("https://raw.githubusercontent.com/VectorSpaceLab/OmniGen/main/imgs/docs_img/edit.png")]
image = pipe(
    prompt=prompt,
    input_images=input_images,
    guidance_scale=2,
    img_guidance_scale=1.6,
    use_input_image_size_as_output=True,
    generator=torch.Generator(device="cpu").manual_seed(0)
).images[0]
image.save("output.png")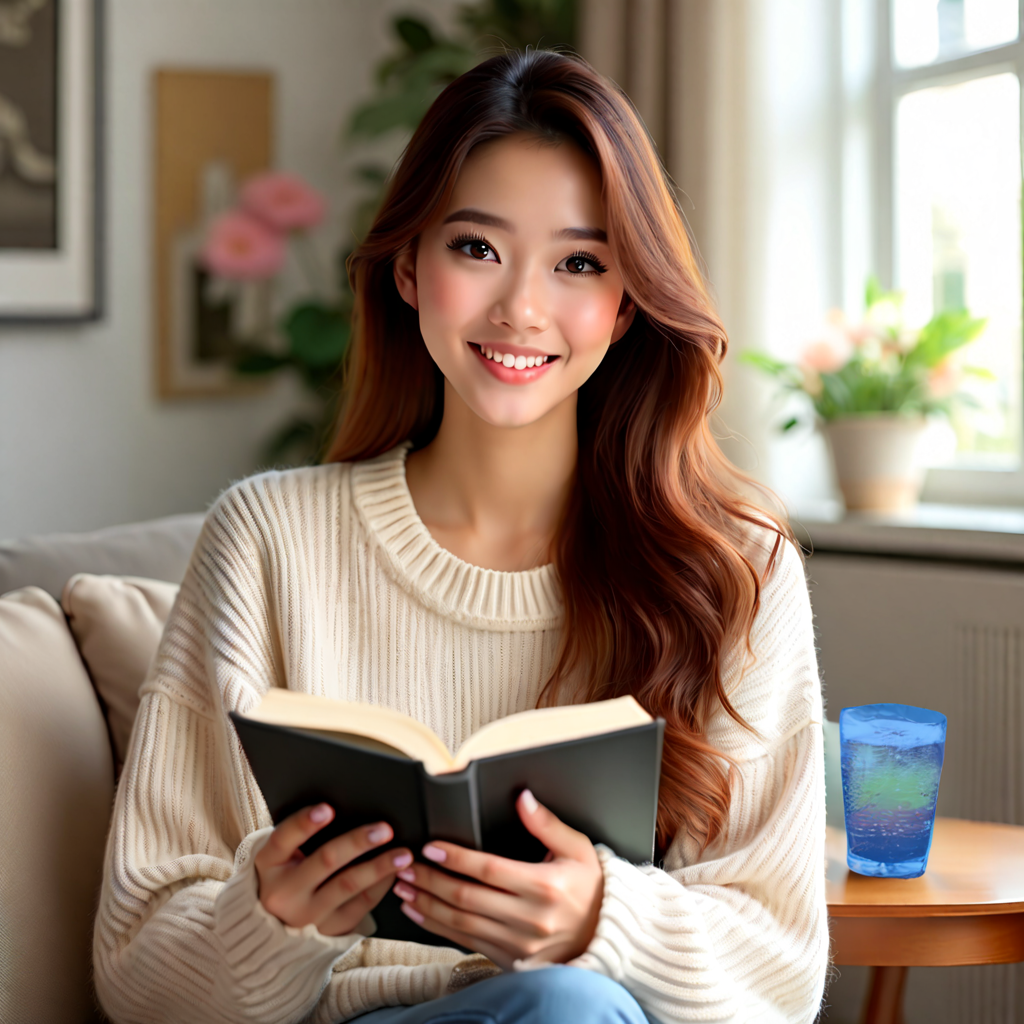
Управляемая генерация
OmniGen способен решать несколько классических задач компьютерного зрения. Как показано ниже, OmniGen может обнаруживать скелеты людей на входных изображениях, что позволяет использовать их в качестве управляющих условий для генерации новых изображений.
import torch
from diffusers import OmniGenPipeline
from diffusers.utils import load_image

pipe = OmniGenPipeline.from_pretrained(
    "Shitao/OmniGen-v1-diffusers",
    dtype=torch.bfloat16
)
pipe.to("cuda")  # or "mps", "xpu", "cpu"

prompt="Detect the skeleton of human in this image: <img><|image_1|></img>"
input_images=[load_image("https://raw.githubusercontent.com/VectorSpaceLab/OmniGen/main/imgs/docs_img/edit.png")]
image1 = pipe(
    prompt=prompt,
    input_images=input_images,
    guidance_scale=2,
    img_guidance_scale=1.6,
    use_input_image_size_as_output=True,
    generator=torch.Generator(device="cpu").manual_seed(333)
).images[0]
image1.save("image1.png")

prompt="Generate a new photo using the following picture and text as conditions: <img><|image_1|></img>\n A young boy is sitting on a sofa in the library, holding a book. His hair is neatly combed, and a faint smile plays on his lips, with a few freckles scattered across his cheeks. The library is quiet, with rows of shelves filled with books stretching out behind him."
input_images=[load_image("https://raw.githubusercontent.com/VectorSpaceLab/OmniGen/main/imgs/docs_img/skeletal.png")]
image2 = pipe(
    prompt=prompt,
    input_images=input_images,
    guidance_scale=2,
    img_guidance_scale=1.6,
    use_input_image_size_as_output=True,
    generator=torch.Generator(device="cpu").manual_seed(333)
).images[0]
image2.save("image2.png") 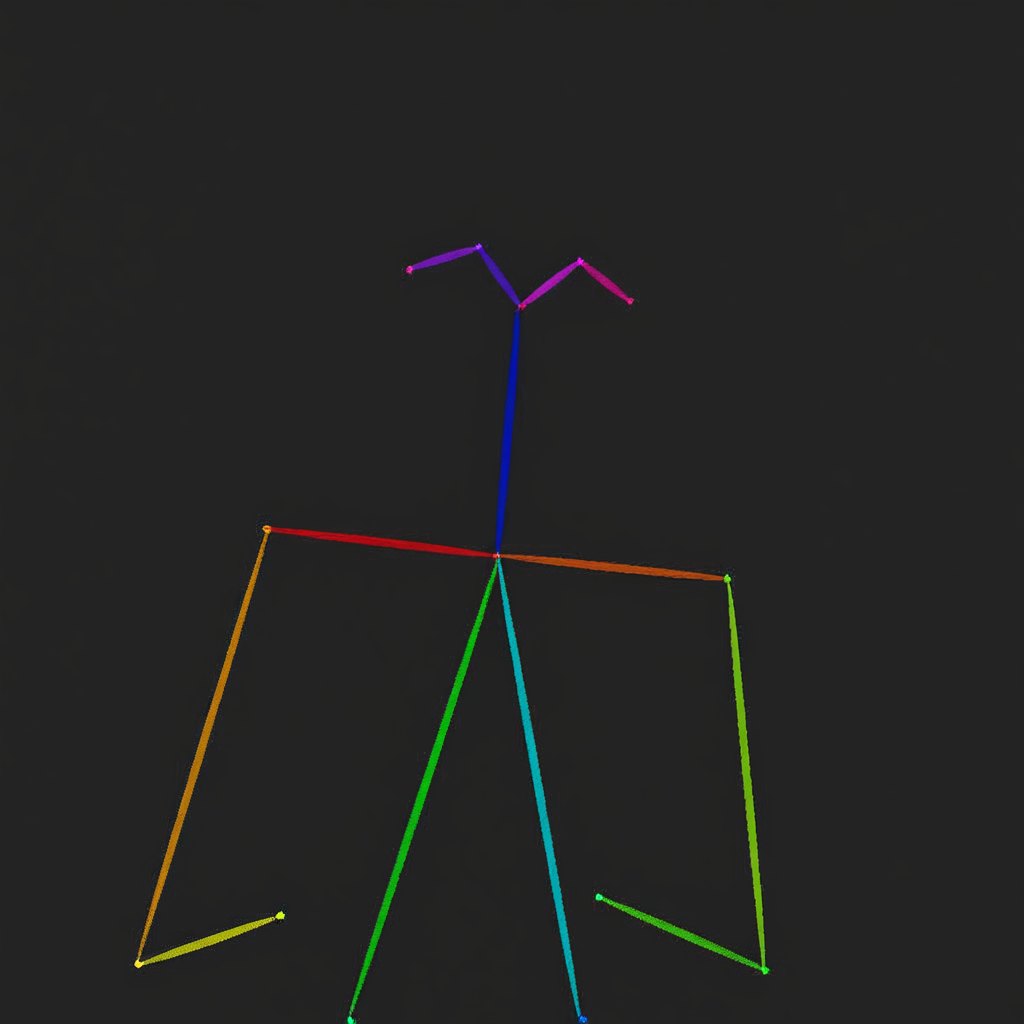
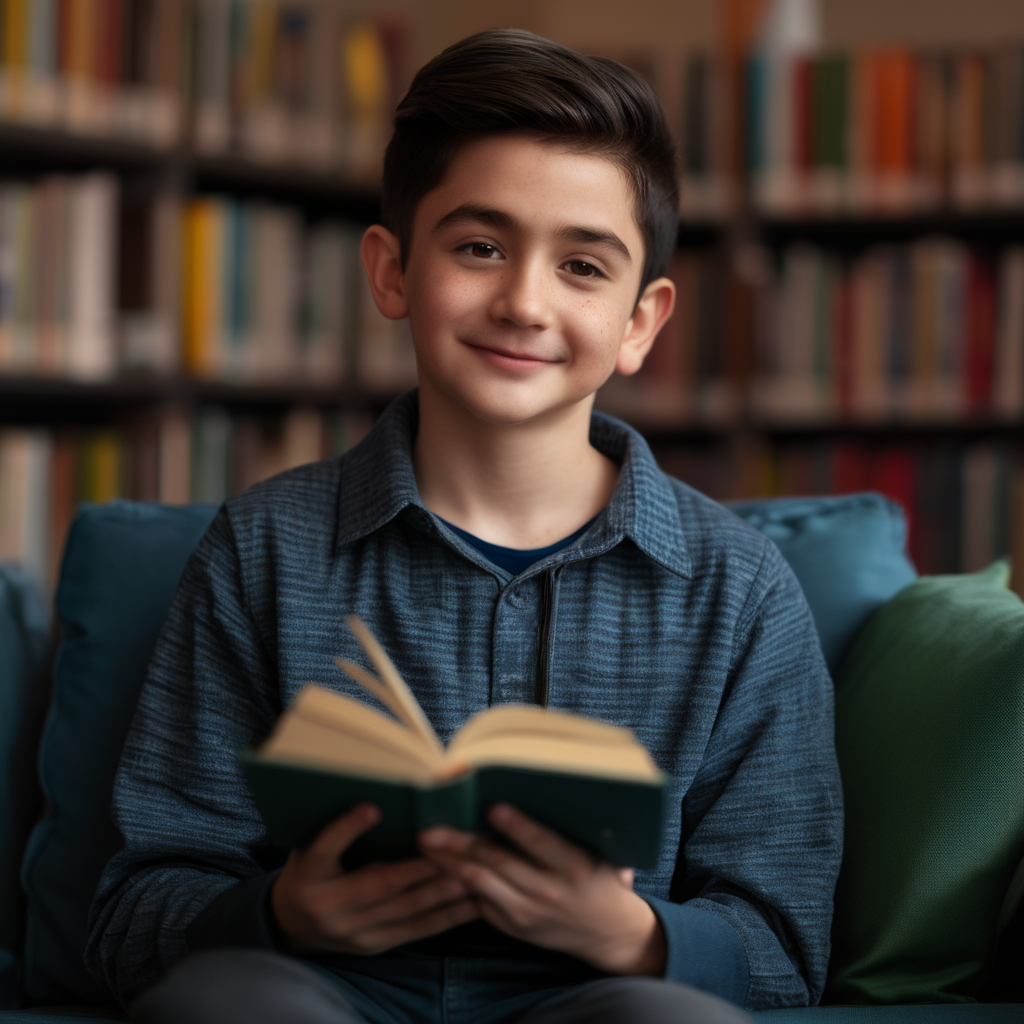
OmniGen также может напрямую использовать релевантную информацию из входных изображений для генерации новых.
import torch
from diffusers import OmniGenPipeline
from diffusers.utils import load_image

pipe = OmniGenPipeline.from_pretrained(
    "Shitao/OmniGen-v1-diffusers",
    dtype=torch.bfloat16
)
pipe.to("cuda")  # or "mps", "xpu", "cpu"

prompt="Following the pose of this image <img><|image_1|></img>, generate a new photo: A young boy is sitting on a sofa in the library, holding a book. His hair is neatly combed, and a faint smile plays on his lips, with a few freckles scattered across his cheeks. The library is quiet, with rows of shelves filled with books stretching out behind him."
input_images=[load_image("https://raw.githubusercontent.com/VectorSpaceLab/OmniGen/main/imgs/docs_img/edit.png")]
image = pipe(
    prompt=prompt,
    input_images=input_images,
    guidance_scale=2,
    img_guidance_scale=1.6,
    use_input_image_size_as_output=True,
    generator=torch.Generator(device="cpu").manual_seed(0)
).images[0]
image.save("output.png")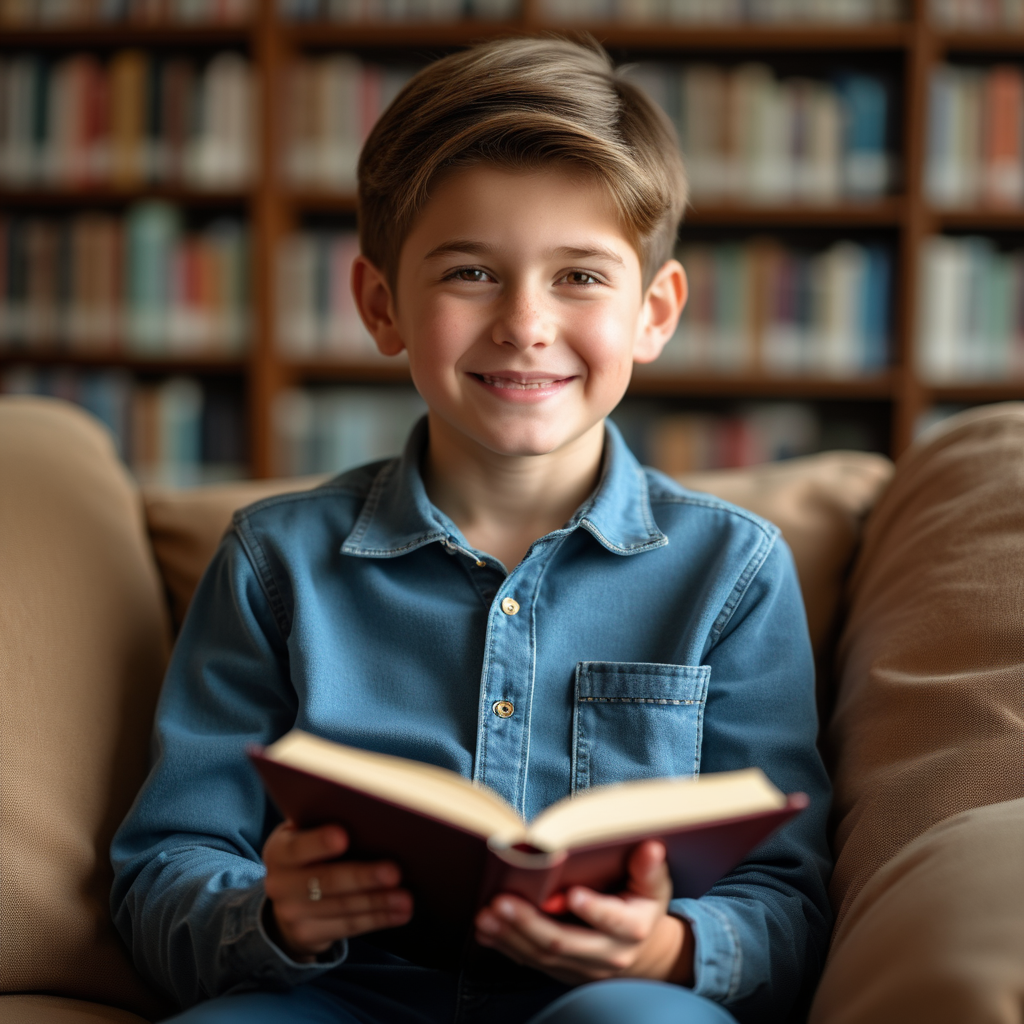
Сохранение идентификаторов и объектов
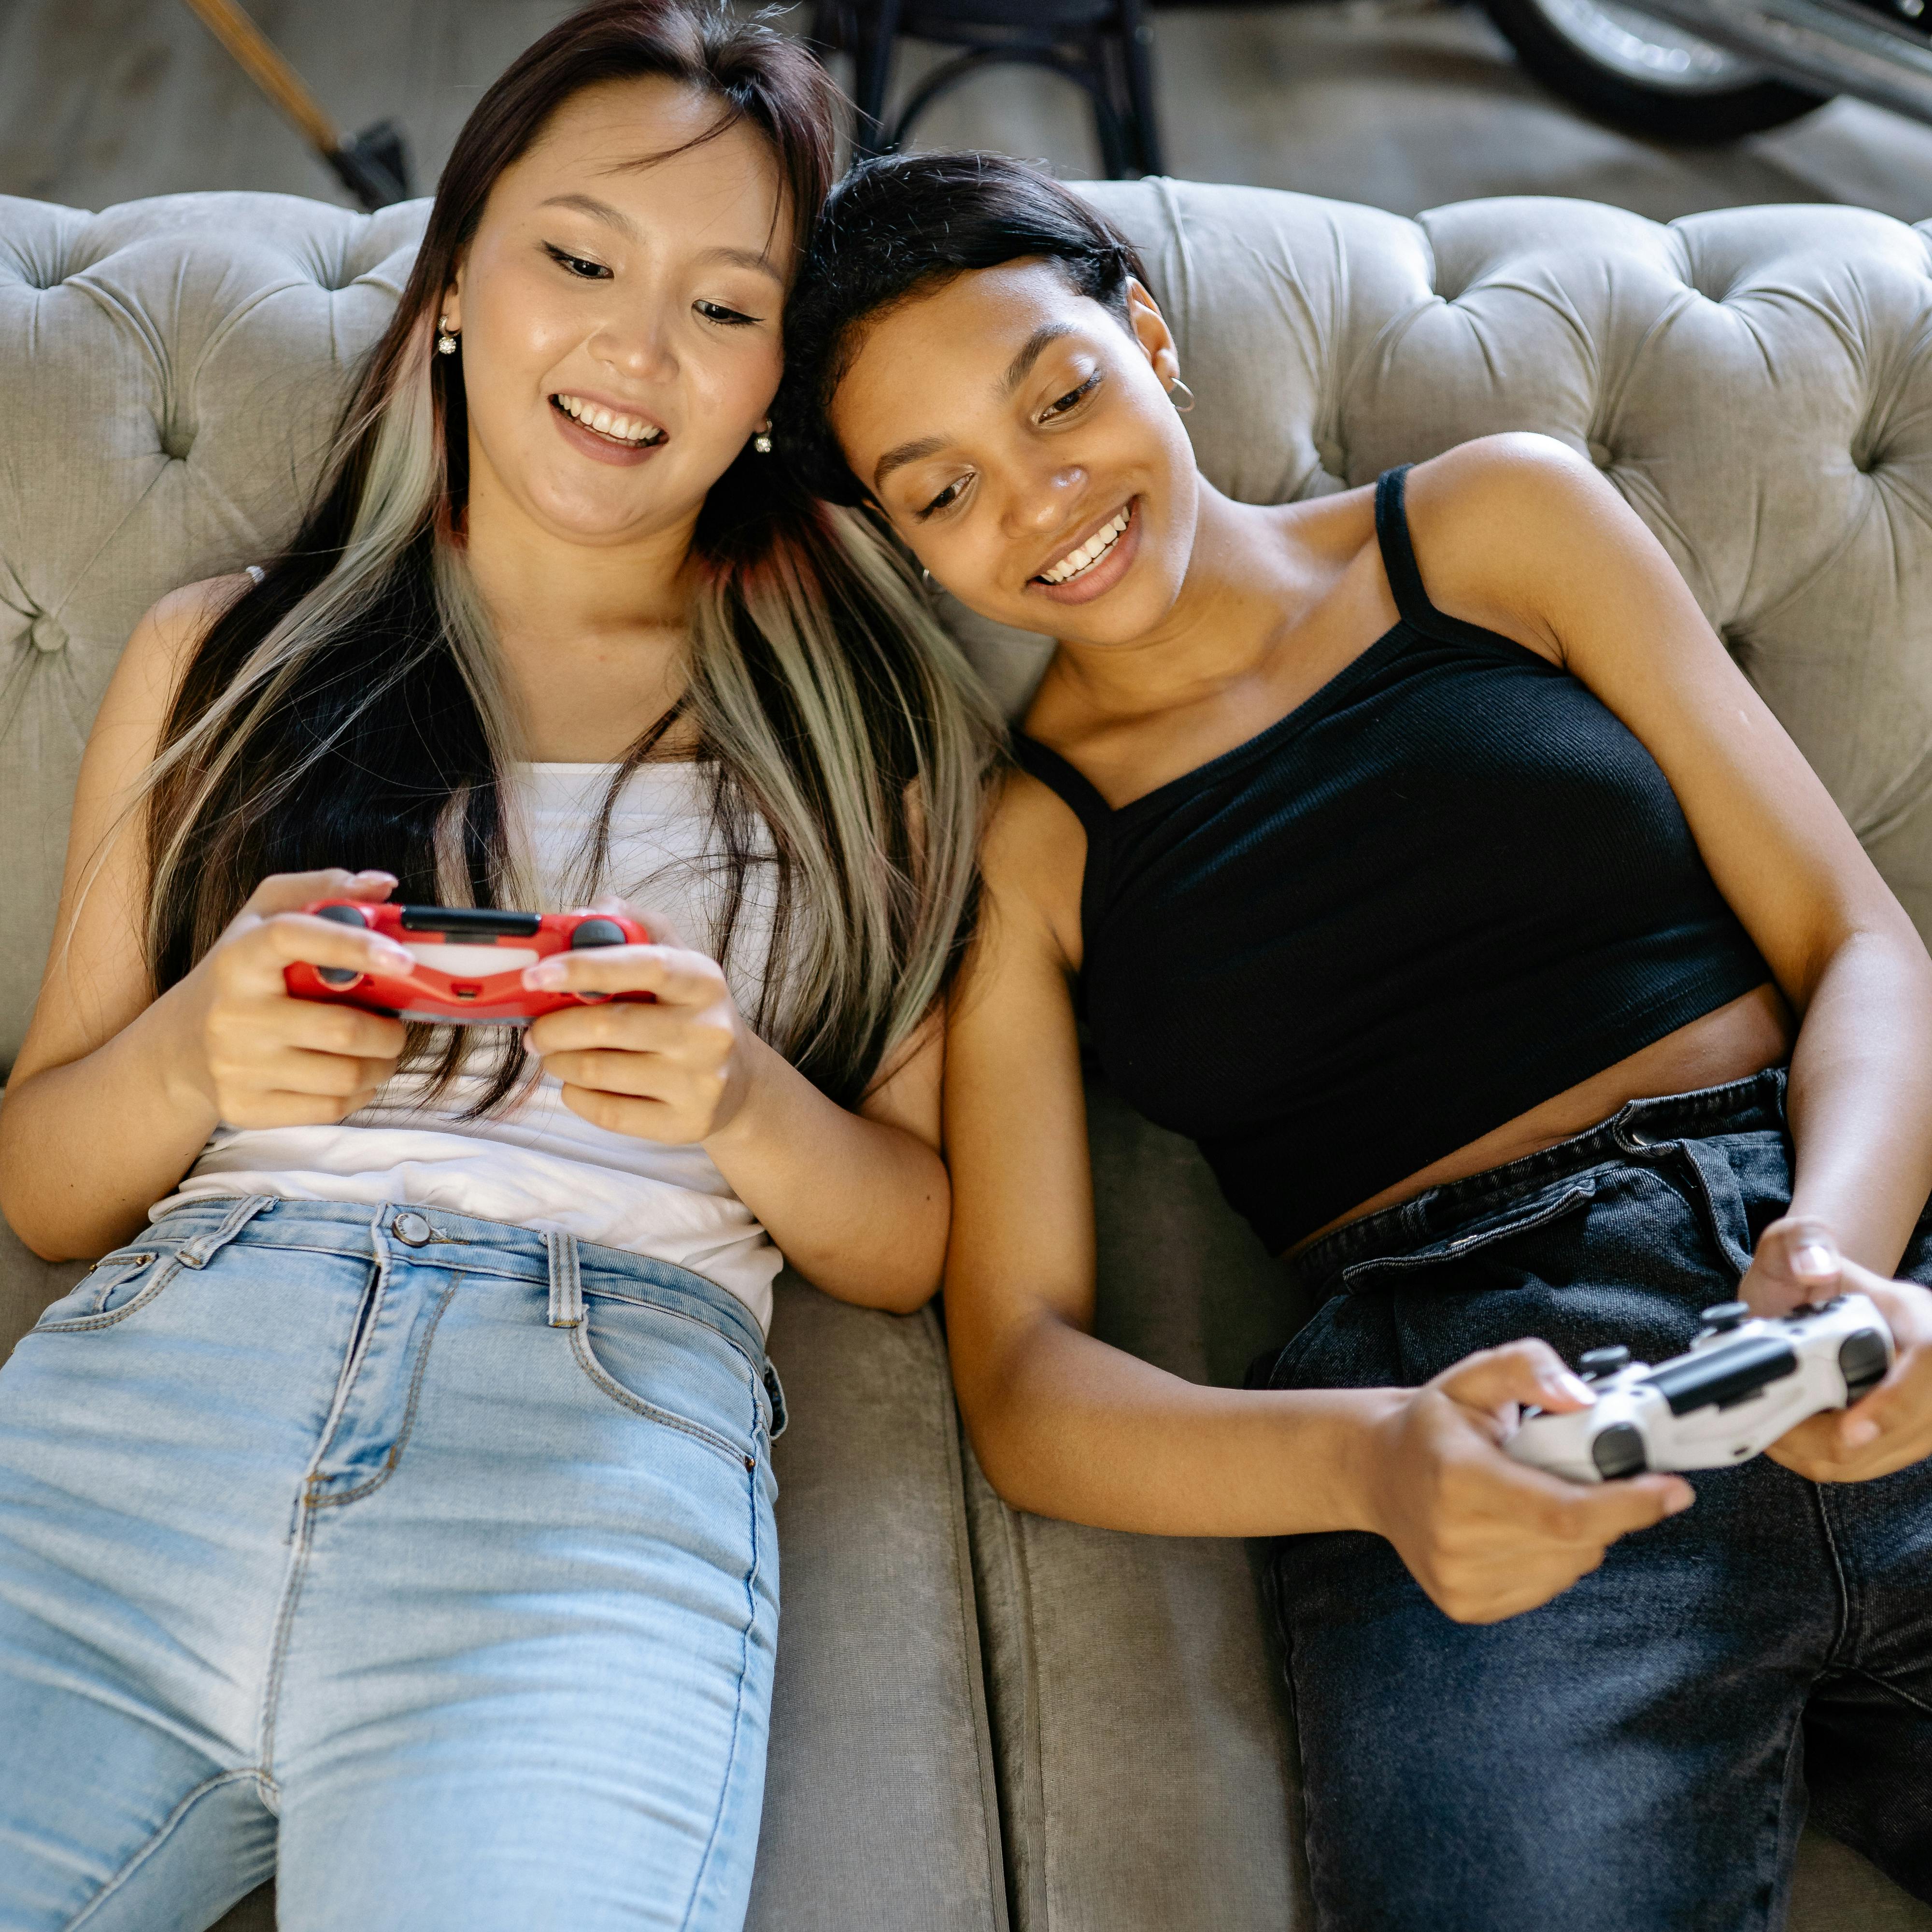
OmniGen может генерировать несколько изображений на основе людей и объектов на входном изображении и поддерживает одновременный ввод нескольких изображений. Кроме того, OmniGen может извлекать нужные объекты из изображения, содержащего несколько объектов, на основе инструкций.
import torch
from diffusers import OmniGenPipeline
from diffusers.utils import load_image

pipe = OmniGenPipeline.from_pretrained(
    "Shitao/OmniGen-v1-diffusers",
    dtype=torch.bfloat16
)
pipe.to("cuda")  # or "mps", "xpu", "cpu"

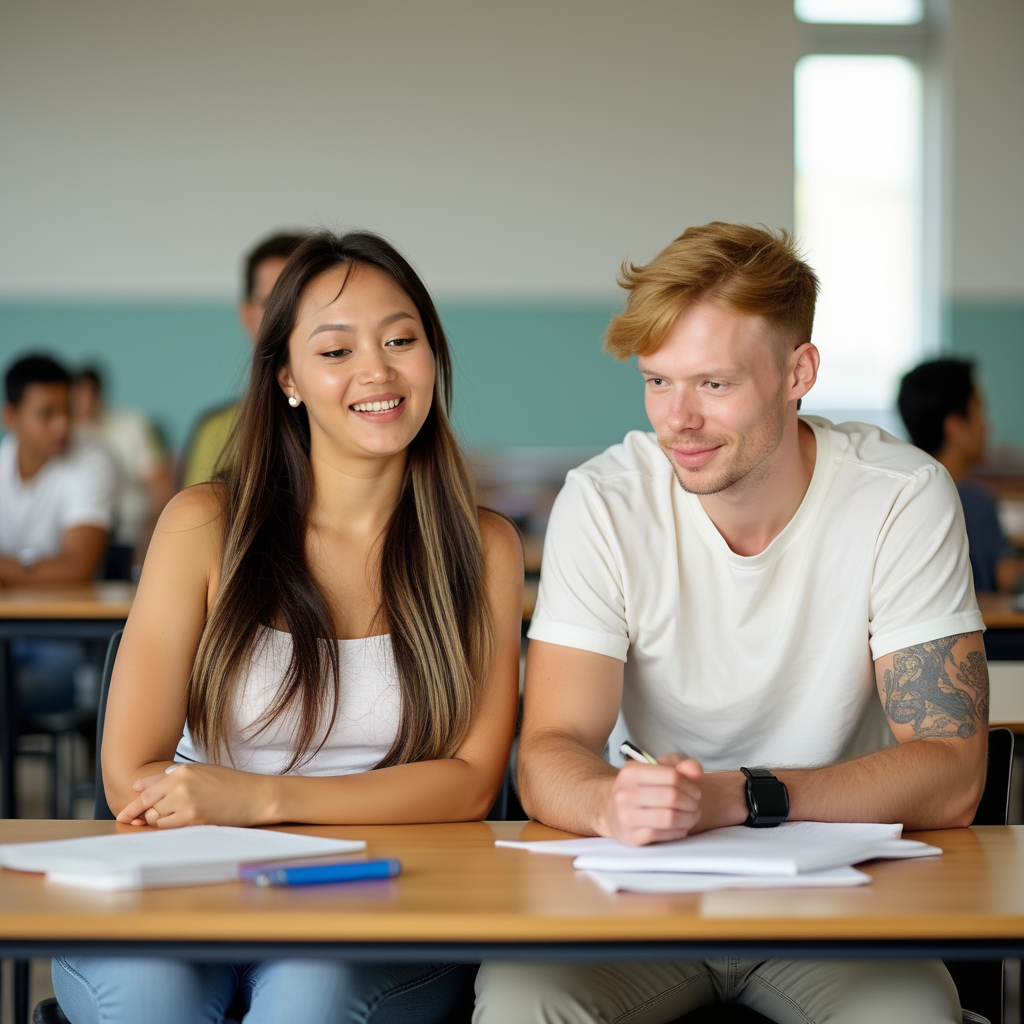
prompt="A man and a woman are sitting at a classroom desk. The man is the man with yellow hair in <img><|image_1|></img>. The woman is the woman on the left of <img><|image_2|></img>"
input_image_1 = load_image("https://raw.githubusercontent.com/VectorSpaceLab/OmniGen/main/imgs/docs_img/3.png")
input_image_2 = load_image("https://raw.githubusercontent.com/VectorSpaceLab/OmniGen/main/imgs/docs_img/4.png")
input_images=[input_image_1, input_image_2]
image = pipe(
    prompt=prompt,
    input_images=input_images,
    height=1024,
    width=1024,
    guidance_scale=2.5,
    img_guidance_scale=1.6,
    generator=torch.Generator(device="cpu").manual_seed(666)
).images[0]
image.save("output.png")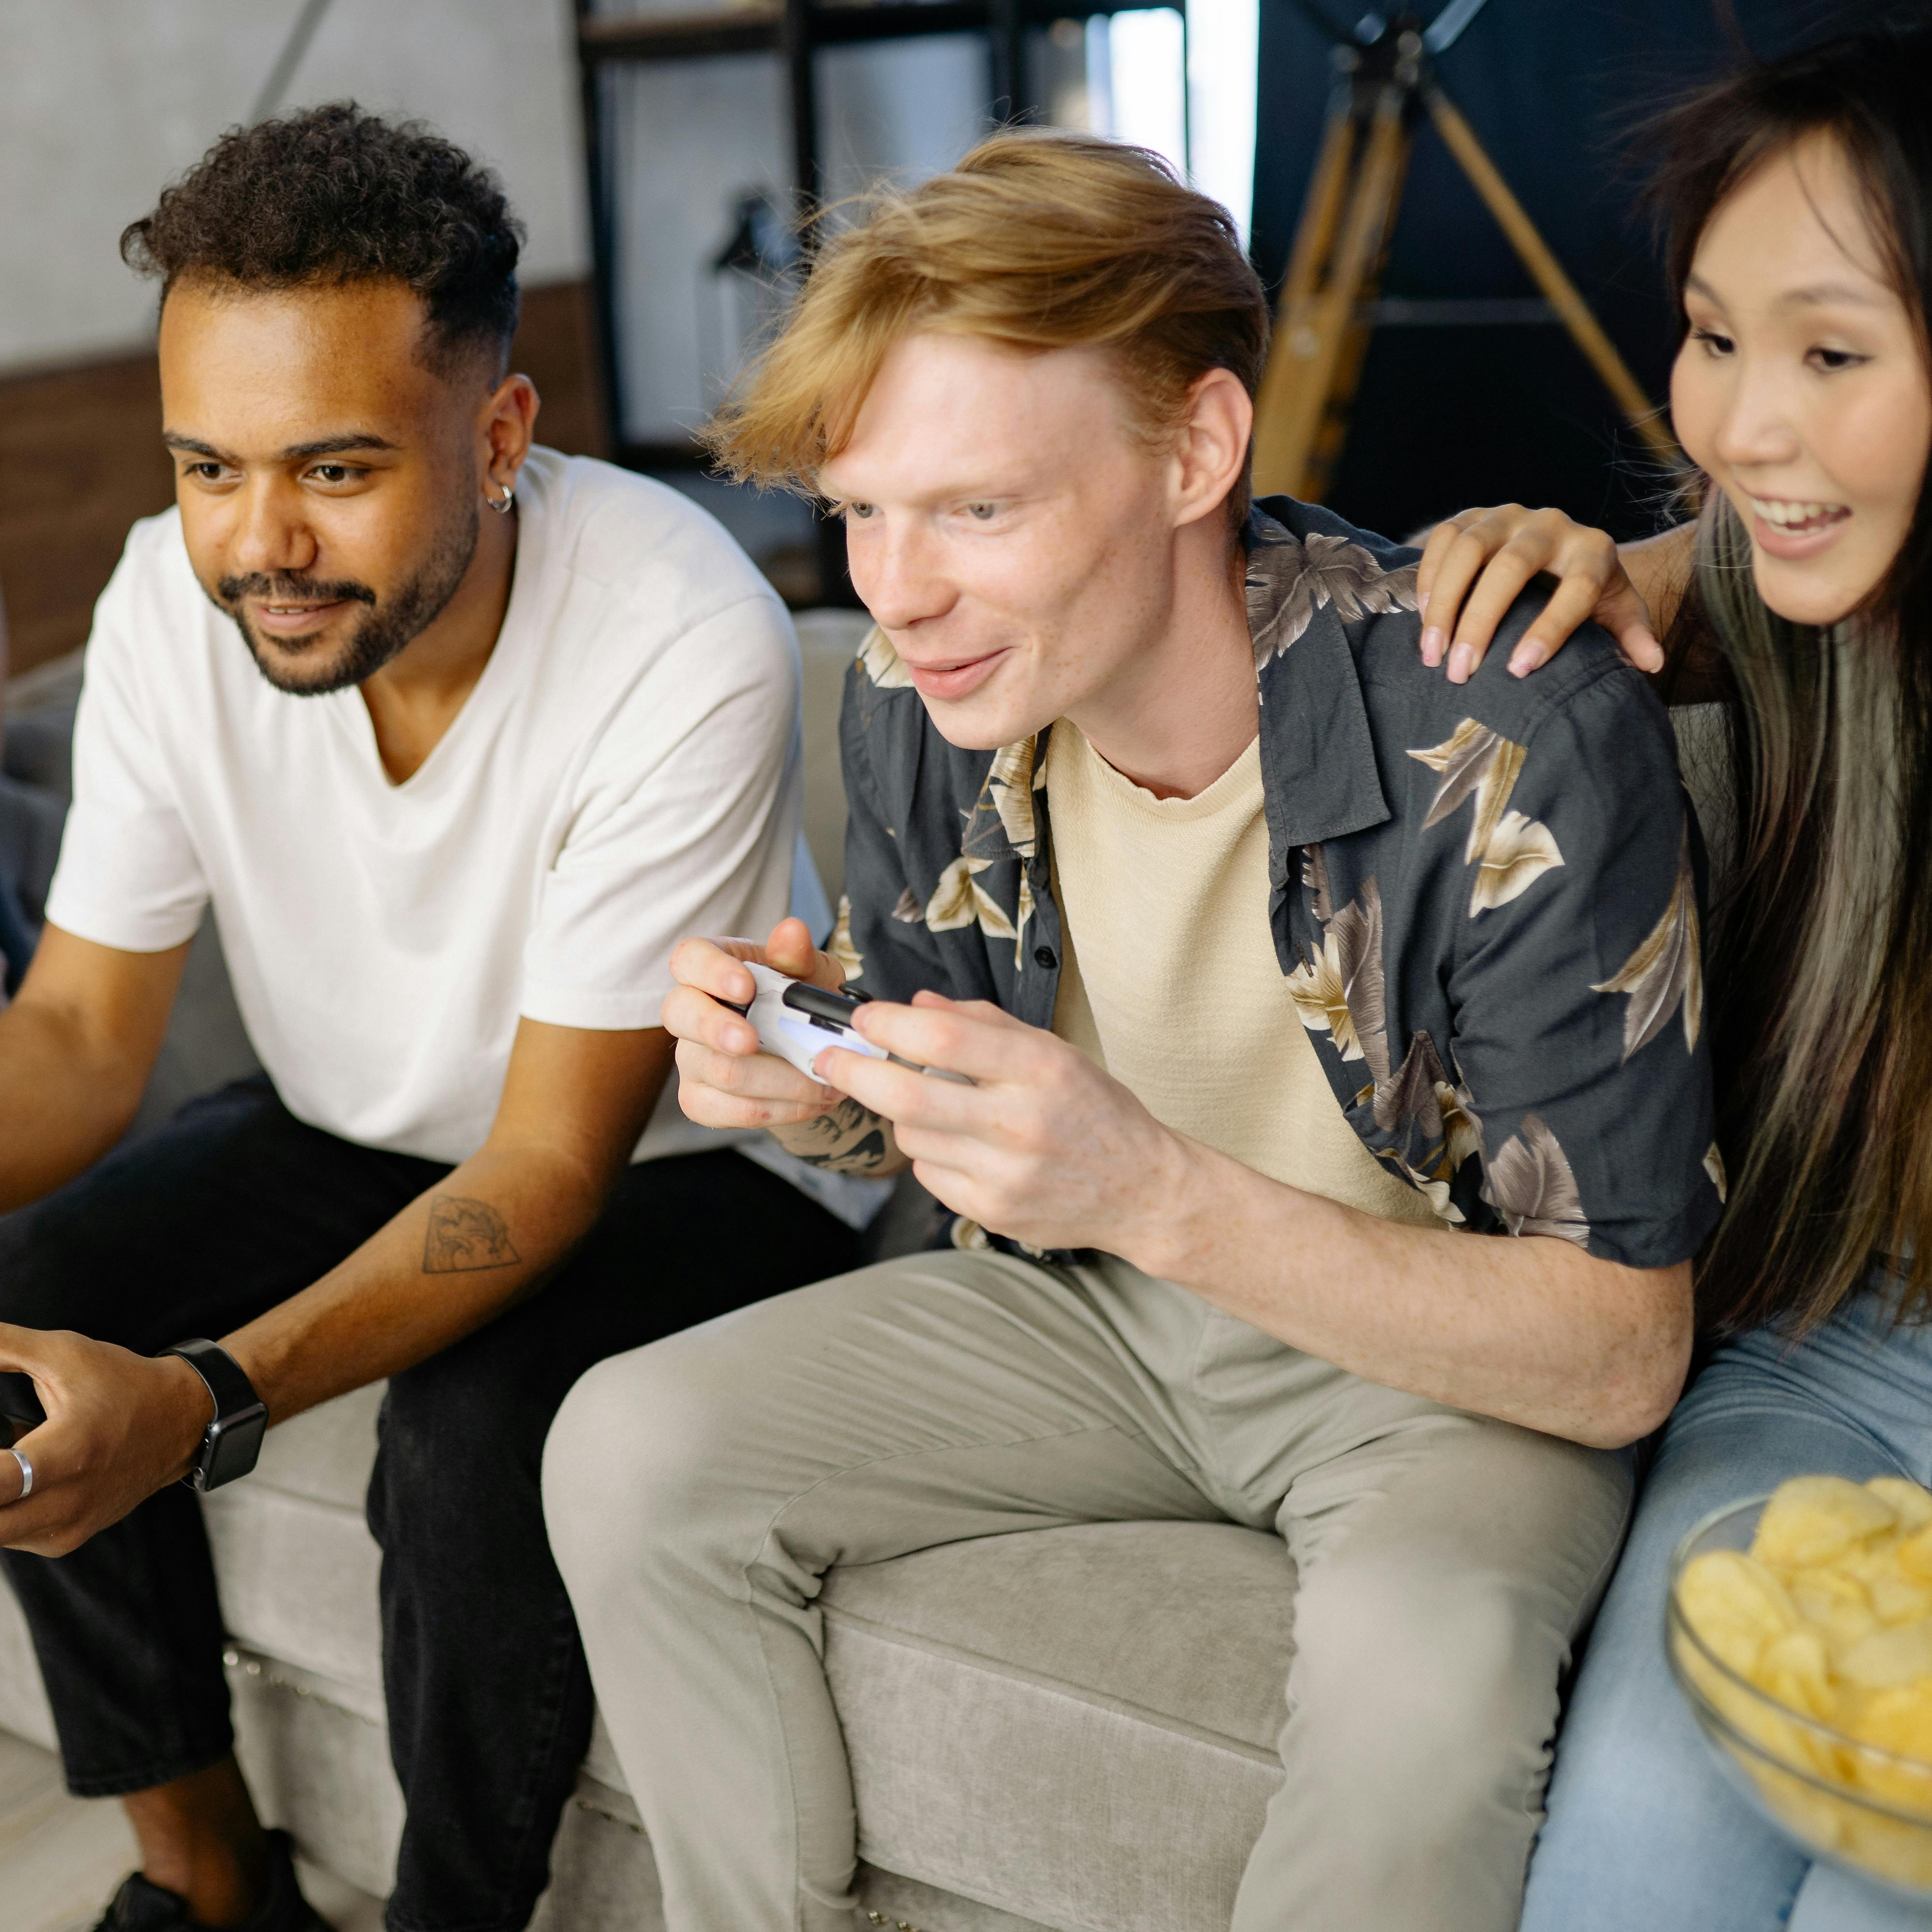
import torch
from diffusers import OmniGenPipeline
from diffusers.utils import load_image

pipe = OmniGenPipeline.from_pretrained(
    "Shitao/OmniGen-v1-diffusers",
    dtype=torch.bfloat16
)
pipe.to("cuda")  # or "mps", "xpu", "cpu"

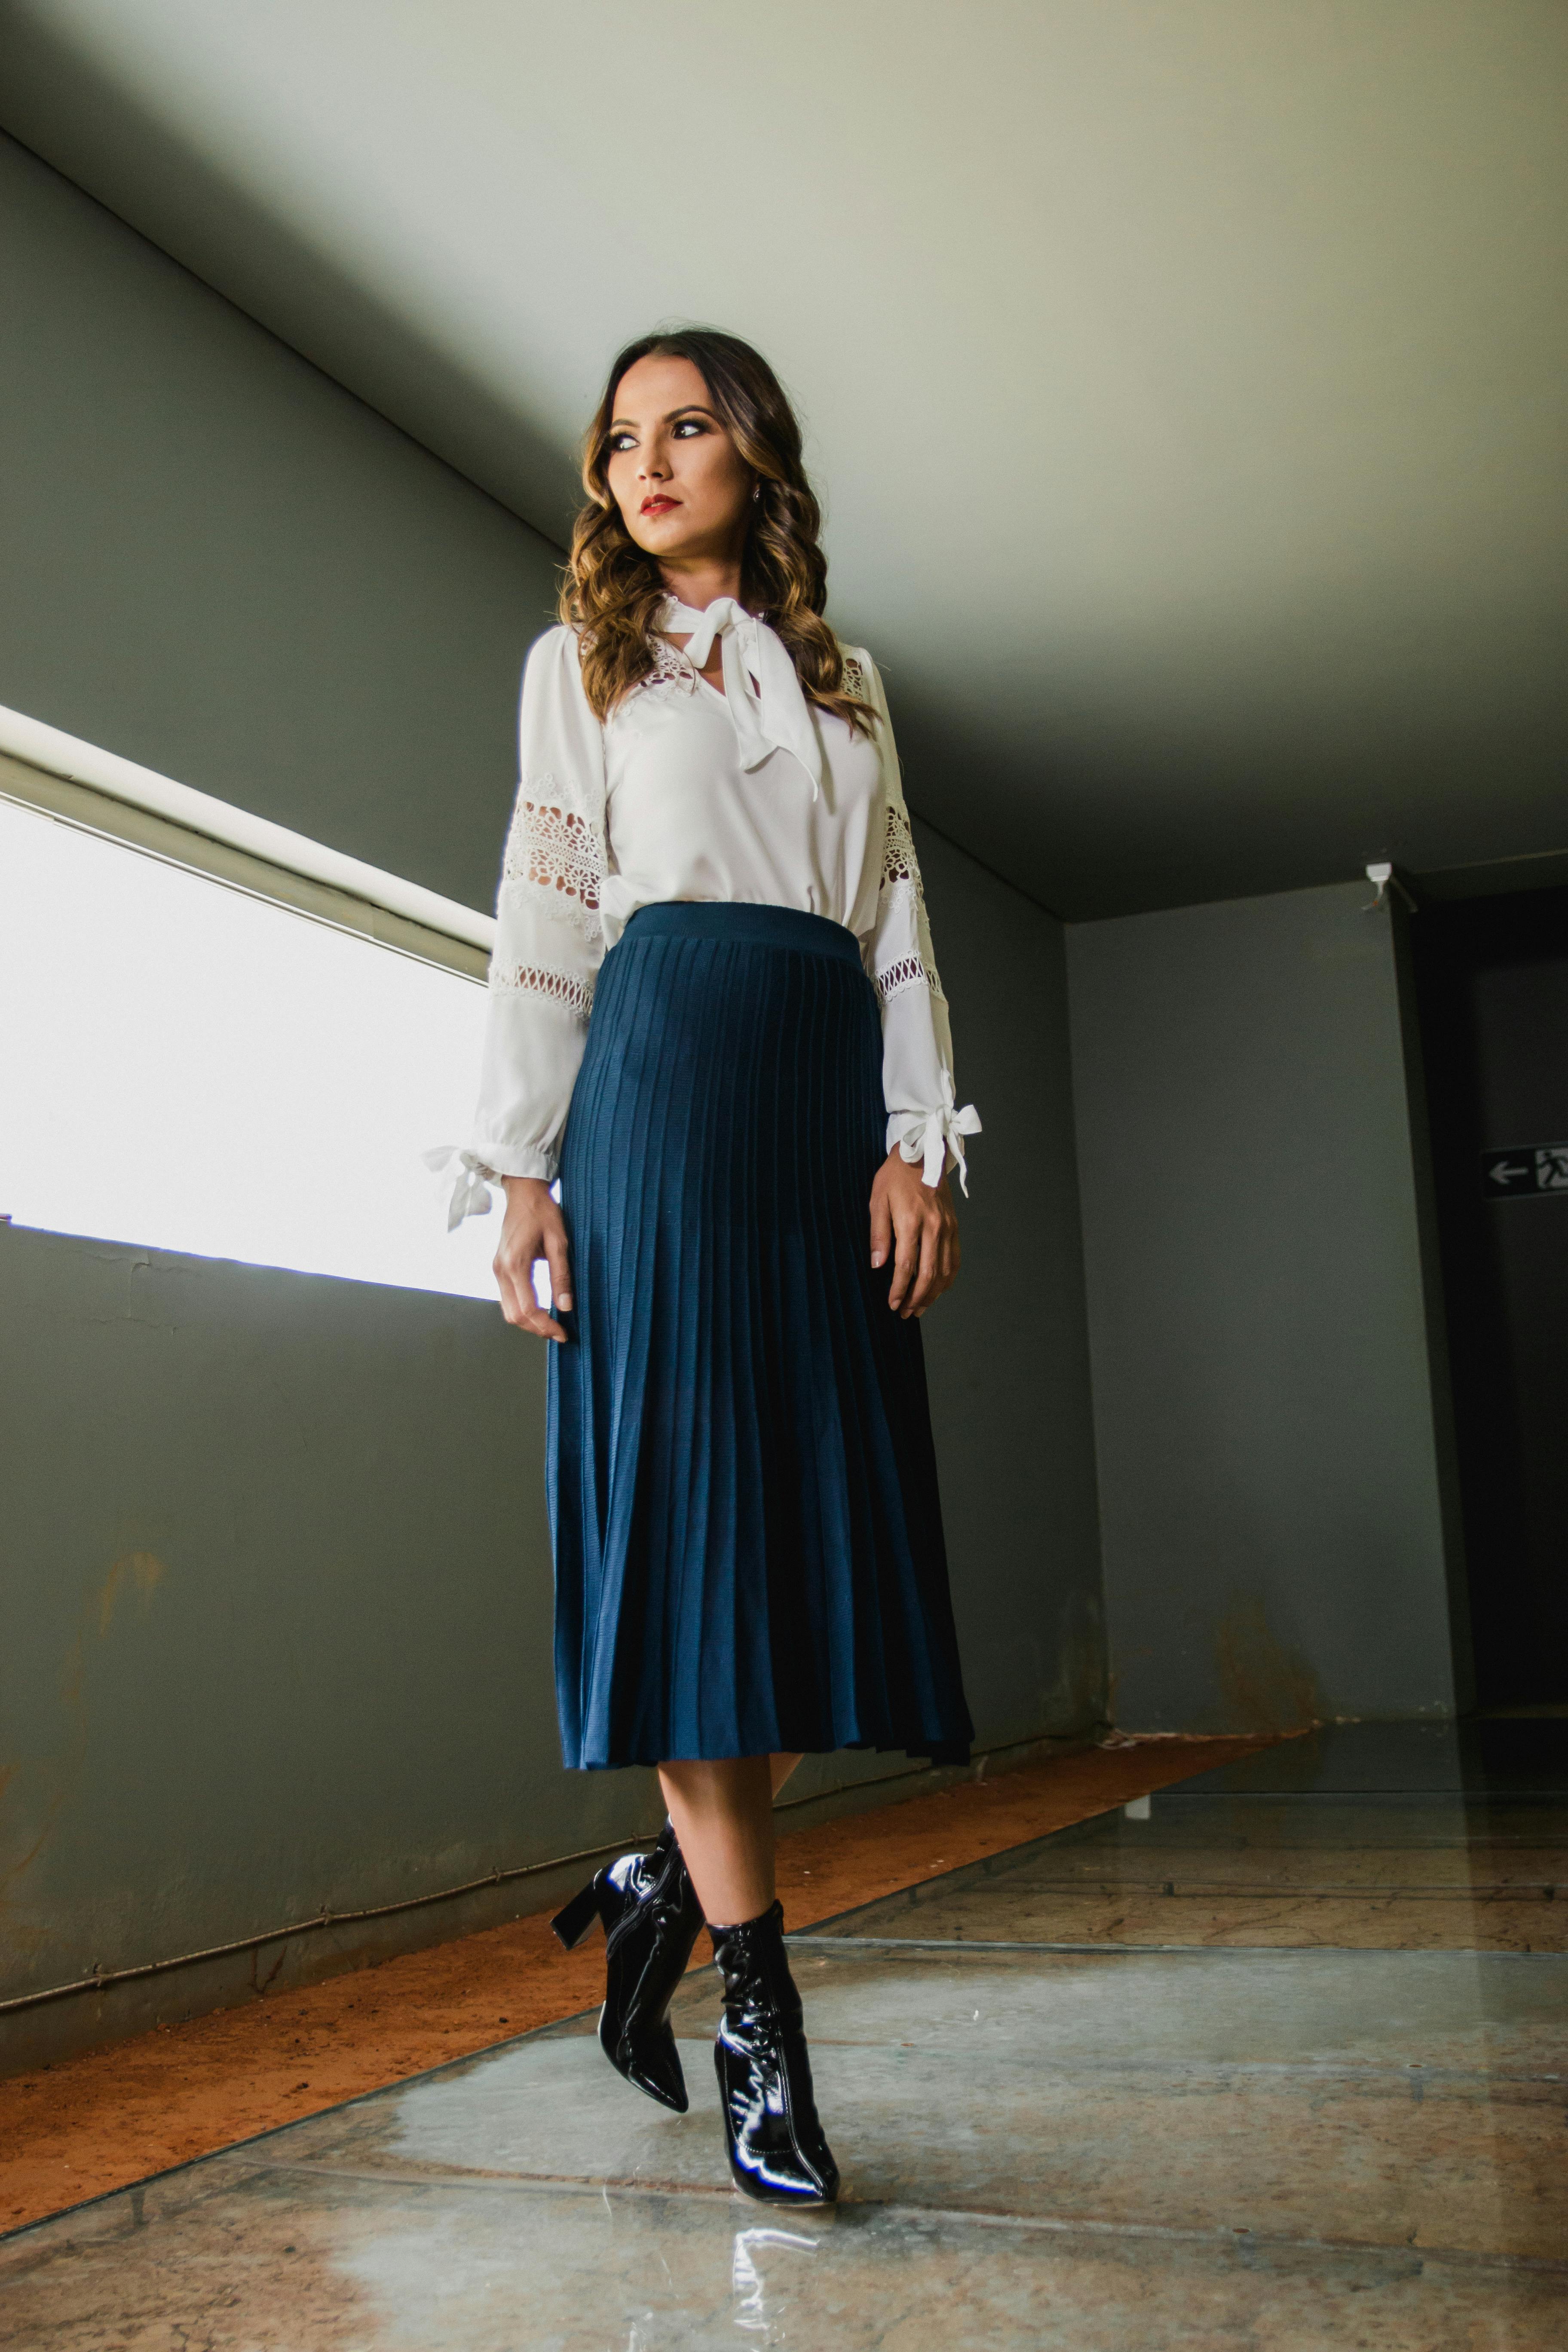
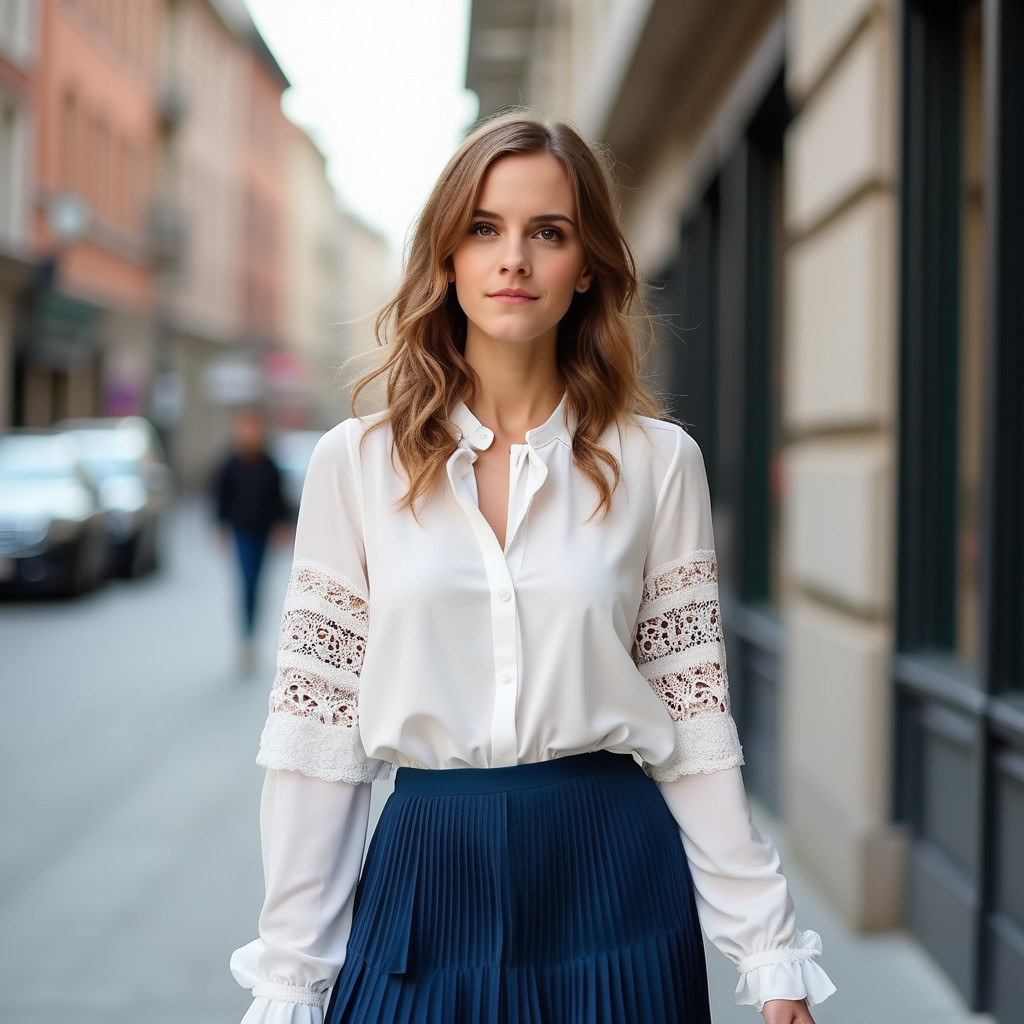
prompt="A woman is walking down the street, wearing a white long-sleeve blouse with lace details on the sleeves, paired with a blue pleated skirt. The woman is <img><|image_1|></img>. The long-sleeve blouse and a pleated skirt are <img><|image_2|></img>."
input_image_1 = load_image("https://raw.githubusercontent.com/VectorSpaceLab/OmniGen/main/imgs/docs_img/emma.jpeg")
input_image_2 = load_image("https://raw.githubusercontent.com/VectorSpaceLab/OmniGen/main/imgs/docs_img/dress.jpg")
input_images=[input_image_1, input_image_2]
image = pipe(
    prompt=prompt,
    input_images=input_images,
    height=1024,
    width=1024,
    guidance_scale=2.5,
    img_guidance_scale=1.6,
    generator=torch.Generator(device="cpu").manual_seed(666)
).images[0]
image.save("output.png")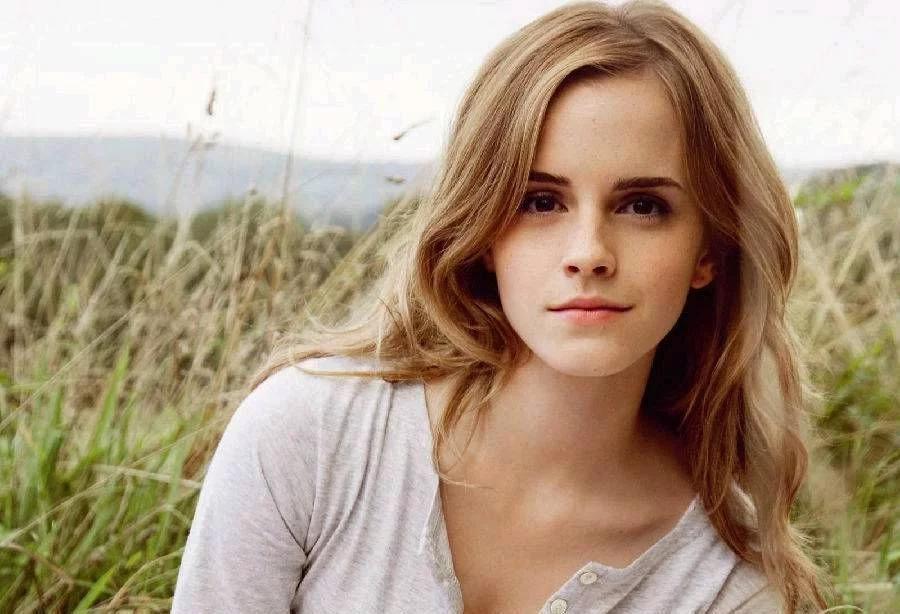
Оптимизация при использовании нескольких изображений
Для задачи генерации изображений по тексту OmniGen требует минимальных затрат памяти и времени (9 ГБ памяти и 31 секунда для изображения 1024x1024 на GPU A800). Однако при использовании входных изображений вычислительные затраты увеличиваются.
Ниже приведены рекомендации, которые помогут снизить вычислительные затраты при работе с несколькими изображениями. Эксперименты проводились на GPU A800 с двумя входными изображениями.
Как и в других конвейерах, вы можете снизить потребление памяти, выгружая модель: pipe.enable_model_cpu_offload() или pipe.enable_sequential_cpu_offload().
В OmniGen вы также можете уменьшить вычислительные затраты, сократив max_input_image_size.
Потребление памяти для разных размеров изображений показано в таблице ниже:
| Метод | Использование памяти |
|---|---|
| max_input_image_size=1024 | 40 ГБ |
| max_input_image_size=512 | 17 ГБ |
| max_input_image_size=256 | 14 ГБ |
OmniGenPipeline
класс diffusers.OmniGenPipeline
< source >( transformer: OmniGenTransformer2DModelscheduler: FlowMatchEulerDiscreteSchedulervae: AutoencoderKLtokenizer: LlamaTokenizer )
Параметры
- transformer (OmniGenTransformer2DModel) — Авторегрессионная архитектура Transformer для OmniGen.
- scheduler (FlowMatchEulerDiscreteScheduler) —
планировщик, используемый в связке с
transformerдля удаления шума из закодированных латентов изображения. - vae (AutoencoderKL) — Модель вариационного автоэнкодера (VAE) для кодирования изображений в латентные представления и декодирования из них.
- tokenizer (
LlamaTokenizer) — Токенизатор текста класса LlamaTokenizer.
Конвейер OmniGen для генерации изображений из мультимодальных данных.
Ссылка: https://huggingface.co/papers/2409.11340
__call__
< source >( prompt: str | list[str]input_images: typing.Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor], list[typing.Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor]]]] = Noneheight: int | None = Nonewidth: int | None = Nonenum_inference_steps: int = 50max_input_image_size: int = 1024timesteps: list[int] = Noneguidance_scale: float = 2.5img_guidance_scale: float = 1.6use_input_image_size_as_output: bool = Falsenum_images_per_prompt: int | None = 1generator: typing.Union[torch.Generator, list[torch.Generator], NoneType] = Nonelatents: typing.Optional[torch.Tensor] = Noneoutput_type: str | None = 'pil'return_dict: bool = Truecallback_on_step_end: typing.Optional[typing.Callable[[int, int], NoneType]] = Nonecallback_on_step_end_tensor_inputs: list[str] = ['latents'] ) → ImagePipelineOutput or tuple
Параметры
- prompt (
strorlist[str], необязательный) — Промпт или промпты для управления генерацией изображения. Если входные данные включают изображения, необходимо добавить в промпт плейсхолдеры<img><|image_i|></img>, чтобы указать позицию i-го изображения. - input_images (
PipelineImageInputилиlist[PipelineImageInput], необязательный) — Список входных изображений. Мы заменим «<|image_i|>» в prompt на i-е изображение из списка. - height (
int, необязательный, по умолчанию self.unet.config.sample_size * self.vae_scale_factor) — Высота генерируемого изображения в пикселях. По умолчанию установлено значение 1024 для достижения наилучших результатов. - width (
int, необязательный, по умолчанию self.unet.config.sample_size * self.vae_scale_factor) — Ширина генерируемого изображения в пикселях. По умолчанию установлено значение 1024 для достижения наилучших результатов. - num_inference_steps (
int, необязательный, по умолчанию 50) — Количество шагов денойзинга. Как правило, большее число шагов денойзинга приводит к изображению более высокого качества, но за счёт более медленного вывода. - max_input_image_size (
int, необязательный, по умолчанию 1024) — максимальный размер входного изображения, который будет использоваться для обрезки входного изображения до максимального размера - timesteps (
list[int], необязательный) — Пользовательские шаги для процесса удаления шума в планировщиках, поддерживающих аргументtimestepsв методеset_timesteps. Если не задан, будет использоваться поведение по умолчанию при передачеnum_inference_steps. Значения должны быть в порядке убывания. - guidance_scale (
float, необязательный, по умолчанию 2.5) — Масштаб руководства, как определено в Classifier-Free Diffusion Guidance.guidance_scaleопределяется какwиз уравнения 2 статьи Imagen Paper. Масштаб руководства включается при установкеguidance_scale > 1. Более высокий масштаб руководства способствует генерации изображений, тесно связанных с текстомprompt, обычно за счёт снижения качества изображения. - img_guidance_scale (
float, необязательный, по умолчанию 1.6) — Определён как уравнение 3 в Instrucpix2pix. - use_input_image_size_as_output (bool, по умолчанию False) — определяет, следует ли использовать размер входного изображения в качестве размера выходного изображения. Может применяться для входных данных из одного изображения, например, для задачи редактирования изображений
- num_images_per_prompt (
int, необязательный, по умолчанию 1) — Количество изображений, генерируемых для каждого промпта. - generator (
torch.Generatorилиlist[torch.Generator], необязательный) — Один или список генераторов torch для обеспечения детерминированности генерации. - latents (
torch.Tensor, необязательный) — Предварительно сгенерированные зашумлённые латенты, выбранные из гауссова распределения, которые используются в качестве входных данных для генерации изображений. Позволяет корректировать один и тот же процесс генерации с помощью различных промптов. Если не заданы, тензор латентов будет сгенерирован путём выборки с использованием переданного случайногоgenerator. - output_type (
str, необязательный, по умолчанию"pil") — Формат вывода сгенерированного изображения. Выберите один из вариантов: PIL:PIL.Image.Imageилиnp.array. - return_dict (
bool, необязательный, по умолчаниюTrue) — Определяет, следует ли возвращать~pipelines.flux.FluxPipelineOutputвместо обычного кортежа. - callback_on_step_end (
Callable, необязательный) — Функция, вызываемая в конце каждого шага денойзинга во время инференса. Функция вызывается со следующими аргументами:callback_on_step_end(self: DiffusionPipeline, step: int, timestep: int, callback_kwargs: Dict).callback_kwargsбудет содержать список всех тензоров, как указано вcallback_on_step_end_tensor_inputs. - callback_on_step_end_tensor_inputs (
list, необязательный) — Список тензорных входных данных для функцииcallback_on_step_end. Тензоры, указанные в списке, будут переданы в качестве аргументаcallback_kwargs. Вы сможете включать только переменные, перечисленные в атрибуте._callback_tensor_inputsвашего класса пайплайна.
Возвращает
ImagePipelineOutput или tuple
ImagePipelineOutput, если return_dict равно True,
иначе — tuple. При возврате кортежа первым элементом является список с сгенерированными изображениями.
Функция, вызываемая при обращении к конвейеру для генерации.
Примеры:
>>> import torch
>>> from diffusers import OmniGenPipeline

>>> pipe = OmniGenPipeline.from_pretrained("Shitao/OmniGen-v1-diffusers", torch_dtype=torch.bfloat16)
>>> pipe.to("cuda")

>>> prompt = "A cat holding a sign that says hello world"
>>> # Depending on the variant being used, the pipeline call will slightly vary.
>>> # Refer to the pipeline documentation for more details.
>>> image = pipe(prompt, num_inference_steps=50, guidance_scale=2.5).images[0]
>>> image.save("output.png")
Возвращает: ImagePipelineOutput или tuple:
Если return_dict равно True, возвращается ImagePipelineOutput, иначе возвращается tuple,
первым элементом которого является список с сгенерированными изображениями.
encode_input_images
< source >( input_pixel_values: list[torch.Tensor]device: typing.Optional[torch.device] = Nonedtype: typing.Optional[torch.dtype] = None )
получить продолжение эмбеддинга входных изображений с помощью VAE
Возвращает: torch.Tensor