# Nougat
## Aperçu
Le modèle Nougat a été proposé dans [Nougat: Neural Optical Understanding for Academic Documents](https://huggingface.co/papers/2308.13418) par Lukas Blecher, Guillem Cucurull, Thomas Scialom et Robert Stojnic. Nougat utilise la même architecture que [Donut](donut), c'est-à-dire un encodeur Transformer d'images et un décodeur Transformer de texte autorégressif, afin de traduire les PDF scientifiques en markdown et ainsi faciliter leur accès.
L'abstract de l'article est le suivant :
*Les connaissances scientifiques sont principalement stockées dans des livres et des revues scientifiques, souvent sous forme de PDF. Cependant, le format PDF entraîne une perte d’informations sémantiques, en particulier pour les expressions mathématiques. Nous proposons Nougat (Neural Optical Understanding for Academic Documents), un modèle Visual Transformer qui exécute une tâche de reconnaissance optique de caractères (OCR) pour traiter les documents scientifiques en langage de balisage, et nous démontrons l’efficacité de notre modèle sur un nouveau jeu de données de documents scientifiques. L’approche proposée offre une solution prometteuse pour améliorer l’accessibilité des connaissances scientifiques à l’ère numérique, en comblant le fossé entre les documents lisibles par l’homme et le texte lisible par machine. Nous publions les modèles et le code pour accélérer les travaux futurs sur la reconnaissance de texte scientifique.*
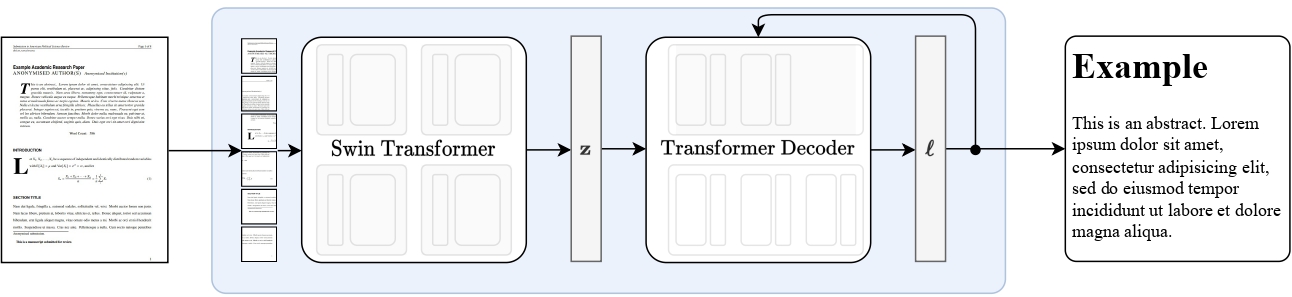 Vue d'ensemble de Nougat. Issue de l'article original.
Ce modèle a été contribué par [nielsr](https://huggingface.co/nielsr). Le code d'origine peut être trouvé [ici](https://github.com/facebookresearch/nougat).
## Conseils d'utilisation
- La façon la plus rapide de se familiariser avec Nougat est de consulter les [carnets de tutoriel](https://github.com/NielsRogge/Transformers-Tutorials/tree/master/Nougat), qui montrent comment utiliser le modèle lors de l'inférence ainsi que comment l'ajuster finement sur des données personnalisées.
- Nougat est toujours utilisé dans le cadre de [VisionEncoderDecoder](vision-encoder-decoder). Le modèle est identique à [Donut](donut) en termes d'architecture.
## Inférence
Le modèle `VisionEncoderDecoder` de Nougat accepte des images en entrée et utilise [generate()](/docs/transformers/main/fr/main_classes/text_generation#transformers.GenerationMixin.generate) pour générer du texte de manière autorégressive à partir de l'image d'entrée.
La classe [NougatImageProcessor](/docs/transformers/main/fr/model_doc/nougat#transformers.NougatImageProcessor) est chargée de la prétraitement de l'image d'entrée, tandis que [NougatTokenizerFast](/docs/transformers/main/fr/model_doc/nougat#transformers.NougatTokenizer) décode les jetons cibles générés en chaîne de caractères cible. La classe [NougatProcessor](/docs/transformers/main/fr/model_doc/nougat#transformers.NougatProcessor) encapsule les classes [NougatImageProcessor](/docs/transformers/main/fr/model_doc/nougat#transformers.NougatImageProcessor) et [NougatTokenizerFast](/docs/transformers/main/fr/model_doc/nougat#transformers.NougatTokenizer) en une seule instance afin d'extraire les caractéristiques d'entrée et de décoder les identifiants de jetons prédits.
- Transcription de PDF étape par étape
```python
from huggingface_hub import hf_hub_download
from PIL import Image
from transformers import AutoModelForImageTextToText, NougatProcessor
processor = NougatProcessor.from_pretrained("facebook/nougat-base")
model = AutoModelForImageTextToText.from_pretrained("facebook/nougat-base", device_map="auto")
model.to(model.device) # doctest: +IGNORE_RESULT
# prepare PDF image for the model
filepath = hf_hub_download(repo_id="hf-internal-testing/fixtures_docvqa", filename="nougat_paper.png", repo_type="dataset")
image = Image.open(filepath)
pixel_values = processor(image, return_tensors="pt").to(model.device).pixel_values
# generate transcription (here we only generate 30 tokens)
outputs = model.generate(
pixel_values.to(model.device),
min_length=1,
max_new_tokens=30,
bad_words_ids=[[processor.tokenizer.unk_token_id]],
)
sequence = processor.batch_decode(outputs, skip_special_tokens=True)[0]
sequence = processor.post_process_generation(sequence, fix_markdown=False)
# note: we're using repr here such for the sake of printing the \n characters, feel free to just print the sequence
print(repr(sequence))
'\n\n# Nougat: Neural Optical Understanding for Academic Documents\n\n Lukas Blecher\n\nCorrespondence to: lblecher@'
```
Consultez le [model hub](https://huggingface.co/models?filter=nougat) pour rechercher des points de contrôle Nougat.
Le modèle est identique à [Donut](donut) en termes d'architecture.
## NougatConfig[[transformers.NougatConfig]]
#### transformers.NougatConfig[[transformers.NougatConfig]]
```python
transformers.NougatConfig(transformers_version: str | None = None, architectures: list[str] | None = None, output_hidden_states: bool | None = False, return_dict: bool | None = True, dtype: str | torch.dtype | None = None, chunk_size_feed_forward: int = 0, id2label: dict[int, str] | dict[str, str] | None = None, label2id: dict[str, int] | dict[str, str] | None = None, problem_type: Literal['regression', 'single_label_classification', 'multi_label_classification'] | None = None, is_encoder_decoder: bool = True, encoder: dict | transformers.configuration_utils.PreTrainedConfig | None = None, decoder: dict | transformers.configuration_utils.PreTrainedConfig | None = None)
```
[Source](https://github.com/huggingface/transformers/blob/main/src/transformers/models/nougat/configuration_nougat.py#L28)
**Paramètres :**
is_encoder_decoder (`bool`, *facultatif*, valeur par défaut `True`) : Indique si le modèle est utilisé comme encodeur/décodeur ou non.
encoder (`Union[dict, ~configuration_utils.PreTrainedConfig]`, *facultatif*) : L'objet de configuration ou le dictionnaire du backbone de l'encodeur.
decoder (`Union[dict, ~configuration_utils.PreTrainedConfig]`, *facultatif*) : L'objet de configuration ou le dictionnaire du backbone du décodeur.
Ceci est la classe de configuration destinée à stocker la configuration d'un NougatModel. Elle est utilisée pour instancier un modèle Nougat en fonction des arguments spécifiés, en définissant l'architecture du modèle. L'instanciation d'une configuration avec les valeurs par défaut produira une configuration similaire à celle de [facebook/nougat-base](https://huggingface.co/facebook/nougat-base)
Les objets de configuration héritent de [PreTrainedConfig](/docs/transformers/main/fr/main_classes/configuration#transformers.PreTrainedConfig) et peuvent être utilisés pour contrôler les sorties du modèle. Consultez la documentation de [PreTrainedConfig](/docs/transformers/main/fr/main_classes/configuration#transformers.PreTrainedConfig) pour plus d’informations.
Exemples :
```python
>>> from transformers import NougatConfig, VisionEncoderDecoderModel
>>> # Initializing a Nougat configuration
>>> config = NougatConfig()
>>> # Initializing a VisionEncoderDecoder model (with random weights) from a Nougat configurations
>>> model = VisionEncoderDecoderModel(config=config)
```
#### from_encoder_decoder_configs[[transformers.NougatConfig.from_encoder_decoder_configs]]
```python
from_encoder_decoder_configs(encoder_config: PreTrainedConfig, decoder_config: PreTrainedConfig, **kwargs)
```
[Source](https://github.com/huggingface/transformers/blob/main/src/transformers/models/nougat/configuration_nougat.py#L52)
**Retourne :** [VisionEncoderDecoderConfig](/docs/transformers/main/fr/model_doc/vision-encoder-decoder#transformers.VisionEncoderDecoderConfig)
Une instance d'un objet de configuration
Instanciez un [VisionEncoderDecoderConfig](/docs/transformers/main/fr/model_doc/vision-encoder-decoder#transformers.VisionEncoderDecoderConfig) (ou une classe dérivée) à partir de la configuration d'un modèle encodeur pré-entraîné et de la configuration d'un modèle décodeur.
## NougatImageProcessor[[transformers.NougatImageProcessor]]
#### transformers.NougatImageProcessor[[transformers.NougatImageProcessor]]
```python
transformers.NougatImageProcessor(**kwargs: *)
```
[Source](https://github.com/huggingface/transformers/blob/main/src/transformers/models/nougat/image_processing_nougat.py#L57)
**Paramètres :**
do_convert_rgb (`bool`, *kwargs*, *facultatif*) : Indique s'il faut convertir l'image en RGB.
do_resize (`bool`, *kwargs*, *facultatif*, valeur par défaut `True`) : Indique s'il faut redimensionner l'image.
size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*, par défaut `{'height' : 896, 'width': 672}`) : Décrit les dimensions d'entrée maximales du modèle.
default_to_square (`bool`, *kwargs*, *facultatif*, valeur par défaut `True`) : Indique s'il faut par défaut redimensionner l'image en un carré si la taille est un entier.
crop_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Taille de l'image de sortie après application de `center_crop`.
resample (`Annotated[Union[int, PILImageResampling, NoneType], None]`, *kwargs*, par défaut `2`) : Filtre de rééchantillonnage à utiliser lors du redimensionnement de l'image. Il peut s'agir d'une des valeurs de l'énumération `PILImageResampling`. N'a un effet que si `do_resize` est défini sur `True`.
do_rescale (`bool`, *kwargs*, *facultatif*, valeur par défaut `True`) : Indique s'il faut rééchelonner l'image.
rescale_factor (`float`, *kwargs*, *facultatif*, valeur par défaut `0.00392156862745098`) : Facteur de remise à l'échelle appliqué à l'image si `do_rescale` est défini sur `True`.
do_normalize (`bool`, *kwargs*, *facultatif*, valeur par défaut `True`) : Indique s'il faut normaliser l'image.
image_mean (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *facultatif*, valeur par défaut `[0.485, 0.456, 0.406]`) : Moyenne de l'image à utiliser pour la normalisation. N'a un effet que si `do_normalize` est défini sur `True`.
image_std (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *facultatif*, valeur par défaut `[0.229, 0.224, 0.225]`) : Écart-type de l'image à utiliser pour la normalisation. N'a un effet que si `do_normalize` est défini sur `True`.
do_pad (`bool`, *kwargs*, *facultatif*, valeur par défaut `True`) : Indique s'il faut ajouter un rembourrage à l'image. Le rembourrage est effectué soit jusqu'à la plus grande taille du lot, soit jusqu'à une taille carrée fixe par image. La stratégie de rembourrage exacte dépend du modèle.
pad_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : La taille au format `{"height": int, "width" int}` à laquelle rembourrer les images. Elle doit être supérieure à la taille de n'importe quelle image fournie pour le prétraitement. Si `pad_size` n'est pas fourni, les images seront rembourrées à la hauteur et à la largeur maximales du lot. Appliqué uniquement lorsque `do_pad=True.`
do_center_crop (`bool`, *kwargs*, *facultatif*) : Indique s'il faut effectuer un recadrage centré de l'image.
data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *facultatif*) : Seul `ChannelDimension.FIRST` est pris en charge. Ajouté pour assurer la compatibilité avec les processeurs lents.
input_data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *facultatif*) : Le format de la dimension des canaux pour l'image d'entrée. Si non défini, le format de la dimension des canaux est déduit de l'image d'entrée. Peut être l'un des éléments suivants : - `"channels_first"` ou `ChannelDimension.FIRST` : image au format (num_channels, height, width). - `"channels_last"` ou `ChannelDimension.LAST` : image au format (height, width, num_channels). - `"none"` ou `ChannelDimension.NONE` : image au format (height, width).
device (`Annotated[Union[str, torch.device, NoneType], None]`, *kwargs*) : L'appareil sur lequel traiter les vidéos. Si non défini, l'appareil est déduit des vidéos d'entrée.
return_tensors (`Annotated[str | ~utils.generic.TensorType | None, None]`, *kwargs*) : Renvoie des tenseurs empilés si la valeur est `'pt'`, sinon renvoie une liste de tenseurs.
disable_grouping (`bool`, *kwargs*, *facultatif*) : Indique s'il faut désactiver le regroupement des images par taille afin de les traiter individuellement plutôt que par lots. Si la valeur est None, elle sera définie sur True si les images sont sur CPU, et sur False dans le cas contraire. Ce choix repose sur des observations empiriques, comme détaillé ici : https://github.com/huggingface/transformers/pull/38157
image_seq_length (`int`, *kwargs*, *facultatif*) : Le nombre de jetons d'image à utiliser pour chaque image de l'entrée. Ajouté pour la compatibilité ascendante, mais cela devrait être défini comme un attribut du processeur dans les futurs modèles.
do_crop_margin (`bool`, *kwargs*, *facultatif*, valeur par défaut `self.do_crop_margin`) : Indique s'il faut recadrer les marges de l'image.
do_thumbnail (`bool`, *kwargs*, *facultatif*, valeur par défaut `self.do_thumbnail`) : Indique s'il faut redimensionner l'image en utilisant la méthode thumbnail.
do_align_long_axis (`bool`, *kwargs*, *facultatif*, valeur par défaut `self.do_align_long_axis`) : Indique s'il faut aligner l'axe long de l'image avec l'axe long de `size` en effectuant une rotation de 90 degrés.
Construit un processeur d’images NougatImageProcessor.
#### prétraiter[[transformers.NougatImageProcessor.preprocess]]
```python
preprocess(images: typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor']], **kwargs: *)
```
[Source](https://github.com/huggingface/transformers/blob/main/src/transformers/models/nougat/image_processing_nougat.py#L74)
**Paramètres :**
images (`Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor]]`) : Image à prétraiter. Attend une image unique ou un lot d'images dont les valeurs de pixels sont comprises entre 0 et 255. Si vous transmettez des images dont les valeurs de pixels sont comprises entre 0 et 1, définissez `do_rescale=False`.
do_convert_rgb (`bool`, *kwargs*, *facultatif*) : Indique s'il faut convertir l'image en RGB.
do_resize (`bool`, *kwargs*, *facultatif*) : Indique s'il faut redimensionner l'image.
size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Décrit les dimensions d'entrée maximales du modèle.
default_to_square (`bool`, *kwargs*, *facultatif*) : Indique s'il faut par défaut redimensionner l'image en un carré lorsque la taille est un entier.
crop_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Taille de l'image de sortie après application de `center_crop`.
resample (`Annotated[Union[int, PILImageResampling, NoneType], None]`, *kwargs*) : Filtre de rééchantillonnage à utiliser lors du redimensionnement de l'image. Il peut s'agir d'une des valeurs de l'énumération `PILImageResampling`. N'a un effet que si `do_resize` est défini sur `True`.
do_rescale (`bool`, *kwargs*, *facultatif*) : Indique s'il faut rééchelonner l'image.
rescale_factor (`float`, *kwargs*, *facultatif*) : Facteur de redimensionnement à appliquer à l'image si `do_rescale` est défini sur `True`.
do_normalize (`bool`, *kwargs*, *facultatif*) : Indique s'il faut normaliser l'image.
image_mean (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *facultatif*) : Moyenne de l'image à utiliser pour la normalisation. N'a un effet que si `do_normalize` est défini sur `True`.
image_std (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *facultatif*) : Écart-type de l'image à utiliser pour la normalisation. N'a un effet que si `do_normalize` est défini sur `True`.
do_pad (`bool`, *kwargs*, *facultatif*) : Indique s'il faut ajouter un rembourrage à l'image. Le rembourrage est effectué soit jusqu'à la plus grande taille du lot, soit jusqu'à une taille carrée fixe par image. La stratégie de rembourrage exacte dépend du modèle.
pad_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : La taille au format `{"height": int, "width" int}` à laquelle rembourrer les images. Elle doit être supérieure à la taille de n'importe quelle image fournie pour le prétraitement. Si `pad_size` n'est pas fourni, les images seront rembourrées à la hauteur et à la largeur maximales du lot. Appliqué uniquement lorsque `do_pad=True.`
do_center_crop (`bool`, *kwargs*, *facultatif*) : Indique s'il faut effectuer un recadrage centré de l'image.
data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *facultatif*) : Seul `ChannelDimension.FIRST` est pris en charge. Ajouté pour assurer la compatibilité avec les processeurs lents.
input_data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *facultatif*) : Le format de la dimension des canaux pour l'image d'entrée. Si non défini, le format de la dimension des canaux est déduit de l'image d'entrée. Peut être l'un des éléments suivants : - `"channels_first"` ou `ChannelDimension.FIRST` : image au format (num_channels, height, width). - `"channels_last"` ou `ChannelDimension.LAST` : image au format (height, width, num_channels). - `"none"` ou `ChannelDimension.NONE` : image au format (height, width).
device (`Annotated[Union[str, torch.device, NoneType], None]`, *kwargs*) : L'appareil sur lequel traiter les vidéos. Si non défini, l'appareil est déduit des vidéos d'entrée.
return_tensors (`Annotated[str | ~utils.generic.TensorType | None, None]`, *kwargs*) : Renvoie des tenseurs empilés si la valeur est `'pt'`, sinon renvoie une liste de tenseurs.
disable_grouping (`bool`, *kwargs*, *facultatif*) : Indique s'il faut désactiver le regroupement des images par taille afin de les traiter individuellement plutôt que par lots. Si la valeur est None, elle sera définie sur True si les images sont sur CPU, et sur False dans le cas contraire. Ce choix repose sur des observations empiriques, comme détaillé ici : https://github.com/huggingface/transformers/pull/38157
image_seq_length (`int`, *kwargs*, *facultatif*) : Le nombre de jetons d'image à utiliser pour chaque image de l'entrée. Ajouté pour la compatibilité ascendante, mais cela devrait être défini comme un attribut du processeur dans les futurs modèles.
do_crop_margin (`bool`, *kwargs*, *facultatif*, valeur par défaut `self.do_crop_margin`) : Indique s'il faut recadrer les marges de l'image.
do_thumbnail (`bool`, *kwargs*, *facultatif*, valeur par défaut `self.do_thumbnail`) : Indique s'il faut redimensionner l'image en utilisant la méthode thumbnail.
do_align_long_axis (`bool`, *kwargs*, *facultatif*, valeur par défaut `self.do_align_long_axis`) : Indique s'il faut aligner l'axe long de l'image avec l'axe long de `size` en effectuant une rotation de 90 degrés.
**Retourne :** `~image_processing_base.BatchFeature`
- **data** (`dict`) -- Dictionnaire de listes/tableaux/tenseurs renvoyé par la méthode __call__ (« pixel_values », etc.).
- **tensor_type** (`Union[None, str, TensorType]`, *facultatif*) -- Vous pouvez spécifier un tensor_type ici pour convertir les listes d'entiers en tenseurs PyTorch/Numpy lors de l'initialisation.
## NougatImageProcessorPil[[transformers.NougatImageProcessorPil]]
#### transformers.NougatImageProcessorPil[[transformers.NougatImageProcessorPil]]
```python
transformers.NougatImageProcessorPil(**kwargs: *)
```
[Source](https://github.com/huggingface/transformers/blob/main/src/transformers/models/nougat/image_processing_pil_nougat.py#L59)
**Paramètres :**
do_convert_rgb (`bool`, *kwargs*, *facultatif*) : Indique s'il faut convertir l'image en RGB.
do_resize (`bool`, *kwargs*, *facultatif*, valeur par défaut `True`) : Indique s'il faut redimensionner l'image.
size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*, par défaut `{'height' : 896, 'width': 672}`) : Décrit les dimensions d'entrée maximales du modèle.
default_to_square (`bool`, *kwargs*, *facultatif*, valeur par défaut `True`) : Indique s'il faut par défaut redimensionner l'image en un carré si la taille est un entier.
crop_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Taille de l'image de sortie après application de `center_crop`.
resample (`Annotated[Union[int, PILImageResampling, NoneType], None]`, *kwargs*, par défaut `2`) : Filtre de rééchantillonnage à utiliser lors du redimensionnement de l'image. Il peut s'agir d'une des valeurs de l'énumération `PILImageResampling`. N'a un effet que si `do_resize` est défini sur `True`.
do_rescale (`bool`, *kwargs*, *facultatif*, valeur par défaut `True`) : Indique s'il faut rééchelonner l'image.
rescale_factor (`float`, *kwargs*, *facultatif*, valeur par défaut `0.00392156862745098`) : Facteur de remise à l'échelle appliqué à l'image si `do_rescale` est défini sur `True`.
do_normalize (`bool`, *kwargs*, *facultatif*, valeur par défaut `True`) : Indique s'il faut normaliser l'image.
image_mean (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *facultatif*, valeur par défaut `[0.485, 0.456, 0.406]`) : Moyenne de l'image à utiliser pour la normalisation. N'a un effet que si `do_normalize` est défini sur `True`.
image_std (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *facultatif*, valeur par défaut `[0.229, 0.224, 0.225]`) : Écart-type de l'image à utiliser pour la normalisation. N'a un effet que si `do_normalize` est défini sur `True`.
do_pad (`bool`, *kwargs*, *facultatif*, valeur par défaut `True`) : Indique s'il faut ajouter un rembourrage à l'image. Le rembourrage est effectué soit jusqu'à la plus grande taille du lot, soit jusqu'à une taille carrée fixe par image. La stratégie de rembourrage exacte dépend du modèle.
pad_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : La taille au format `{"height": int, "width" int}` à laquelle rembourrer les images. Elle doit être supérieure à la taille de n'importe quelle image fournie pour le prétraitement. Si `pad_size` n'est pas fourni, les images seront rembourrées à la hauteur et à la largeur maximales du lot. Appliqué uniquement lorsque `do_pad=True.`
do_center_crop (`bool`, *kwargs*, *facultatif*) : Indique s'il faut effectuer un recadrage centré de l'image.
data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *facultatif*) : Seul `ChannelDimension.FIRST` est pris en charge. Ajouté pour assurer la compatibilité avec les processeurs lents.
input_data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *facultatif*) : Le format de la dimension des canaux pour l'image d'entrée. Si non défini, le format de la dimension des canaux est déduit de l'image d'entrée. Peut être l'un des éléments suivants : - `"channels_first"` ou `ChannelDimension.FIRST` : image au format (num_channels, height, width). - `"channels_last"` ou `ChannelDimension.LAST` : image au format (height, width, num_channels). - `"none"` ou `ChannelDimension.NONE` : image au format (height, width).
device (`Annotated[Union[str, torch.device, NoneType], None]`, *kwargs*) : L'appareil sur lequel traiter les vidéos. Si non défini, l'appareil est déduit des vidéos d'entrée.
return_tensors (`Annotated[str | ~utils.generic.TensorType | None, None]`, *kwargs*) : Renvoie des tenseurs empilés si la valeur est `'pt'`, sinon renvoie une liste de tenseurs.
disable_grouping (`bool`, *kwargs*, *facultatif*) : Indique s'il faut désactiver le regroupement des images par taille afin de les traiter individuellement plutôt que par lots. Si la valeur est None, elle sera définie sur True si les images sont sur CPU, et sur False dans le cas contraire. Ce choix repose sur des observations empiriques, comme détaillé ici : https://github.com/huggingface/transformers/pull/38157
image_seq_length (`int`, *kwargs*, *facultatif*) : Le nombre de jetons d'image à utiliser pour chaque image de l'entrée. Ajouté pour la compatibilité ascendante, mais cela devrait être défini comme un attribut du processeur dans les futurs modèles.
do_crop_margin (`bool`, *kwargs*, *facultatif*, valeur par défaut `self.do_crop_margin`) : Indique s'il faut recadrer les marges de l'image.
do_thumbnail (`bool`, *kwargs*, *facultatif*, valeur par défaut `self.do_thumbnail`) : Indique s'il faut redimensionner l'image en utilisant la méthode thumbnail.
do_align_long_axis (`bool`, *kwargs*, *facultatif*, valeur par défaut `self.do_align_long_axis`) : Indique s'il faut aligner l'axe long de l'image avec l'axe long de `size` en effectuant une rotation de 90 degrés.
Construit un processeur d’images NougatImageProcessor.
#### prétraiter[[transformers.NougatImageProcessorPil.preprocess]]
```python
preprocess(images: typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor']], **kwargs: *)
```
[Source](https://github.com/huggingface/transformers/blob/main/src/transformers/models/nougat/image_processing_pil_nougat.py#L76)
**Paramètres :**
images (`Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor]]`) : Image à prétraiter. Attend une image unique ou un lot d'images dont les valeurs de pixels sont comprises entre 0 et 255. Si vous transmettez des images dont les valeurs de pixels sont comprises entre 0 et 1, définissez `do_rescale=False`.
do_convert_rgb (`bool`, *kwargs*, *facultatif*) : Indique s'il faut convertir l'image en RGB.
do_resize (`bool`, *kwargs*, *facultatif*) : Indique s'il faut redimensionner l'image.
size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Décrit les dimensions d'entrée maximales du modèle.
default_to_square (`bool`, *kwargs*, *facultatif*) : Indique s'il faut par défaut redimensionner l'image en un carré lorsque la taille est un entier.
crop_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Taille de l'image de sortie après application de `center_crop`.
resample (`Annotated[Union[int, PILImageResampling, NoneType], None]`, *kwargs*) : Filtre de rééchantillonnage à utiliser lors du redimensionnement de l'image. Il peut s'agir d'une des valeurs de l'énumération `PILImageResampling`. N'a un effet que si `do_resize` est défini sur `True`.
do_rescale (`bool`, *kwargs*, *facultatif*) : Indique s'il faut rééchelonner l'image.
rescale_factor (`float`, *kwargs*, *facultatif*) : Facteur de redimensionnement à appliquer à l'image si `do_rescale` est défini sur `True`.
do_normalize (`bool`, *kwargs*, *facultatif*) : Indique s'il faut normaliser l'image.
image_mean (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *facultatif*) : Moyenne de l'image à utiliser pour la normalisation. N'a un effet que si `do_normalize` est défini sur `True`.
image_std (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *facultatif*) : Écart-type de l'image à utiliser pour la normalisation. N'a un effet que si `do_normalize` est défini sur `True`.
do_pad (`bool`, *kwargs*, *facultatif*) : Indique s'il faut ajouter un rembourrage à l'image. Le rembourrage est effectué soit jusqu'à la plus grande taille du lot, soit jusqu'à une taille carrée fixe par image. La stratégie de rembourrage exacte dépend du modèle.
pad_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : La taille au format `{"height": int, "width" int}` à laquelle rembourrer les images. Elle doit être supérieure à la taille de n'importe quelle image fournie pour le prétraitement. Si `pad_size` n'est pas fourni, les images seront rembourrées à la hauteur et à la largeur maximales du lot. Appliqué uniquement lorsque `do_pad=True.`
do_center_crop (`bool`, *kwargs*, *facultatif*) : Indique s'il faut effectuer un recadrage centré de l'image.
data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *facultatif*) : Seul `ChannelDimension.FIRST` est pris en charge. Ajouté pour assurer la compatibilité avec les processeurs lents.
input_data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *facultatif*) : Le format de la dimension des canaux pour l'image d'entrée. Si non défini, le format de la dimension des canaux est déduit de l'image d'entrée. Peut être l'un des éléments suivants : - `"channels_first"` ou `ChannelDimension.FIRST` : image au format (num_channels, height, width). - `"channels_last"` ou `ChannelDimension.LAST` : image au format (height, width, num_channels). - `"none"` ou `ChannelDimension.NONE` : image au format (height, width).
device (`Annotated[Union[str, torch.device, NoneType], None]`, *kwargs*) : L'appareil sur lequel traiter les vidéos. Si non défini, l'appareil est déduit des vidéos d'entrée.
return_tensors (`Annotated[str | ~utils.generic.TensorType | None, None]`, *kwargs*) : Renvoie des tenseurs empilés si la valeur est `'pt'`, sinon renvoie une liste de tenseurs.
disable_grouping (`bool`, *kwargs*, *facultatif*) : Indique s'il faut désactiver le regroupement des images par taille afin de les traiter individuellement plutôt que par lots. Si la valeur est None, elle sera définie sur True si les images sont sur CPU, et sur False dans le cas contraire. Ce choix repose sur des observations empiriques, comme détaillé ici : https://github.com/huggingface/transformers/pull/38157
image_seq_length (`int`, *kwargs*, *facultatif*) : Le nombre de jetons d'image à utiliser pour chaque image de l'entrée. Ajouté pour la compatibilité ascendante, mais cela devrait être défini comme un attribut du processeur dans les futurs modèles.
do_crop_margin (`bool`, *kwargs*, *facultatif*, valeur par défaut `self.do_crop_margin`) : Indique s'il faut recadrer les marges de l'image.
do_thumbnail (`bool`, *kwargs*, *facultatif*, valeur par défaut `self.do_thumbnail`) : Indique s'il faut redimensionner l'image en utilisant la méthode thumbnail.
do_align_long_axis (`bool`, *kwargs*, *facultatif*, valeur par défaut `self.do_align_long_axis`) : Indique s'il faut aligner l'axe long de l'image avec l'axe long de `size` en effectuant une rotation de 90 degrés.
**Retourne :** `~image_processing_base.BatchFeature`
- **data** (`dict`) -- Dictionnaire de listes/tableaux/tenseurs renvoyé par la méthode __call__ (« pixel_values », etc.).
- **tensor_type** (`Union[None, str, TensorType]`, *facultatif*) -- Vous pouvez spécifier un tensor_type ici pour convertir les listes d'entiers en tenseurs PyTorch/Numpy lors de l'initialisation.
## NougatTokenizer[[transformers.NougatTokenizer]]
#### transformers.NougatTokenizer[[transformers.NougatTokenizer]]
```python
transformers.NougatTokenizer(errors: str = 'replace', unk_token: str = '', bos_token: str = '
', eos_token: str = '', pad_token: str = '', vocab: str | dict | list | None = None, merges: str | list | None = None, **kwargs)
```
[Source](https://github.com/huggingface/transformers/blob/main/src/transformers/models/nougat/tokenization_nougat.py#L347)
**Paramètres :**
vocab_file (`str`, *facultatif*) : Chemin vers le fichier de vocabulaire.
merges_file (`str`, *facultatif*) : Chemin vers le fichier de fusions.
tokenizer_file (`str`, *facultatif*) : fichier [tokenizers](https://github.com/huggingface/tokenizers) (généralement avec une extension .json) contenant tout ce qui est nécessaire pour charger le tokenizer.
clean_up_tokenization_spaces (`str`, *facultatif*, valeur par défaut `False`) : Indique s'il faut nettoyer les espaces après le décodage. Le nettoyage consiste à supprimer les artefacts potentiels, tels que les espaces superflus.
unk_token (`str`, *facultatif*, par défaut `""`) : Le jeton inconnu. Un jeton qui n'est pas dans le vocabulaire ne peut pas être converti en identifiant et est remplacé par ce jeton.
bos_token (`str`, *facultatif*, valeur par défaut `""`) : Jeton de début de séquence utilisé lors du pré-entraînement. Peut être utilisé comme jeton de classifieur de séquence.
eos_token (`str`, *facultatif*, valeur par défaut `""`) : Jeton de fin de séquence.
pad_token (`str`, *facultatif*, par défaut `""`) : le jeton utilisé pour le bourrage, par exemple lors du groupement de séquences de longueurs différentes.
vocab (`str`, `dict` ou `list`, *facultatif*) : Dictionnaire de vocabulaire personnalisé. S'il n'est pas fourni, le vocabulaire est chargé depuis vocab_file.
merges (`str` ou `list`, *facultatif*) : Liste de fusions personnalisées. Si non fournie, les fusions sont chargées depuis merges_file.
Tokeniseur pour Nougat (basé sur la bibliothèque HuggingFace tokenizers).
Ce tokenizer hérite de [TokenizersBackend](/docs/transformers/main/fr/main_classes/tokenizer#transformers.TokenizersBackend), qui contient la plupart des méthodes principales. Les utilisateurs doivent se reporter à cette classe mère pour plus d’informations sur ces méthodes. Cette classe ajoute principalement des méthodes spécifiques à Nougat pour le post-traitement du texte généré.
#### correct_tables[[transformers.NougatTokenizer.correct_tables]]
```python
correct_tables(generation: str)
```
[Source](https://github.com/huggingface/transformers/blob/main/src/transformers/models/nougat/tokenization_nougat.py#L493)
**Paramètres :**
generation (str) : le texte généré à post-traiter.
**Retourne :** `str`
Le texte post-traité.
Prend une chaîne générée et corrige les tableaux pour qu’ils correspondent au format Markdown requis.
Exemple :
```python
correct_tables("\begin{table} \begin{tabular}{l l} & \ \end{tabular} \end{table}")
"\begin{table}
abular}{l l} & \ \end{tabular}
le}"
```
#### post_process_generation[[transformers.NougatTokenizer.post_process_generation]]
```python
post_process_generation(generation: str | list[str], fix_markdown: bool = True, num_workers: int | None = None)
```
[Source](https://github.com/huggingface/transformers/blob/main/src/transformers/models/nougat/tokenization_nougat.py#L623)
**Paramètres :**
generation (Union[str, list[str]]) : le texte généré ou une liste de textes générés.
fix_markdown (`bool`, *facultatif*, par défaut `True`) : Indique s'il faut effectuer des corrections de formatage Markdown.
num_workers (`int`, *facultatif*) : Nombre facultatif de workers à transmettre pour exploiter le multiprocessing (post-traitement de plusieurs textes en parallèle).
**Retourne :** Union[str, list[str]]
Le texte post-traité ou la liste de textes post-traités.
Post-traitez un texte généré ou une liste de textes générés.
Cette fonction peut être utilisée pour effectuer un post-traitement sur le texte généré, par exemple pour corriger le formatage Markdown.
Le post-traitement est assez lent, il est donc recommandé d'utiliser le multiprocessing pour accélérer le processus.
#### post_process_single[[transformers.NougatTokenizer.post_process_single]]
```python
post_process_single(generation: str, fix_markdown: bool = True)
```
[Source](https://github.com/huggingface/transformers/blob/main/src/transformers/models/nougat/tokenization_nougat.py#L528)
**Paramètres :**
generation (str) : le texte généré à post-traiter.
fix_markdown (bool, optionnel) : Indique s'il faut effectuer des corrections de formatage Markdown. La valeur par défaut est True.
**Retourne :** `str`
Le texte post-traité.
Post-traite un texte généré unique. Les expressions régulières utilisées ici sont reprises directement des auteurs de l’article Nougat. Ces expressions sont commentées pour plus de clarté et testées de bout en bout dans la plupart des cas.
#### remove_hallucinated_references[[transformers.NougatTokenizer.remove_hallucinated_references]]
```python
remove_hallucinated_references(text: str)
```
[Source](https://github.com/huggingface/transformers/blob/main/src/transformers/models/nougat/tokenization_nougat.py#L463)
**Paramètres :**
text (`str`) : le texte d'entrée contenant des références.
**Retourne :** `str`
Le texte avec les références hallucinées supprimées.
Supprimez les références hallucinées ou manquantes du texte.
Cette fonction identifie et supprime les références marquées comme manquantes ou hallucinées dans le texte d'entrée.
## NougatProcessor[[transformers.NougatProcessor]]
#### transformers.NougatProcessor[[transformers.NougatProcessor]]
```python
transformers.NougatProcessor(image_processor, tokenizer)
```
[Source](https://github.com/huggingface/transformers/blob/main/src/transformers/models/nougat/processing_nougat.py#L37)
**Paramètres :**
image_processor (`NougatImageProcessor`) : le processeur d'images est une entrée obligatoire.
tokenizer (`NougatTokenizer`) : le tokenizer est une entrée obligatoire.
Construit un NougatProcessor qui encapsule un processeur d’images et un tokenizer en un seul processeur.
[NougatProcessor](/docs/transformers/main/fr/model_doc/nougat#transformers.NougatProcessor) offre toutes les fonctionnalités de [NougatImageProcessor](/docs/transformers/main/fr/model_doc/nougat#transformers.NougatImageProcessor) et de [NougatTokenizer](/docs/transformers/main/fr/model_doc/nougat#transformers.NougatTokenizer). Consultez [~NougatImageProcessor](/docs/transformers/main/fr/model_doc/nougat#transformers.NougatImageProcessor) et [~NougatTokenizer](/docs/transformers/main/fr/model_doc/nougat#transformers.NougatTokenizer) pour plus d’informations.
#### __appel__[[transformers.NougatProcessor.__call__]]
```python
__call__(images = None, text = None, **kwargs)
```
[Source](https://github.com/huggingface/transformers/blob/main/src/transformers/models/nougat/processing_nougat.py#L43)
**Paramètres :**
images (``) : Image to preprocess. Expects a single or batch of images with pixel values ranging from 0 to 255. If passing in images with pixel values between 0 and 1, set `do_rescale=False`.
text (``) : The sequence or batch of sequences to be encoded. Each sequence can be a string or a list of strings (pretokenized string). If you pass a pretokenized input, set `is_split_into_words=True` to avoid ambiguity with batched inputs.
return_tensors (`str` ou [TensorType](/docs/transformers/main/fr/internal/file_utils#transformers.TensorType), *facultatif*) : Si défini, renverra des tenseurs d'un framework particulier. Les valeurs acceptables sont : - `'pt'` : Renvoie des objets `torch.Tensor` de PyTorch. - `'np'` : Renvoie des objets `np.ndarray` de NumPy.
#### from_pretrained[[transformers.NougatProcessor.from_pretrained]]
```python
from_pretrained(pretrained_model_name_or_path: str | os.PathLike, cache_dir: str | os.PathLike | None = None, force_download: bool = False, local_files_only: bool = False, token: str | bool | None = None, revision: str = 'main', **kwargs)
```
[Source](https://github.com/huggingface/transformers/blob/main/src/transformers/processing_utils.py#L1750)
**Paramètres :**
pretrained_model_name_or_path (`str` or `os.PathLike`) : This can be either: - a string, the *model id* of a pretrained feature_extractor hosted inside a model repo on huggingface.co. - a path to a *directory* containing a feature extractor file saved using the [save_pretrained()](/docs/transformers/main/fr/main_classes/feature_extractor#transformers.FeatureExtractionMixin.save_pretrained) method, e.g., `./my_model_directory/`. - a path to a saved feature extractor JSON *file*, e.g., `./my_model_directory/preprocessor_config.json`.
- ****kwargs** : Arguments supplémentaires passés à la fois à [from_pretrained()](/docs/transformers/main/fr/main_classes/feature_extractor#transformers.FeatureExtractionMixin.from_pretrained) et à `~tokenization_utils_base.PreTrainedTokenizer.from_pretrained`.
Instanciez un processeur associé à un modèle pré-entraîné.
Cette méthode de classe appelle simplement la méthode [from_pretrained()](/docs/transformers/main/fr/main_classes/feature_extractor#transformers.FeatureExtractionMixin.from_pretrained) de l'extracteur de caractéristiques, le processeur d'images [ImageProcessingMixin](/docs/transformers/main/fr/internal/image_processing_utils#transformers.ImageProcessingMixin) et la méthode `~tokenization_utils_base.PreTrainedTokenizer.from_pretrained` du tokeniseur. Veuillez consulter les docstrings des méthodes ci-dessus pour plus d'informations.
#### save_pretrained[[transformers.NougatProcessor.save_pretrained]]
```python
save_pretrained(save_directory, push_to_hub: bool = False, **kwargs)
```
[Source](https://github.com/huggingface/transformers/blob/main/src/transformers/processing_utils.py#L1165)
**Paramètres :**
save_directory (`str` ou `os.PathLike`) : répertoire où le fichier JSON de l'extracteur de caractéristiques et les fichiers du tokenizer seront enregistrés (le répertoire sera créé s'il n'existe pas).
push_to_hub (`bool`, *facultatif*, valeur par défaut `False`) : Indique s'il faut ou non publier votre modèle sur le Hugging Face model hub après l'avoir enregistré. Vous pouvez spécifier le dépôt de destination avec `repo_id` (par défaut, il s'agit du nom de `save_directory` dans votre espace de noms).
kwargs (`dict[str, Any]`, *facultatif*) : Arguments supplémentaires par mot-clé transmis à la méthode [push_to_hub()](/docs/transformers/main/fr/main_classes/model#transformers.utils.PushToHubMixin.push_to_hub).
Enregistre les attributs de ce processeur (extracteur de caractéristiques, tokeniseur...) dans le répertoire spécifié afin qu'il puisse être rechargé à l'aide de la méthode [from_pretrained()](/docs/transformers/main/fr/model_doc/wav2vec2#transformers.Wav2Vec2Processor.from_pretrained).
Cette méthode de classe appelle simplement [save_pretrained()](/docs/transformers/main/fr/main_classes/feature_extractor#transformers.FeatureExtractionMixin.save_pretrained) et [save_pretrained()](/docs/transformers/main/fr/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.save_pretrained). Veuillez consulter les docstrings des méthodes ci-dessus pour plus d’informations.
#### batch_decode[[transformers.NougatProcessor.batch_decode]]
```python
batch_decode(*args, **kwargs)
```
[Source](https://github.com/huggingface/transformers/blob/main/src/transformers/processing_utils.py#L2005)
Cette méthode transmet tous ses arguments à [batch_decode()](/docs/transformers/main/fr/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.batch_decode) de PreTrainedTokenizer. Veuillez consulter la docstring de cette méthode pour plus d'informations.
#### decode[[transformers.NougatProcessor.decode]]
```python
decode(*args, **kwargs)
```
[Source](https://github.com/huggingface/transformers/blob/main/src/transformers/processing_utils.py#L2014)
Cette méthode transmet tous ses arguments à [decode()](/docs/transformers/main/fr/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.decode) de PreTrainedTokenizer. Veuillez consulter la docstring de cette méthode pour plus d'informations.
#### post_process_generation[[transformers.NougatProcessor.post_process_generation]]
```python
post_process_generation(*args, **kwargs)
```
[Source](https://github.com/huggingface/transformers/blob/main/src/transformers/models/nougat/processing_nougat.py#L51)
Cette méthode transmet tous ses arguments à `~PreTrainedTokenizer.post_process_generation` de NougatTokenizer. Veuillez consulter la docstring de cette méthode pour plus d'informations.