# Deformable DETR
يحسّن [Deformable DETR](https://huggingface.co/papers/2010.04159) على [DETR](./detr) الأصلي من خلال استخدام وحدة انتباه قابلة للتشوه. يركّز هذا الآلية الانتباه بشكل انتقائي على مجموعة صغيرة من نقاط العينة الرئيسية المحيطة بنقطة مرجعية. كما يحسّن سرعة التدريب ويحسّن الدقة.
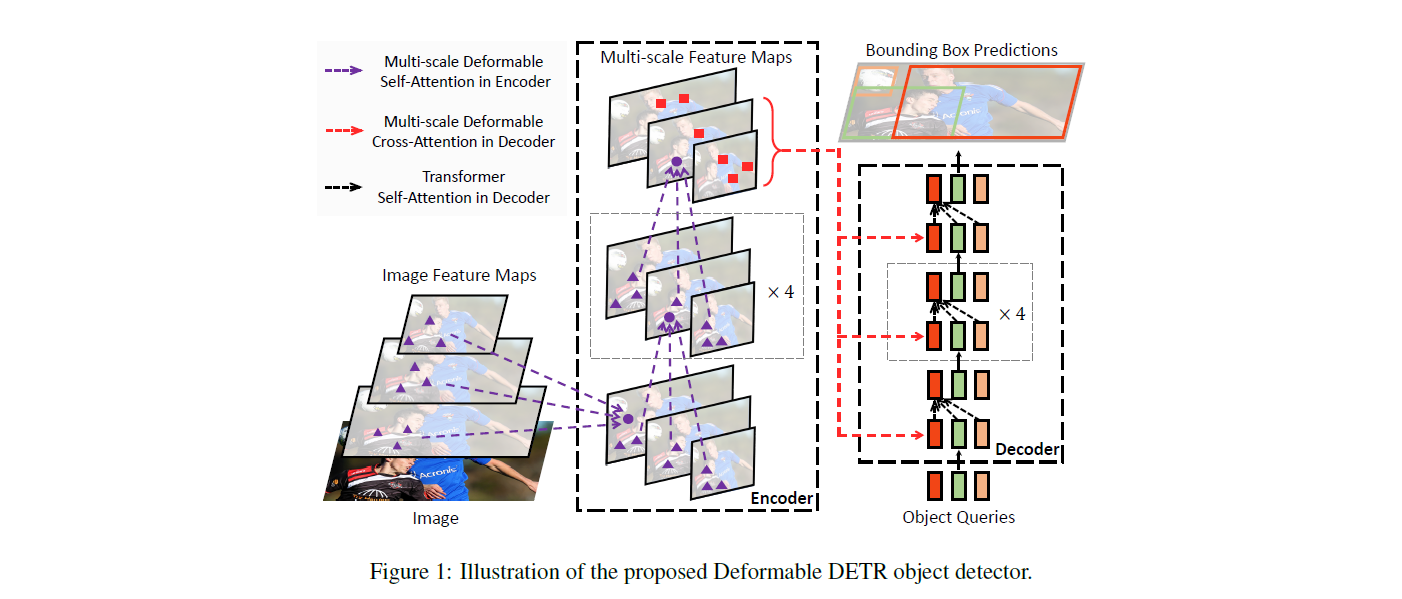 بنية Deformable DETR. مأخوذة من الورقة الأصلية.
يمكنك العثور على جميع نقاط التفتيش المتاحة لنموذج Deformable DETR تحت منظمة [SenseTime](https://huggingface.co/SenseTime).
> [!TIP]
> تمت مساهمة هذا النموذج من قِبل [nielsr](https://huggingface.co/nielsr).
>
> انقر على نماذج Deformable DETR في الشريط الجانبي الأيمن لمزيد من الأمثلة حول كيفية تطبيق Deformable DETR على مهام مختلفة للكشف عن الأشياء والتجزئة.
يُظهر المثال أدناه كيفية تنفيذ كشف الكائنات باستخدام [Pipeline](/docs/transformers/main/ar/main_classes/pipelines#transformers.Pipeline) وفئة [AutoModel](/docs/transformers/main/ar/model_doc/auto#transformers.AutoModel).
```python
from transformers import pipeline
pipeline = pipeline(
"object-detection",
model="SenseTime/deformable-detr",
device_map=0
)
pipeline("http://images.cocodataset.org/val2017/000000039769.jpg")
```
```python
import requests
import torch
from PIL import Image
from transformers import AutoImageProcessor, AutoModelForObjectDetection
url = "http://images.cocodataset.org/val2017/000000039769.jpg"
image = Image.open(requests.get(url, stream=True).raw)
image_processor = AutoImageProcessor.from_pretrained("SenseTime/deformable-detr")
model = AutoModelForObjectDetection.from_pretrained("SenseTime/deformable-detr", device_map="auto")
# prepare image for the model
inputs = image_processor(images=image, return_tensors="pt").to(model.device)
with torch.no_grad():
outputs = model(**inputs)
results = image_processor.post_process_object_detection(outputs, target_sizes=torch.tensor([image.size[::-1]]), threshold=0.3)
for result in results:
for score, label_id, box in zip(result["scores"], result["labels"], result["boxes"]):
score, label = score.item(), label_id.item()
box = [round(i, 2) for i in box.tolist()]
print(f"{model.config.id2label[label]}: {score:.2f} {box}")
```
## الموارد
- راجع مجموعة [دفاتر الملاحظات](https://github.com/NielsRogge/Transformers-Tutorials/tree/master/Deformable-DETR) هذه للاستدلال وضبط [DeformableDetrForObjectDetection](/docs/transformers/main/ar/model_doc/deformable_detr#transformers.DeformableDetrForObjectDetection) على مجموعة بيانات مخصصة.
## DeformableDetrImageProcessor[[transformers.DeformableDetrImageProcessor]]
#### transformers.DeformableDetrImageProcessor[[transformers.DeformableDetrImageProcessor]]
```python
transformers.DeformableDetrImageProcessor(**kwargs: *)
```
[المصدر](https://github.com/huggingface/transformers/blob/main/src/transformers/models/deformable_detr/image_processing_deformable_detr.py#L271)
**المعاملات:**
do_convert_rgb (`bool`، *kwargs*، *اختياري*) : ما إذا كان يجب تحويل الصورة إلى RGB.
do_resize (`bool`، *kwargs*، *اختياري*، الافتراضي هو `True`) : ما إذا كان سيتم تغيير حجم الصورة.
size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`، *kwargs*، القيمة الافتراضية `{'shortest_edge' : 800, 'longest_edge': 1333}`): يصف الأبعاد القصوى للإدخال إلى النموذج.
default_to_square (`bool`، *kwargs*، *اختياري*، الافتراضي `False`) : ما إذا كان سيتم افتراض صورة مربعة عند تغيير الحجم، إذا كان size من نوع int.
crop_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`، *kwargs*) : حجم الصورة الناتجة بعد تطبيق `center_crop`.
resample (`Annotated[Union[int, PILImageResampling, NoneType], None]`، *kwargs*، القيمة الافتراضية `2`) : مرشح إعادة العينة المستخدم عند تغيير حجم الصورة. يمكن أن يكون أحد قيم التعداد `PILImageResampling`. لا يؤثر إلا إذا كانت قيمة `do_resize` هي `True`.
do_rescale (`bool`، *kwargs*، *اختياري*، القيمة الافتراضية `True`) : ما إذا كان يجب إعادة تحجيم الصورة.
rescale_factor (`float`، *kwargs*، *اختياري*، القيمة الافتراضية هي `0.00392156862745098`) : عامل إعادة التحجيم لإعادة تحجيم الصورة إذا كان `do_rescale` مضبوطاً على `True`.
do_normalize (`bool`، *kwargs*، *اختياري*، القيمة الافتراضية `True`) : ما إذا كان سيتم تطبيع الصورة.
image_mean (`Union[float, list[float], tuple[float, ...]]`، *kwargs*، *اختياري*، القيمة الافتراضية `[0.485, 0.456, 0.406]`) : متوسط الصورة المستخدم للتطبيع. لا يكون له أي تأثير إلا إذا تم تعيين `do_normalize` إلى `True`.
image_std (`Union[float, list[float], tuple[float, ...]]`، *kwargs*، *اختياري*، القيمة الافتراضية `[0.229, 0.224, 0.225]`) : الانحراف المعياري للصورة المستخدم للتطبيع. لا يكون له تأثير إلا إذا تم تعيين `do_normalize` إلى `True`.
do_pad (`bool`، *kwargs*، *اختياري*، القيمة الافتراضية `True`) : ما إذا كان سيتم إضافة حشوة إلى الصورة. تتم الحشوة إما إلى أكبر حجم في الدفعة أو إلى حجم مربع ثابت لكل صورة. تعتمد استراتيجية الحشوة الدقيقة على النموذج.
pad_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : الحجم على شكل `{"height": int, "width" int}` الذي يجب توسيد الصور إليه. يجب أن يكون أكبر من أي حجم صورة مُقدَّم للمعالجة المسبقة. إذا لم يُقدَّم `pad_size`، فسيتم توسيد الصور إلى أكبر ارتفاع وعرض في الدفعة. يُطبَّق فقط عندما يكون `do_pad=True.`
do_center_crop (`bool`، *kwargs*، *اختياري*) : ما إذا كان يجب قص الصورة من المنتصف.
data_format (`Union[str, ~image_utils.ChannelDimension]`، *kwargs*، *اختياري*) : يُدعم `ChannelDimension.FIRST` فقط. أُضيف من أجل التوافق مع المعالجات البطيئة.
input_data_format (`Union[str, ~image_utils.ChannelDimension]`، *kwargs*، *اختياري*) : تنسيق بُعد القناة للصورة المدخلة. إذا لم يتم ضبطه، يُستنتج تنسيق بُعد القناة من الصورة المدخلة. يمكن أن يكون أحد ما يلي: - `"channels_first"` أو `ChannelDimension.FIRST`: صورة بتنسيق (num_channels, height, width). - `"channels_last"` أو `ChannelDimension.LAST`: صورة بتنسيق (height, width, num_channels). - `"none"` أو `ChannelDimension.NONE`: صورة بتنسيق (height, width).
device (`Annotated[Union[str, torch.device, NoneType], None]`, *kwargs*) : الجهاز الذي تتم عليه معالجة مقاطع الفيديو. إذا لم يتم ضبطه، يُستنتج الجهاز من مقاطع الفيديو المدخلة.
return_tensors (`Annotated[str | ~utils.generic.TensorType | None, None]`, *kwargs*) : تُرجع توتنرات مكدّسة إذا كان الإعداد `'pt'`، وإلا تُرجع قائمة من التوتنرات.
disable_grouping (`bool`، *kwargs*، *اختياري*) : ما إذا كان سيتم تعطيل تجميع الصور حسب الحجم لمعالجتها بشكل فردي بدلاً من دفعات. إذا كانت القيمة None، فسيتم تعيينها إلى True إذا كانت الصور على وحدة المعالجة المركزية (CPU)، وإلا فستكون False. تستند هذه الخيارات إلى ملاحظات تجريبية، كما هو موضح هنا: https://github.com/huggingface/transformers/pull/38157
image_seq_length (`int`، *kwargs*، *اختياري*) : عدد رموز الصور التي سيتم استخدامها لكل صورة في المدخلات. أُضيفت لضمان التوافق مع الإصدارات السابقة، لكن ينبغي ضبطها كخاصية للمعالج في النماذج المستقبلية.
format (`str`، *kwargs*، *اختياري*، القيمة الافتراضية هي `AnnotationFormat.COCO_DETECTION`) : تنسيق بيانات التسميات. أحد "coco_detection" أو "coco_panoptic".
do_convert_annotations (`bool`، *kwargs*، *اختياري*، القيمة الافتراضية `True`) : يتحكم في ما إذا كان سيتم تحويل التعليقات التوضيحية إلى التنسيق المتوقع من قبل نموذج DEFORMABLE_DETR. يقوم بتحويل صناديق الحدود إلى التنسيق `(center_x, center_y, width, height)` وفي النطاق `[0, 1]`. يمكن تجاوز ذلك بواسطة معامل `do_convert_annotations` في طريقة `preprocess`.
ينشئ معالج صور DeformableDetrImageProcessor.
#### preprocess[[transformers.DeformableDetrImageProcessor.preprocess]]
```python
preprocess(images: typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor']], annotations: dict[str, int | str | list[dict]] | list[dict[str, int | str | list[dict]]] | None = None, return_segmentation_masks: bool | None = None, masks_path: str | pathlib.Path | None = None, **kwargs: *)
```
[المصدر](https://github.com/huggingface/transformers/blob/main/src/transformers/models/deformable_detr/image_processing_deformable_detr.py#L526)
**المعاملات:**
images (`Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor]]`) : الصورة المراد معالجتها مسبقًا. يتوقع صورة واحدة أو دفعة من الصور بقيم بكسل تتراوح بين 0 و255. إذا كنت تمرر صورًا بقيم بكسل بين 0 و1، فاضبط `do_rescale=False`.
annotations (`AnnotationType` أو `list[AnnotationType]`، *اختياري*) : التسميات التي سيتم تحويلها وفقًا للتعبئة المطبقة على الصور.
return_segmentation_masks (`bool`، *اختياري*، الافتراضي `self.return_segmentation_masks`) : ما إذا كان يجب إرجاع أقنعة التقسيم.
masks_path (`str` أو `pathlib.Path`، *اختياري*) : المسار إلى المجلد الذي يحتوي على أقنعة التقسيم.
do_convert_rgb (`bool`، *kwargs*، *اختياري*) : ما إذا كان يجب تحويل الصورة إلى RGB.
do_resize (`bool`، *kwargs*، *اختياري*) : ما إذا كان يجب تغيير حجم الصورة.
size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : يصف الأبعاد القصوى للمدخلات إلى النموذج.
default_to_square (`bool`، *kwargs*، *اختياري*) : ما إذا كان يجب افتراض صورة مربعة عند تغيير الحجم، إذا كان الحجم عددًا صحيحًا.
crop_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`، *kwargs*) : حجم الصورة الناتجة بعد تطبيق `center_crop`.
resample (`Annotated[Union[int, PILImageResampling, NoneType], None]`, *kwargs*) : مرشح إعادة العينة المستخدم عند تغيير حجم الصورة. يمكن أن يكون أحد قيم enum `PILImageResampling`. لا يؤثر إلا إذا كان `do_resize` مضبوطاً على `True`.
do_rescale (`bool`، *kwargs*، *اختياري*) : ما إذا كان يجب إعادة تحجيم الصورة.
rescale_factor (`float`، *kwargs*، *اختياري*) : معامل إعادة التحجيم لإعادة تحجيم الصورة إذا كان `do_rescale` مضبوطًا على `True`.
do_normalize (`bool`، *kwargs*، *اختياري*) : ما إذا كان يجب تطبيع الصورة.
image_mean (`Union[float, list[float], tuple[float, ...]]`، *kwargs*، *اختياري*) : متوسط الصورة المستخدم للتطبيع. لا يكون له أي تأثير إلا إذا تم تعيين `do_normalize` إلى `True`.
image_std (`Union[float, list[float], tuple[float, ...]]`، *kwargs*، *اختياري*) : الانحراف المعياري للصورة المستخدم للتطبيع. لا يكون له أي تأثير إلا إذا تم تعيين `do_normalize` إلى `True`.
do_pad (`bool`، *kwargs*، *اختياري*) : ما إذا كان يجب إضافة حشوة إلى الصورة. يتم تنفيذ الحشوة إما إلى أكبر حجم في الدفعة أو إلى حجم مربع ثابت لكل صورة. تعتمد استراتيجية الحشوة الدقيقة على النموذج.
pad_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : الحجم على شكل `{"height": int, "width" int}` الذي يجب توسيد الصور إليه. يجب أن يكون أكبر من أي حجم صورة مُقدَّم للمعالجة المسبقة. إذا لم يُقدَّم `pad_size`، فسيتم توسيد الصور إلى أكبر ارتفاع وعرض في الدفعة. يُطبَّق فقط عندما يكون `do_pad=True.`
do_center_crop (`bool`، *kwargs*، *اختياري*) : ما إذا كان يجب قص الصورة من المنتصف.
data_format (`Union[str, ~image_utils.ChannelDimension]`، *kwargs*، *اختياري*) : يُدعم `ChannelDimension.FIRST` فقط. أُضيف من أجل التوافق مع المعالجات البطيئة.
input_data_format (`Union[str, ~image_utils.ChannelDimension]`، *kwargs*، *اختياري*) : تنسيق بُعد القناة للصورة المدخلة. إذا لم يتم ضبطه، يُستنتج تنسيق بُعد القناة من الصورة المدخلة. يمكن أن يكون أحد ما يلي: - `"channels_first"` أو `ChannelDimension.FIRST`: صورة بتنسيق (num_channels, height, width). - `"channels_last"` أو `ChannelDimension.LAST`: صورة بتنسيق (height, width, num_channels). - `"none"` أو `ChannelDimension.NONE`: صورة بتنسيق (height, width).
device (`Annotated[Union[str, torch.device, NoneType], None]`, *kwargs*) : الجهاز الذي تتم عليه معالجة مقاطع الفيديو. إذا لم يتم ضبطه، يُستنتج الجهاز من مقاطع الفيديو المدخلة.
return_tensors (`Annotated[str | ~utils.generic.TensorType | None, None]`, *kwargs*) : تُرجع توتنرات مكدّسة إذا كان الإعداد `'pt'`، وإلا تُرجع قائمة من التوتنرات.
disable_grouping (`bool`، *kwargs*، *اختياري*) : ما إذا كان سيتم تعطيل تجميع الصور حسب الحجم لمعالجتها بشكل فردي بدلاً من دفعات. إذا كانت القيمة None، فسيتم تعيينها إلى True إذا كانت الصور على وحدة المعالجة المركزية (CPU)، وإلا فستكون False. تستند هذه الخيارات إلى ملاحظات تجريبية، كما هو موضح هنا: https://github.com/huggingface/transformers/pull/38157
image_seq_length (`int`، *kwargs*، *اختياري*) : عدد رموز الصور التي سيتم استخدامها لكل صورة في المدخلات. أُضيفت لضمان التوافق مع الإصدارات السابقة، لكن ينبغي ضبطها كخاصية للمعالج في النماذج المستقبلية.
format (`str`، *kwargs*، *اختياري*، القيمة الافتراضية هي `AnnotationFormat.COCO_DETECTION`) : تنسيق بيانات التسميات. أحد "coco_detection" أو "coco_panoptic".
do_convert_annotations (`bool`، *kwargs*، *اختياري*، القيمة الافتراضية `True`) : يتحكم في ما إذا كان سيتم تحويل التعليقات التوضيحية إلى التنسيق المتوقع من قبل نموذج DEFORMABLE_DETR. يقوم بتحويل صناديق الحدود إلى التنسيق `(center_x, center_y, width, height)` وفي النطاق `[0, 1]`. يمكن تجاوز ذلك بواسطة معامل `do_convert_annotations` في طريقة `preprocess`.
**يعيد:** `~image_processing_base.BatchFeature`
- **data** (`dict`) -- قاموس من القوائم/المصفوفات/الموترات التي يعيدها أسلوب __call__ ('pixel_values'، وما إلى ذلك).
- **tensor_type** (`Union[None, str, TensorType]`، *اختياري*) -- يمكنك تحديد tensor_type هنا لتحويل قوائم الأعداد الصحيحة إلى تينسورات PyTorch/Numpy عند التهيئة.
#### post_process_object_detection[[transformers.DeformableDetrImageProcessor.post_process_object_detection]]
```python
post_process_object_detection(outputs, threshold: float = 0.5, target_sizes: transformers.utils.generic.TensorType | list[tuple] = None, top_k: int = 100)
```
[المصدر](https://github.com/huggingface/transformers/blob/main/src/transformers/models/deformable_detr/image_processing_deformable_detr.py#L667)
**المعاملات:**
outputs (`DetrObjectDetectionOutput`) : المخرجات الخام للنموذج.
threshold (`float`، *اختياري*) : عتبة التقييم للاحتفاظ بتوقعات كشف الكائنات.
target_sizes (`torch.Tensor` أو `list[tuple[int, int]]`، *اختياري*) : متجه (Tensor) بأبعاد `(batch_size, 2)` أو قائمة من الأزواج (`tuple[int, int]`) تحتوي على الحجم المستهدف (الارتفاع، العرض) لكل صورة في الدفعة. إذا تُركت القيمة None، فلن يتم تغيير حجم التنبؤات.
top_k (`int`، *اختياري*، القيمة الافتراضية 100) : الإبقاء على صناديق الحدود العلوية k فقط قبل التصفية عن طريق تحديد العتبة.
**يعيد:** `list[Dict]`
قائمة من القواميس، حيث يحتوي كل قاموس على الدرجات والوسوم والمربعات لصورة في الدفعة كما تتنبأ بها النموذج.
يحوّل المخرجات الخام لـ [DeformableDetrForObjectDetection](/docs/transformers/main/ar/model_doc/deformable_detr#transformers.DeformableDetrForObjectDetection) إلى صناديق حدود نهائية بصيغة (top_left_x, top_left_y, bottom_right_x, bottom_right_y). يدعم PyTorch فقط.
## DeformableDetrImageProcessorPil[[transformers.DeformableDetrImageProcessorPil]]
#### transformers.DeformableDetrImageProcessorPil[[transformers.DeformableDetrImageProcessorPil]]
```python
transformers.DeformableDetrImageProcessorPil(**kwargs: *)
```
[المصدر](https://github.com/huggingface/transformers/blob/main/src/transformers/models/deformable_detr/image_processing_pil_deformable_detr.py#L263)
**المعاملات:**
do_convert_rgb (`bool`، *kwargs*، *اختياري*) : ما إذا كان يجب تحويل الصورة إلى RGB.
do_resize (`bool`، *kwargs*، *اختياري*، الافتراضي هو `True`) : ما إذا كان سيتم تغيير حجم الصورة.
size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`، *kwargs*، القيمة الافتراضية `{'shortest_edge' : 800, 'longest_edge': 1333}`): يصف الأبعاد القصوى للإدخال إلى النموذج.
default_to_square (`bool`، *kwargs*، *اختياري*، الافتراضي `False`) : ما إذا كان سيتم افتراض صورة مربعة عند تغيير الحجم، إذا كان size من نوع int.
crop_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`، *kwargs*) : حجم الصورة الناتجة بعد تطبيق `center_crop`.
resample (`Annotated[Union[int, PILImageResampling, NoneType], None]`، *kwargs*، القيمة الافتراضية `2`) : مرشح إعادة العينة المستخدم عند تغيير حجم الصورة. يمكن أن يكون أحد قيم التعداد `PILImageResampling`. لا يؤثر إلا إذا كانت قيمة `do_resize` هي `True`.
do_rescale (`bool`، *kwargs*، *اختياري*، القيمة الافتراضية `True`) : ما إذا كان يجب إعادة تحجيم الصورة.
rescale_factor (`float`، *kwargs*، *اختياري*، القيمة الافتراضية هي `0.00392156862745098`) : عامل إعادة التحجيم لإعادة تحجيم الصورة إذا كان `do_rescale` مضبوطاً على `True`.
do_normalize (`bool`، *kwargs*، *اختياري*، القيمة الافتراضية `True`) : ما إذا كان سيتم تطبيع الصورة.
image_mean (`Union[float, list[float], tuple[float, ...]]`، *kwargs*، *اختياري*، القيمة الافتراضية `[0.485, 0.456, 0.406]`) : متوسط الصورة المستخدم للتطبيع. لا يكون له أي تأثير إلا إذا تم تعيين `do_normalize` إلى `True`.
image_std (`Union[float, list[float], tuple[float, ...]]`، *kwargs*، *اختياري*، القيمة الافتراضية `[0.229, 0.224, 0.225]`) : الانحراف المعياري للصورة المستخدم للتطبيع. لا يكون له تأثير إلا إذا تم تعيين `do_normalize` إلى `True`.
do_pad (`bool`، *kwargs*، *اختياري*، القيمة الافتراضية `True`) : ما إذا كان سيتم إضافة حشوة إلى الصورة. تتم الحشوة إما إلى أكبر حجم في الدفعة أو إلى حجم مربع ثابت لكل صورة. تعتمد استراتيجية الحشوة الدقيقة على النموذج.
pad_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : الحجم على شكل `{"height": int, "width" int}` الذي يجب توسيد الصور إليه. يجب أن يكون أكبر من أي حجم صورة مُقدَّم للمعالجة المسبقة. إذا لم يُقدَّم `pad_size`، فسيتم توسيد الصور إلى أكبر ارتفاع وعرض في الدفعة. يُطبَّق فقط عندما يكون `do_pad=True.`
do_center_crop (`bool`، *kwargs*، *اختياري*) : ما إذا كان يجب قص الصورة من المنتصف.
data_format (`Union[str, ~image_utils.ChannelDimension]`، *kwargs*، *اختياري*) : يُدعم `ChannelDimension.FIRST` فقط. أُضيف من أجل التوافق مع المعالجات البطيئة.
input_data_format (`Union[str, ~image_utils.ChannelDimension]`، *kwargs*، *اختياري*) : تنسيق بُعد القناة للصورة المدخلة. إذا لم يتم ضبطه، يُستنتج تنسيق بُعد القناة من الصورة المدخلة. يمكن أن يكون أحد ما يلي: - `"channels_first"` أو `ChannelDimension.FIRST`: صورة بتنسيق (num_channels, height, width). - `"channels_last"` أو `ChannelDimension.LAST`: صورة بتنسيق (height, width, num_channels). - `"none"` أو `ChannelDimension.NONE`: صورة بتنسيق (height, width).
device (`Annotated[Union[str, torch.device, NoneType], None]`, *kwargs*) : الجهاز الذي تتم عليه معالجة مقاطع الفيديو. إذا لم يتم ضبطه، يُستنتج الجهاز من مقاطع الفيديو المدخلة.
return_tensors (`Annotated[str | ~utils.generic.TensorType | None, None]`, *kwargs*) : تُرجع توتنرات مكدّسة إذا كان الإعداد `'pt'`، وإلا تُرجع قائمة من التوتنرات.
disable_grouping (`bool`، *kwargs*، *اختياري*) : ما إذا كان سيتم تعطيل تجميع الصور حسب الحجم لمعالجتها بشكل فردي بدلاً من دفعات. إذا كانت القيمة None، فسيتم تعيينها إلى True إذا كانت الصور على وحدة المعالجة المركزية (CPU)، وإلا فستكون False. تستند هذه الخيارات إلى ملاحظات تجريبية، كما هو موضح هنا: https://github.com/huggingface/transformers/pull/38157
image_seq_length (`int`، *kwargs*، *اختياري*) : عدد رموز الصور التي سيتم استخدامها لكل صورة في المدخلات. أُضيفت لضمان التوافق مع الإصدارات السابقة، لكن ينبغي ضبطها كخاصية للمعالج في النماذج المستقبلية.
format (`str`، *kwargs*، *اختياري*، القيمة الافتراضية هي `AnnotationFormat.COCO_DETECTION`) : تنسيق بيانات التسميات. أحد "coco_detection" أو "coco_panoptic".
do_convert_annotations (`bool`، *kwargs*، *اختياري*، القيمة الافتراضية `True`) : يتحكم في ما إذا كان سيتم تحويل التعليقات التوضيحية إلى التنسيق المتوقع من قبل نموذج DEFORMABLE_DETR. يقوم بتحويل صناديق الحدود إلى التنسيق `(center_x, center_y, width, height)` وفي النطاق `[0, 1]`. يمكن تجاوز ذلك بواسطة معامل `do_convert_annotations` في طريقة `preprocess`.
ينشئ معالج صور DeformableDetrImageProcessor.
#### preprocess[[transformers.DeformableDetrImageProcessorPil.preprocess]]
```python
preprocess(images: typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor']], annotations: dict[str, int | str | list[dict]] | list[dict[str, int | str | list[dict]]] | None = None, return_segmentation_masks: bool | None = None, masks_path: str | pathlib.Path | None = None, **kwargs: *)
```
[المصدر](https://github.com/huggingface/transformers/blob/main/src/transformers/models/deformable_detr/image_processing_pil_deformable_detr.py#L531)
**المعاملات:**
images (`Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor]]`) : الصورة المراد معالجتها مسبقًا. يتوقع صورة واحدة أو دفعة من الصور بقيم بكسل تتراوح بين 0 و255. إذا كنت تمرر صورًا بقيم بكسل بين 0 و1، فاضبط `do_rescale=False`.
annotations (`AnnotationType` أو `list[AnnotationType]`، *اختياري*) : التسميات التي سيتم تحويلها وفقًا للتعبئة المطبقة على الصور.
return_segmentation_masks (`bool`، *اختياري*، الافتراضي `self.return_segmentation_masks`) : ما إذا كان يجب إرجاع أقنعة التقسيم.
masks_path (`str` أو `pathlib.Path`، *اختياري*) : المسار إلى المجلد الذي يحتوي على أقنعة التقسيم.
do_convert_rgb (`bool`، *kwargs*، *اختياري*) : ما إذا كان يجب تحويل الصورة إلى RGB.
do_resize (`bool`، *kwargs*، *اختياري*) : ما إذا كان يجب تغيير حجم الصورة.
size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : يصف الأبعاد القصوى للمدخلات إلى النموذج.
default_to_square (`bool`، *kwargs*، *اختياري*) : ما إذا كان يجب افتراض صورة مربعة عند تغيير الحجم، إذا كان الحجم عددًا صحيحًا.
crop_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`، *kwargs*) : حجم الصورة الناتجة بعد تطبيق `center_crop`.
resample (`Annotated[Union[int, PILImageResampling, NoneType], None]`, *kwargs*) : مرشح إعادة العينة المستخدم عند تغيير حجم الصورة. يمكن أن يكون أحد قيم enum `PILImageResampling`. لا يؤثر إلا إذا كان `do_resize` مضبوطاً على `True`.
do_rescale (`bool`، *kwargs*، *اختياري*) : ما إذا كان يجب إعادة تحجيم الصورة.
rescale_factor (`float`، *kwargs*، *اختياري*) : معامل إعادة التحجيم لإعادة تحجيم الصورة إذا كان `do_rescale` مضبوطًا على `True`.
do_normalize (`bool`، *kwargs*، *اختياري*) : ما إذا كان يجب تطبيع الصورة.
image_mean (`Union[float, list[float], tuple[float, ...]]`، *kwargs*، *اختياري*) : متوسط الصورة المستخدم للتطبيع. لا يكون له أي تأثير إلا إذا تم تعيين `do_normalize` إلى `True`.
image_std (`Union[float, list[float], tuple[float, ...]]`، *kwargs*، *اختياري*) : الانحراف المعياري للصورة المستخدم للتطبيع. لا يكون له أي تأثير إلا إذا تم تعيين `do_normalize` إلى `True`.
do_pad (`bool`، *kwargs*، *اختياري*) : ما إذا كان يجب إضافة حشوة إلى الصورة. يتم تنفيذ الحشوة إما إلى أكبر حجم في الدفعة أو إلى حجم مربع ثابت لكل صورة. تعتمد استراتيجية الحشوة الدقيقة على النموذج.
pad_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : الحجم على شكل `{"height": int, "width" int}` الذي يجب توسيد الصور إليه. يجب أن يكون أكبر من أي حجم صورة مُقدَّم للمعالجة المسبقة. إذا لم يُقدَّم `pad_size`، فسيتم توسيد الصور إلى أكبر ارتفاع وعرض في الدفعة. يُطبَّق فقط عندما يكون `do_pad=True.`
do_center_crop (`bool`، *kwargs*، *اختياري*) : ما إذا كان يجب قص الصورة من المنتصف.
data_format (`Union[str, ~image_utils.ChannelDimension]`، *kwargs*، *اختياري*) : يُدعم `ChannelDimension.FIRST` فقط. أُضيف من أجل التوافق مع المعالجات البطيئة.
input_data_format (`Union[str, ~image_utils.ChannelDimension]`، *kwargs*، *اختياري*) : تنسيق بُعد القناة للصورة المدخلة. إذا لم يتم ضبطه، يُستنتج تنسيق بُعد القناة من الصورة المدخلة. يمكن أن يكون أحد ما يلي: - `"channels_first"` أو `ChannelDimension.FIRST`: صورة بتنسيق (num_channels, height, width). - `"channels_last"` أو `ChannelDimension.LAST`: صورة بتنسيق (height, width, num_channels). - `"none"` أو `ChannelDimension.NONE`: صورة بتنسيق (height, width).
device (`Annotated[Union[str, torch.device, NoneType], None]`, *kwargs*) : الجهاز الذي تتم عليه معالجة مقاطع الفيديو. إذا لم يتم ضبطه، يُستنتج الجهاز من مقاطع الفيديو المدخلة.
return_tensors (`Annotated[str | ~utils.generic.TensorType | None, None]`, *kwargs*) : تُرجع توتنرات مكدّسة إذا كان الإعداد `'pt'`، وإلا تُرجع قائمة من التوتنرات.
disable_grouping (`bool`، *kwargs*، *اختياري*) : ما إذا كان سيتم تعطيل تجميع الصور حسب الحجم لمعالجتها بشكل فردي بدلاً من دفعات. إذا كانت القيمة None، فسيتم تعيينها إلى True إذا كانت الصور على وحدة المعالجة المركزية (CPU)، وإلا فستكون False. تستند هذه الخيارات إلى ملاحظات تجريبية، كما هو موضح هنا: https://github.com/huggingface/transformers/pull/38157
image_seq_length (`int`، *kwargs*، *اختياري*) : عدد رموز الصور التي سيتم استخدامها لكل صورة في المدخلات. أُضيفت لضمان التوافق مع الإصدارات السابقة، لكن ينبغي ضبطها كخاصية للمعالج في النماذج المستقبلية.
format (`str`، *kwargs*، *اختياري*، القيمة الافتراضية هي `AnnotationFormat.COCO_DETECTION`) : تنسيق بيانات التسميات. أحد "coco_detection" أو "coco_panoptic".
do_convert_annotations (`bool`، *kwargs*، *اختياري*، القيمة الافتراضية `True`) : يتحكم في ما إذا كان سيتم تحويل التعليقات التوضيحية إلى التنسيق المتوقع من قبل نموذج DEFORMABLE_DETR. يقوم بتحويل صناديق الحدود إلى التنسيق `(center_x, center_y, width, height)` وفي النطاق `[0, 1]`. يمكن تجاوز ذلك بواسطة معامل `do_convert_annotations` في طريقة `preprocess`.
**يعيد:** `~image_processing_base.BatchFeature`
- **data** (`dict`) -- قاموس من القوائم/المصفوفات/الموترات التي يعيدها أسلوب __call__ ('pixel_values'، وما إلى ذلك).
- **tensor_type** (`Union[None, str, TensorType]`، *اختياري*) -- يمكنك تحديد tensor_type هنا لتحويل قوائم الأعداد الصحيحة إلى تينسورات PyTorch/Numpy عند التهيئة.
#### post_process_object_detection[[transformers.DeformableDetrImageProcessorPil.post_process_object_detection]]
```python
post_process_object_detection(outputs, threshold: float = 0.5, target_sizes: transformers.utils.generic.TensorType | list[tuple] = None, top_k: int = 100)
```
[المصدر](https://github.com/huggingface/transformers/blob/main/src/transformers/models/deformable_detr/image_processing_pil_deformable_detr.py#L676)
**المعاملات:**
outputs (`DetrObjectDetectionOutput`) : المخرجات الخام للنموذج.
threshold (`float`، *اختياري*) : عتبة التقييم للاحتفاظ بتوقعات كشف الكائنات.
target_sizes (`torch.Tensor` أو `list[tuple[int, int]]`، *اختياري*) : متجه (Tensor) بأبعاد `(batch_size, 2)` أو قائمة من الأزواج (`tuple[int, int]`) تحتوي على الحجم المستهدف (الارتفاع، العرض) لكل صورة في الدفعة. إذا تُركت القيمة None، فلن يتم تغيير حجم التنبؤات.
top_k (`int`، *اختياري*، القيمة الافتراضية 100) : الإبقاء على صناديق الحدود العلوية k فقط قبل التصفية عن طريق تحديد العتبة.
**يعيد:** `list[Dict]`
قائمة من القواميس، حيث يحتوي كل قاموس على الدرجات والوسوم والمربعات لصورة في الدفعة كما تتنبأ بها النموذج.
يحوّل المخرجات الخام لـ [DeformableDetrForObjectDetection](/docs/transformers/main/ar/model_doc/deformable_detr#transformers.DeformableDetrForObjectDetection) إلى صناديق حدود نهائية بصيغة (top_left_x, top_left_y, bottom_right_x, bottom_right_y). يدعم PyTorch فقط.
## DeformableDetrConfig[[transformers.DeformableDetrConfig]]
#### transformers.DeformableDetrConfig[[transformers.DeformableDetrConfig]]
```python
transformers.DeformableDetrConfig(transformers_version: str | None = None, architectures: list[str] | None = None, output_hidden_states: bool | None = False, return_dict: bool | None = True, dtype: str | torch.dtype | None = None, chunk_size_feed_forward: int = 0, id2label: dict[int, str] | dict[str, str] | None = None, label2id: dict[str, int] | dict[str, str] | None = None, problem_type: Literal['regression', 'single_label_classification', 'multi_label_classification'] | None = None, is_encoder_decoder: bool = True, backbone_config: dict | transformers.configuration_utils.PreTrainedConfig | None = None, num_channels: int = 3, num_queries: int = 300, max_position_embeddings: int = 1024, encoder_layers: int = 6, encoder_ffn_dim: int = 1024, encoder_attention_heads: int = 8, decoder_layers: int = 6, decoder_ffn_dim: int = 1024, decoder_attention_heads: int = 8, encoder_layerdrop: float | int = 0.0, activation_function: str = 'relu', d_model: int = 256, dropout: float | int = 0.1, attention_dropout: float | int = 0.0, activation_dropout: float | int = 0.0, init_std: float = 0.02, init_xavier_std: float = 1.0, return_intermediate: bool = True, auxiliary_loss: bool = False, position_embedding_type: str = 'sine', dilation: bool = False, num_feature_levels: int = 4, encoder_n_points: int = 4, decoder_n_points: int = 4, two_stage: bool = False, two_stage_num_proposals: int = 300, with_box_refine: bool = False, class_cost: int = 1, bbox_cost: int = 5, giou_cost: int = 2, mask_loss_coefficient: int = 1, dice_loss_coefficient: int = 1, bbox_loss_coefficient: int = 5, giou_loss_coefficient: int = 2, eos_coefficient: float = 0.1, focal_alpha: float = 0.25, disable_custom_kernels: bool = False, tie_word_embeddings: bool = True)
```
[المصدر](https://github.com/huggingface/transformers/blob/main/src/transformers/models/deformable_detr/configuration_deformable_detr.py#L25)
**المعاملات:**
is_encoder_decoder (`bool`، *اختياري*، الافتراضي هو `True`) : ما إذا كان النموذج يُستخدم كمُشفِّر/مُفكِّك أم لا.
backbone_config (`Union[dict, ~configuration_utils.PreTrainedConfig]`، *اختياري*) : إعدادات نموذج الهيكل الأساسي.
num_channels (`int`، *اختياري*، القيمة الافتراضية `3`) : عدد قنوات الإدخال.
num_queries (`int`, *اختياري*, القيمة الافتراضية 300) : عدد استعلامات الكائنات، أي فتحات الكشف. هذا هو الحد الأقصى لعدد الكائنات التي يمكن لـ [DeformableDetrModel](/docs/transformers/main/ar/model_doc/deformable_detr#transformers.DeformableDetrModel) اكتشافها في صورة واحدة. في حال تعيين `two_stage` إلى `True`، نستخدم `two_stage_num_proposals` بدلاً من ذلك.
max_position_embeddings (`int`، *اختياري*، الافتراضي هو `1024`) : أقصى طول تسلسل قد يُستخدم به هذا النموذج.
encoder_layers (`int`، *اختياري*، القيمة الافتراضية `6`) : عدد الطبقات المخفية في مُشفِّر Transformer. سيستخدم القيمة نفسها لـ`num_layers` إذا لم يتم ضبطه.
encoder_ffn_dim (`int`، *اختياري*، القيمة الافتراضية `1024`) : بُعد طبقة "الوسيطة" (التي تُسمّى غالبًا بالطبقة الأمامية) في المُشفِّر.
encoder_attention_heads (`int`، *اختياري*، القيمة الافتراضية `8`) : عدد رؤوس الانتباه لكل طبقة انتباه في مُشفِّر Transformer.
decoder_layers (`int`، *اختياري*، القيمة الافتراضية `6`) : عدد الطبقات المخفية في مُفكِّك Transformer. سيستخدم القيمة نفسها لـ`num_layers` إذا لم يتم ضبطه.
decoder_ffn_dim (`int`، *اختياري*، القيمة الافتراضية `1024`) : بُعد طبقة "الوسيطة" (التي تُسمّى غالبًا طبقة التغذية الأمامية) في المُفكِّك.
decoder_attention_heads (`int`، *اختياري*، القيمة الافتراضية `8`) : عدد رؤوس الانتباه في كل طبقة انتباه داخل مُفكِّك Transformer.
encoder_layerdrop (`Union[float, int]`، *اختياري*، الافتراضي هو `0.0`) : احتمال LayerDrop للمشفّر. راجع [ورقة LayerDrop](see https://huggingface.co/papers/1909.11556) لمزيد من التفاصيل.
activation_function (`str`، *اختياري*، الافتراضي هو `relu`) : دالة التنشيط غير الخطية (دالة أو نص) في المُفكِّك. على سبيل المثال، `"gelu"`، `"relu"`، `"silu"`، وغيرها.
d_model (`int`، *اختياري*، القيمة الافتراضية `256`) : حجم طبقات المُشفِّر وطبقة المُجمِّع.
dropout (`Union[float, int]`، *اختياري*، القيمة الافتراضية هي `0.1`) : النسبة لجميع طبقات dropout.
attention_dropout (`Union[float, int]`، *اختياري*، القيمة الافتراضية `0.0`) : نسبة الإسقاط (dropout) لاحتمالات الانتباه.
activation_dropout (`Union[float, int]`، *اختياري*، القيمة الافتراضية `0.0`) : نسبة الإسقاط (dropout) للتفعيلات داخل الطبقة المتصلة بالكامل.
init_std (`float`، *اختياري*، القيمة الافتراضية `0.02`) : الانحراف المعياري لـ truncated_normal_initializer المستخدم في تهيئة جميع مصفوفات الأوزان.
init_xavier_std (`float`، *اختياري*، القيمة الافتراضية `1.0`) : معامل التدرّج المستخدم في تهيئة Xavier لأوزان الانتباه المتقاطع.
return_intermediate (`bool`، *اختياري*، الافتراضي True) : ما إذا كان يجب إرجاع الحالة الوسيطة أم لا
auxiliary_loss (`bool`، *اختياري*، القيمة الافتراضية `False`) : ما إذا كان سيتم استخدام خسائر فك الترميز المساعدة (الخسائر في كل طبقة من طبقات فك الترميز).
position_embedding_type (`str`، *اختياري*، القيمة الافتراضية `"sine"`) : نوع تضمينات المواقع (position embeddings) المستخدمة فوق ميزات الصورة. إما `"sine"` أو `"learned"`.
dilation (`bool`, *اختياري*, الافتراضي `False`) : ما إذا كان سيتم استبدال الخطوة (stride) بالتوسيع (dilation) في كتلة الالتفاف الأخيرة (DC5). مدعوم فقط عندما يكون `use_timm_backbone` = `True`.
num_feature_levels (`int`، *اختياري*، القيمة الافتراضية 4) : عدد مستويات ميزات الإدخال.
encoder_n_points (`int`، *اختياري*، القيمة الافتراضية 4) : عدد المفاتيح المُستخرجة في كل مستوى من مستويات الميزات لكل رأس من رؤوس الانتباه في المُشفِّر.
decoder_n_points (`int`، *اختياري*، القيمة الافتراضية 4) : عدد المفاتيح المُستخرجة في كل مستوى من مستويات الميزات لكل رأس من رؤوس الانتباه في المُفكِّك.
two_stage (`bool`، *اختياري*، القيمة الافتراضية `False`) : ما إذا كان سيتم تطبيق نموذج Deformable DETR على مرحلتين، حيث يتم توليد اقتراحات المناطق أيضًا بواسطة نسخة من Deformable DETR، ثم تُغذّى هذه الاقتراحات إلى المُفكِّك (decoder) لتحسين صناديق الحدود بشكل تكراري.
two_stage_num_proposals (`int`, *اختياري*, القيمة الافتراضية 300) : عدد اقتراحات المناطق التي سيتم توليدها، في حال تم ضبط `two_stage` على `True`.
with_box_refine (`bool`، *اختياري*، القيمة الافتراضية `False`) : ما إذا كان سيتم تطبيق تحسين تكراري لصفحات الحدود، حيث تُحسّن كل طبقة من طبقات المُفكِّك (decoder) صفحات الحدود بناءً على التنبؤات القادمة من الطبقة السابقة.
class_cost (`int`، *اختياري*، القيمة الافتراضية `1`) : الوزن النسبي لخطأ التصنيف في تكلفة المطابقة الهنغارية.
bbox_cost (`int`، *اختياري*، القيمة الافتراضية `5`) : الوزن النسبي لخطأ صندوق الحدود L1 في تكلفة المطابقة الهنغارية.
giou_cost (`int`, *اختياري*، القيمة الافتراضية `2`) : الوزن النسبي لخسارة IoU المعممة في تكلفة المطابقة الهنغارية.
mask_loss_coefficient (`int`، *اختياري*، القيمة الافتراضية `1`) : الوزن النسبي لخسارة التركيز (focal loss) في خسارة التقطيع البانورامي (panoptic segmentation).
dice_loss_coefficient (`int`، *اختياري*، القيمة الافتراضية `1`) : الوزن النسبي لخسارة الداي (dice loss) في خسارة التقطيع البانورامي (panoptic segmentation).
bbox_loss_coefficient (`int`، *اختياري*، القيمة الافتراضية `5`) : الوزن النسبي لخسارة صندوق الحدود L1 في خسارة التقطيع البانورامي.
giou_loss_coefficient (`int`, *اختياري*, القيمة الافتراضية `2`) : الوزن النسبي لخسارة IoU المعممة في خسارة التقطيع البانورامي.
eos_coefficient (`float`، *اختياري*، القيمة الافتراضية `0.1`) : وزن التصنيف النسبي لفئة "لا يوجد كائن" في خسارة كشف الكائنات.
focal_alpha (`float`، *اختياري*، القيمة الافتراضية `0.25`) : معامل Alpha في خسارة التركيز (focal loss).
disable_custom_kernels (`bool`، *اختياري*، القيمة الافتراضية `False`) : تعطيل استخدام نواة CUDA وCPU المخصصة. هذا الخيار ضروري للتصدير إلى ONNX، حيث لا تدعم عملية تصدير PyTorch إلى ONNX النوى المخصصة.
tie_word_embeddings (`bool`، *اختياري*، القيمة الافتراضية `True`) : ما إذا كان يجب ربط ترميزات الأوزان وفقاً لخريطة `tied_weights_keys` الخاصة بالنموذج.
هذه فئة الإعدادات المخزنة لإعدادات نموذج DeformableDetrModel. تُستخدم لاستحداث نموذج Deformable Detr وفقاً للحجج المحددة، مع تعريف بنية النموذج. إن استحداث إعدادات باستخدام القيم الافتراضية سيؤدي إلى إعدادات مشابهة لتلك الخاصة بـ [SenseTime/deformable-detr](https://huggingface.co/SenseTime/deformable-detr)
ترث كائنات الإعداد من [PreTrainedConfig](/docs/transformers/main/ar/main_classes/configuration#transformers.PreTrainedConfig) ويمكن استخدامها للتحكم في مخرجات النموذج. اقرأ التوثيق الخاص بـ [PreTrainedConfig](/docs/transformers/main/ar/main_classes/configuration#transformers.PreTrainedConfig) لمزيد من المعلومات.
أمثلة:
```python
>>> from transformers import DeformableDetrConfig, DeformableDetrModel
>>> # Initializing a Deformable DETR SenseTime/deformable-detr style configuration
>>> configuration = DeformableDetrConfig()
>>> # Initializing a model (with random weights) from the SenseTime/deformable-detr style configuration
>>> model = DeformableDetrModel(configuration)
>>> # Accessing the model configuration
>>> configuration = model.config
```
## DeformableDetrModel[[transformers.DeformableDetrModel]]
#### transformers.DeformableDetrModel[[transformers.DeformableDetrModel]]
```python
transformers.DeformableDetrModel(config: DeformableDetrConfig)
```
[المصدر](https://github.com/huggingface/transformers/blob/main/src/transformers/models/deformable_detr/modeling_deformable_detr.py#L1145)
**المعاملات:**
config ([DeformableDetrConfig](/docs/transformers/main/ar/model_doc/deformable_detr#transformers.DeformableDetrConfig)) : فئة إعدادات النموذج التي تحتوي على جميع معاملات النموذج. عند التهيئة باستخدام ملف إعدادات، لا يتم تحميل الأوزان المرتبطة بالنموذج، بل الإعدادات فقط. راجع طريقة [from_pretrained()](/docs/transformers/main/ar/main_classes/model#transformers.PreTrainedModel.from_pretrained) لتحميل أوزان النموذج.
نموذج Deformable DETR الأساسي (المكوّن من عمود فقري ومحوّل مُشفِّر-مفكك) الذي يُخرج حالات مخفية خام دون أي رأس محدد في الأعلى.
يرث هذا النموذج من [PreTrainedModel](/docs/transformers/main/ar/main_classes/model#transformers.PreTrainedModel). راجع توثيق الفئة الأصلية لمعرفة الطرق العامة التي تنفذها المكتبة لجميع نماذجها (مثل التنزيل أو الحفظ، وتغيير حجم تضمينات الإدخال، وقص الرؤوس، وما إلى ذلك).
هذا النموذج هو أيضاً فئة فرعية من [torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module) في PyTorch. استخدمه كوحدة PyTorch عادية، وارجع إلى توثيق PyTorch لكل ما يتعلق بالاستخدام العام والسلوك.
#### forward[[transformers.DeformableDetrModel.forward]]
```python
forward(pixel_values: Tensor, pixel_mask: typing.Optional[torch.LongTensor] = None, decoder_attention_mask: typing.Optional[torch.Tensor] = None, encoder_outputs: typing.Optional[torch.Tensor] = None, inputs_embeds: typing.Optional[torch.Tensor] = None, decoder_inputs_embeds: typing.Optional[torch.Tensor] = None, **kwargs: *)
```
[المصدر](https://github.com/huggingface/transformers/blob/main/src/transformers/models/deformable_detr/modeling_deformable_detr.py#L1319)
**المعاملات:**
pixel_values (`torch.Tensor` من الشكل `(batch_size, num_channels, image_size, image_size)`) : المصفوفات المتناظرة مع الصور المدخلة. يمكن الحصول على قيم البكسل باستخدام `image_processor_class`. راجع `image_processor_class.__call__` للتفاصيل (`processor_class` يستخدم `image_processor_class` لمعالجة الصور).
pixel_mask (`torch.LongTensor` من الشكل `(batch_size, height, width)`، *اختياري*) : قناع لتجنب تنفيذ الانتباه على قيم البكسلات المعبأة. قيم القناع المختارة في `[0, 1]`: - 1 للبكسلات الحقيقية (أي **غير المقنّعة**)، - 0 للبكسلات المعبأة (أي **المقنّعة**). [ما هي أقنعة الانتباه؟](../glossary#attention-mask)
decoder_attention_mask (`torch.Tensor` من الشكل `(batch_size, num_queries)`، *اختياري*) : غير مستخدم افتراضيًا. يمكن استخدامه لإخفاء استعلامات الكائنات.
encoder_outputs (`torch.Tensor`، *اختياري*) : Tuple يتكون من (`last_hidden_state`، *اختياري*: `hidden_states`، *اختياري*: `attentions`) `last_hidden_state` من الشكل `(batch_size, sequence_length, hidden_size)`، *اختياري*) هو تسلسل من حالات الخفاء عند مخرج الطبقة الأخيرة من المُشفِّر. يُستخدم في الانتباه المتقاطع (cross-attention) في المُفكِّك.
inputs_embeds (`torch.Tensor` من الشكل `(batch_size, sequence_length, hidden_size)`، *اختياري*) : بدلاً من تمرير خريطة الميزات المسطحة (مخرجات العمود الفقري وطبقة الإسقاط)، يمكنك اختيار تمرير تمثيل مسطح للصورة مباشرةً.
decoder_inputs_embeds (`torch.Tensor` من الشكل `(batch_size, num_queries, hidden_size)`، *اختياري*) : بدلاً من تهيئة الاستعلامات بمصفوفة من الأصفار، يمكنك اختيار تمرير تمثيل مضمّن مباشرةً.
**يعيد:** `DeformableDetrModelOutput` أو `tuple(torch.Tensor)`
`DeformableDetrModelOutput` أو مجموعة مرتبة من `torch.Tensor` (إذا تم تمرير `return_dict=False` أو عندما يكون `config.return_dict=False`) وتتضمن عناصر مختلفة اعتمادًا على الإعداد (`None`) والمدخلات.
تُعيد طريقة [DeformableDetrModel](/docs/transformers/main/ar/model_doc/deformable_detr#transformers.DeformableDetrModel) الخاصة بالتقديم (forward) تعريف الطريقة الخاصة `__call__`.
على الرغم من أنه يجب تعريف وصفة المرور الأمامي داخل هذه الدالة، إلا أنه ينبغي استدعاء كائن `Module` بدلاً من هذه الدالة، لأن الكائن يتولى تنفيذ خطوات المعالجة المسبقة والمعالجة اللاحقة، بينما تتجاهل الدالة هذه الخطوات بصمت.
- **init_reference_points** (`torch.Tensor` من الشكل `(batch_size, num_queries, 4)`) -- نقاط المرجع الأولية المُرسلة عبر مُفكِّك Transformer.
- **last_hidden_state** (`torch.Tensor` من الشكل `(batch_size, num_queries, hidden_size)`) -- تسلسل من حالات الإخفاء عند مخرج الطبقة الأخيرة من فاحص النموذج.
- **intermediate_hidden_states** (`torch.Tensor` من الشكل `(batch_size, config.decoder_layers, num_queries, hidden_size)`) -- حالات مخفية وسيطة مكدسة (مخرجات كل طبقة من فاحم الشيفر).
- **intermediate_reference_points** (`torch.Tensor` من الشكل `(batch_size, config.decoder_layers, num_queries, 4)`) -- نقاط مرجعية وسيطة مكدسة (نقاط مرجعية لكل طبقة من طبقات المُفكِّك).
- **decoder_hidden_states** (`tuple[torch.Tensor]`, *اختياري*, يُعاد عند تمرير `output_hidden_states=True` أو عند `config.output_hidden_states=True`) -- مجموعة مرتبة من `torch.Tensor` (واحدة لمخرجات التضمينات، إذا كان النموذج يحتوي على طبقة تضمين، + واحدة لمخرجات كل طبقة) من الشكل `(batch_size, sequence_length, hidden_size)`.
حالات المخفية (Hidden states) لمفكّك الترميز (decoder) عند مخرج كل طبقة بالإضافة إلى مخرجات التضمين الأولي (initial embedding).
- **decoder_attentions** (`tuple[torch.Tensor]`, *اختياري*, يُعاد عند تمرير `output_attentions=True` أو عند `config.output_attentions=True`) -- مجموعة مرتبة من `torch.Tensor` (واحدة لكل طبقة) بأبعاد `(batch_size, num_heads, sequence_length, sequence_length)`.
أوزان الانتباه في المفكّك، بعد softmax الانتباه، المستخدمة لحساب المتوسط المرجّح في رؤوس الانتباه الذاتي.
- **cross_attentions** (`tuple[torch.Tensor]`, *اختياري*, يُعاد عند تمرير `output_attentions=True` أو عند `config.output_attentions=True`) -- مجموعة مرتبة من `torch.Tensor` (واحدة لكل طبقة) بأبعاد `(batch_size, num_heads, sequence_length, sequence_length)`.
أوزان الانتباه في طبقة الانتباه المتقاطع للمفكّك، بعد softmax للانتباه، وتُستخدم لحساب المتوسط المرجّح في رؤوس الانتباه المتقاطع.
- **encoder_last_hidden_state** (`torch.Tensor` بشكل `(batch_size, sequence_length, hidden_size)`، *اختياري*) -- سلسلة من حالات الإخفاء عند مخرجات الطبقة الأخيرة من المُشفِّر في النموذج.
- **encoder_hidden_states** (`tuple[torch.Tensor]`, *اختياري*, يُعاد عند تمرير `output_hidden_states=True` أو عند `config.output_hidden_states=True`) -- مجموعة مرتبة من `torch.Tensor` (واحدة لمخرجات التضمينات، إذا كان النموذج يحتوي على طبقة تضمين، + واحدة لمخرجات كل طبقة) من الشكل `(batch_size, sequence_length, hidden_size)`.
حالات المخفية للمشفّر عند مخرج كل طبقة بالإضافة إلى مخرجات التضمين الأولي.
- **encoder_attentions** (`tuple[torch.Tensor]`, *اختياري*, يُعاد عند تمرير `output_attentions=True` أو عند `config.output_attentions=True`) -- مجموعة مرتبة من `torch.Tensor` (واحدة لكل طبقة) بأبعاد `(batch_size, num_heads, sequence_length, sequence_length)`.
أوزان الانتباه للمُشفِّر، بعد softmax للانتباه، المُستخدَمة لحساب المتوسط الموزون في رؤوس الانتباه الذاتي.
- **enc_outputs_class** (`torch.Tensor` من الشكل `(batch_size, sequence_length, config.num_labels)`، *اختياري*، يُعاد عند `config.with_box_refine=True` و`config.two_stage=True`) -- درجات الصناديق المحيطة المتوقعة حيث يتم اختيار أعلى `config.two_stage_num_proposals` صناديق محيطة من حيث الدرجات كإقتراحات مناطق في المرحلة الأولى. مخرجات التصنيف الثنائي للصناديق المحيطة (أي المقدمة والخلفية).
- **enc_outputs_coord_logits** (`torch.Tensor` من الشكل `(batch_size, sequence_length, 4)`، *اختياري*، يُعاد عند `config.with_box_refine=True` و`config.two_stage=True`) -- قيم اللوجيتات الخاصة بإحداثيات صناديق الحدود المتوقعة في المرحلة الأولى.
أمثلة:
```python
>>> from transformers import AutoImageProcessor, DeformableDetrModel
>>> from PIL import Image
>>> from huggingface_hub.utils import httpx
>>> from io import BytesIO
>>> url = "http://images.cocodataset.org/val2017/000000039769.jpg"
>>> with httpx.stream("GET", url) as response:
... image = Image.open(BytesIO(response.read()))
>>> image_processor = AutoImageProcessor.from_pretrained("SenseTime/deformable-detr")
>>> model = DeformableDetrModel.from_pretrained("SenseTime/deformable-detr")
>>> inputs = image_processor(images=image, return_tensors="pt")
>>> outputs = model(**inputs)
>>> last_hidden_states = outputs.last_hidden_state
>>> list(last_hidden_states.shape)
[1, 300, 256]
```
## DeformableDetrForObjectDetection[[transformers.DeformableDetrForObjectDetection]]
#### transformers.DeformableDetrForObjectDetection[[transformers.DeformableDetrForObjectDetection]]
```python
transformers.DeformableDetrForObjectDetection(config: DeformableDetrConfig)
```
[المصدر](https://github.com/huggingface/transformers/blob/main/src/transformers/models/deformable_detr/modeling_deformable_detr.py#L1542)
**المعاملات:**
config ([DeformableDetrConfig](/docs/transformers/main/ar/model_doc/deformable_detr#transformers.DeformableDetrConfig)) : فئة إعدادات النموذج التي تحتوي على جميع معاملات النموذج. عند التهيئة باستخدام ملف إعدادات، لا يتم تحميل الأوزان المرتبطة بالنموذج، بل الإعدادات فقط. راجع طريقة [from_pretrained()](/docs/transformers/main/ar/main_classes/model#transformers.PreTrainedModel.from_pretrained) لتحميل أوزان النموذج.
نموذج Deformable DETR (المكوّن من هيكل أساسي ومحوّل مُشفِّر-مفكّك) مع رؤوس كشف كائنات في الأعلى، لمهام مثل كشف COCO.
يرث هذا النموذج من [PreTrainedModel](/docs/transformers/main/ar/main_classes/model#transformers.PreTrainedModel). راجع توثيق الفئة الأصلية لمعرفة الطرق العامة التي تنفذها المكتبة لجميع نماذجها (مثل التنزيل أو الحفظ، وتغيير حجم تضمينات الإدخال، وقص الرؤوس، وما إلى ذلك).
هذا النموذج هو أيضاً فئة فرعية من [torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module) في PyTorch. استخدمه كوحدة PyTorch عادية، وارجع إلى توثيق PyTorch لكل ما يتعلق بالاستخدام العام والسلوك.
#### forward[[transformers.DeformableDetrForObjectDetection.forward]]
```python
forward(pixel_values: Tensor, pixel_mask: typing.Optional[torch.LongTensor] = None, decoder_attention_mask: typing.Optional[torch.Tensor] = None, encoder_outputs: typing.Optional[torch.Tensor] = None, inputs_embeds: typing.Optional[torch.Tensor] = None, decoder_inputs_embeds: typing.Optional[torch.Tensor] = None, labels: list[dict] | None = None, **kwargs: *)
```
[المصدر](https://github.com/huggingface/transformers/blob/main/src/transformers/models/deformable_detr/modeling_deformable_detr.py#L1580)
**المعاملات:**
pixel_values (`torch.Tensor` من الشكل `(batch_size, num_channels, image_size, image_size)`) : المصفوفات المتناظرة مع الصور المدخلة. يمكن الحصول على قيم البكسل باستخدام `image_processor_class`. راجع `image_processor_class.__call__` للتفاصيل (`processor_class` يستخدم `image_processor_class` لمعالجة الصور).
pixel_mask (`torch.LongTensor` من الشكل `(batch_size, height, width)`، *اختياري*) : قناع لتجنب تنفيذ الانتباه على قيم البكسلات المعبأة. قيم القناع المختارة في `[0, 1]`: - 1 للبكسلات الحقيقية (أي **غير المقنّعة**)، - 0 للبكسلات المعبأة (أي **المقنّعة**). [ما هي أقنعة الانتباه؟](../glossary#attention-mask)
decoder_attention_mask (`torch.Tensor` من الشكل `(batch_size, num_queries)`، *اختياري*) : غير مستخدم افتراضيًا. يمكن استخدامه لإخفاء استعلامات الكائنات.
encoder_outputs (`torch.Tensor`، *اختياري*) : Tuple يتكون من (`last_hidden_state`، *اختياري*: `hidden_states`، *اختياري*: `attentions`) `last_hidden_state` من الشكل `(batch_size, sequence_length, hidden_size)`، *اختياري*) هو تسلسل من حالات الخفاء عند مخرج الطبقة الأخيرة من المُشفِّر. يُستخدم في الانتباه المتقاطع (cross-attention) في المُفكِّك.
inputs_embeds (`torch.Tensor` من الشكل `(batch_size, sequence_length, hidden_size)`، *اختياري*) : بدلاً من تمرير خريطة الميزات المسطحة (مخرجات العمود الفقري وطبقة الإسقاط)، يمكنك اختيار تمرير تمثيل مسطح للصورة مباشرةً.
decoder_inputs_embeds (`torch.Tensor` من الشكل `(batch_size, num_queries, hidden_size)`، *اختياري*) : بدلاً من تهيئة الاستعلامات بمصفوفة من الأصفار، يمكنك اختيار تمرير تمثيل مضمّن مباشرةً.
labels (`list[Dict]` بطول `(batch_size,)`، *اختياري*) : تسميات لحساب خسارة المطابقة الثنائية. قائمة من القواميس، يحتوي كل قاموس على الأقل على المفتاحين التاليين: 'class_labels' و 'boxes' (تسميات الفئات وصناديق الحدود لصورة في الدفعة على التوالي). يجب أن تكون تسميات الفئات نفسها `torch.LongTensor` بطول `(number of bounding boxes in the image,)` وأن تكون الصناديق `torch.Tensor` بشكل `(number of bounding boxes in the image, 4)`.
**يعيد:** `DeformableDetrObjectDetectionOutput` أو `tuple(torch.Tensor)`
`DeformableDetrObjectDetectionOutput` أو مجموعة مرتبة من `torch.Tensor` (إذا تم تمرير `return_dict=False` أو عندما يكون `config.return_dict=False`) وتتضمن عناصر مختلفة اعتمادًا على الإعداد (`None`) والمدخلات.
تُعيد طريقة [DeformableDetrForObjectDetection](/docs/transformers/main/ar/model_doc/deformable_detr#transformers.DeformableDetrForObjectDetection) الخاصة بالتقديم (forward) تعريف الطريقة الخاصة `__call__`.
على الرغم من أنه يجب تعريف وصفة المرور الأمامي داخل هذه الدالة، إلا أنه ينبغي استدعاء كائن `Module` بدلاً من هذه الدالة، لأن الكائن يتولى تنفيذ خطوات المعالجة المسبقة والمعالجة اللاحقة، بينما تتجاهل الدالة هذه الخطوات بصمت.
- **loss** (`torch.Tensor` of shape `(1,)`, *اختياري*, يُعاد عند توفير `labels`) -- إجمالي الخسارة على شكل تركيبة خطية من سلبية الاحتمال اللوغاريتمي (الإنتروبيا المتقاطعة) للتنبؤ بالفئة وخسارة صندوق الحدود. تُعرَّف الأخيرة على أنها تركيبة خطية من خسارة L1 وخسارة IoU العامة غير المعتمدة على المقياس.
- **loss_dict** (`Dict`، *اختياري*) -- قاموس يحتوي على الخسائر الفردية. مفيد للتسجيل.
- **logits** (`torch.Tensor` من الشكل `(batch_size, num_queries, num_classes + 1)`) -- قيم التصنيف (تشمل فئة "لا يوجد كائن") لجميع الاستعلامات.
- **pred_boxes** (`torch.Tensor` من الشكل `(batch_size, num_queries, 4)`) -- إحداثيات صناديق مُطبَّعة لجميع الاستعلامات، ممثّلة على شكل (center_x, center_y, width, height). هذه القيم مُطبَّعة ضمن المدى [0, 1]، نسبةً إلى حجم كل صورة فردية في الدفعة (مع تجاهل أي حشو محتمل). يمكنك استخدام `~DeformableDetrProcessor.post_process_object_detection` لاسترجاع صناديق الحدود غير المُطبَّعة.
- **auxiliary_outputs** (`list[Dict]`، *اختياري*) -- اختياري، يُعاد فقط عند تفعيل الخسائر المساعدة (أي عند ضبط `config.auxiliary_loss` على `True`) وتوفير التسميات. وهو قائمة من القواميس تحتوي على المفتاحين المذكورين أعلاه (`logits` و`pred_boxes`) لكل طبقة من طبقات فك الترميز.
- **last_hidden_state** (`torch.Tensor` من الشكل `(batch_size, num_queries, hidden_size)`، *اختياري*) -- تسلسل من حالات الإخفاء عند مخرج الطبقة الأخيرة من فاحص النموذج.
- **decoder_hidden_states** (`tuple[torch.Tensor]`, *اختياري*, يُعاد عند تمرير `output_hidden_states=True` أو عند `config.output_hidden_states=True`) -- مجموعة مرتبة من `torch.Tensor` (واحدة لمخرجات التضمينات، إذا كان النموذج يحتوي على طبقة تضمين، + واحدة لمخرجات كل طبقة) من الشكل `(batch_size, sequence_length, hidden_size)`.
حالات المخفية (Hidden states) لمفكّك الترميز (decoder) عند مخرج كل طبقة بالإضافة إلى مخرجات التضمين الأولي (initial embedding).
- **decoder_attentions** (`tuple[torch.Tensor]`, *اختياري*, يُعاد عند تمرير `output_attentions=True` أو عند `config.output_attentions=True`) -- مجموعة مرتبة من `torch.Tensor` (واحدة لكل طبقة) بأبعاد `(batch_size, num_heads, sequence_length, sequence_length)`.
أوزان الانتباه في المفكّك، بعد softmax الانتباه، المستخدمة لحساب المتوسط المرجّح في رؤوس الانتباه الذاتي.
- **cross_attentions** (`tuple[torch.Tensor]`, *اختياري*, يُعاد عند تمرير `output_attentions=True` أو عند `config.output_attentions=True`) -- مجموعة مرتبة من `torch.Tensor` (واحدة لكل طبقة) بأبعاد `(batch_size, num_heads, sequence_length, sequence_length)`.
أوزان الانتباه في طبقة الانتباه المتقاطع للمفكّك، بعد softmax للانتباه، وتُستخدم لحساب المتوسط المرجّح في رؤوس الانتباه المتقاطع.
- **encoder_last_hidden_state** (`torch.Tensor` بشكل `(batch_size, sequence_length, hidden_size)`، *اختياري*) -- سلسلة من حالات الإخفاء عند مخرجات الطبقة الأخيرة من المُشفِّر في النموذج.
- **encoder_hidden_states** (`tuple[torch.Tensor]`, *اختياري*, يُعاد عند تمرير `output_hidden_states=True` أو عند `config.output_hidden_states=True`) -- مجموعة مرتبة من `torch.Tensor` (واحدة لمخرجات التضمينات، إذا كان النموذج يحتوي على طبقة تضمين، + واحدة لمخرجات كل طبقة) من الشكل `(batch_size, sequence_length, hidden_size)`.
حالات المخفية للمشفّر عند مخرج كل طبقة بالإضافة إلى مخرجات التضمين الأولي.
- **encoder_attentions** (`tuple[torch.Tensor]`, *اختياري*, يُعاد عند تمرير `output_attentions=True` أو عند `config.output_attentions=True`) -- مجموعة مرتبة من `torch.Tensor` (واحدة لكل طبقة) بأبعاد `(batch_size, num_heads, sequence_length, sequence_length)`.
أوزان الانتباه للمُشفِّر، بعد softmax للانتباه، المُستخدَمة لحساب المتوسط الموزون في رؤوس الانتباه الذاتي.
- **init_reference_points** (`torch.Tensor` من الشكل `(batch_size, num_queries, 4)`) -- نقاط المرجع الأولية المُرسلة عبر مُفكِّك Transformer.
- **intermediate_hidden_states** (`torch.Tensor` من الشكل `(batch_size, config.decoder_layers, num_queries, hidden_size)`) -- حالات مخفية وسيطة مكدسة (مخرجات كل طبقة من فاحم الشيفر).
- **intermediate_reference_points** (`torch.Tensor` من الشكل `(batch_size, config.decoder_layers, num_queries, 4)`) -- نقاط مرجعية وسيطة مكدسة (نقاط مرجعية لكل طبقة من طبقات المُفكِّك).
- **enc_outputs_class** (`torch.Tensor` من الشكل `(batch_size, sequence_length, config.num_labels)`، *اختياري*، يُعاد عند `config.with_box_refine=True` و`config.two_stage=True`) -- درجات الصناديق المحيطة المتوقعة حيث يتم اختيار أعلى `config.two_stage_num_proposals` صناديق محيطة من حيث الدرجات كإقتراحات مناطق في المرحلة الأولى. مخرجات التصنيف الثنائي للصناديق المحيطة (أي المقدمة والخلفية).
- **enc_outputs_coord_logits** (`torch.Tensor` من الشكل `(batch_size, sequence_length, 4)`، *اختياري*، يُعاد عند `config.with_box_refine=True` و`config.two_stage=True`) -- قيم اللوجيتات الخاصة بإحداثيات صناديق الحدود المتوقعة في المرحلة الأولى.
أمثلة:
```python
>>> from transformers import AutoImageProcessor, DeformableDetrForObjectDetection
>>> from PIL import Image
>>> from huggingface_hub.utils import httpx
>>> from io import BytesIO
>>> url = "http://images.cocodataset.org/val2017/000000039769.jpg"
>>> with httpx.stream("GET", url) as response:
... image = Image.open(BytesIO(response.read()))
>>> image_processor = AutoImageProcessor.from_pretrained("SenseTime/deformable-detr")
>>> model = DeformableDetrForObjectDetection.from_pretrained("SenseTime/deformable-detr")
>>> inputs = image_processor(images=image, return_tensors="pt")
>>> outputs = model(**inputs)
>>> # convert outputs (bounding boxes and class logits) to Pascal VOC format (xmin, ymin, xmax, ymax)
>>> target_sizes = torch.tensor([image.size[::-1]])
>>> results = image_processor.post_process_object_detection(outputs, threshold=0.5, target_sizes=target_sizes)[
... 0
... ]
>>> for score, label, box in zip(results["scores"], results["labels"], results["boxes"]):
... box = [round(i, 2) for i in box.tolist()]
... print(
... f"Detected {model.config.id2label[label.item()]} with confidence "
... f"{round(score.item(), 3)} at location {box}"
... )
Detected cat with confidence 0.8 at location [16.5, 52.84, 318.25, 470.78]
Detected cat with confidence 0.789 at location [342.19, 24.3, 640.02, 372.25]
Detected remote with confidence 0.633 at location [40.79, 72.78, 176.76, 117.25]
```