# Perceiver
## 개요
Perceiver IO 모델은 Andrew Jaegle, Sebastian Borgeaud, Jean-Baptiste Alayrac, Carl Doersch, Catalin Ionescu, David Ding, Skanda Koppula, Daniel Zoran, Andrew Brock, Evan Shelhamer, Olivier Hénaff, Matthew M. Botvinick, Andrew Zisserman, Oriol Vinyals, João Carreira가 [Perceiver IO: A General Architecture for Structured Inputs & Outputs](https://huggingface.co/papers/2107.14795)에서 제안했습니다.
Perceiver IO는 임의의 입력과 함께 임의의 출력을 처리하도록 [Perceiver](https://huggingface.co/papers/2103.03206)를 일반화한 것입니다. 원래 Perceiver는 단일 분류 라벨만 생성했습니다. Perceiver IO는 분류 라벨 외에도 (예를 들어) 언어, 광학 흐름, 오디오가 포함된 멀티모달 비디오를 생성할 수 있습니다. 이는 원래 Perceiver와 동일한 구성 요소를 사용하여 수행됩니다. Perceiver IO의 계산 복잡도는 입력 및 출력 크기에 대해 선형이며, 처리의 대부분은 잠재 공간(latent space)에서 이루어지므로 표준 Transformers가 처리할 수 있는 것보다 훨씬 큰 입력과 출력을 처리할 수 있습니다. 예를 들어, Perceiver IO는 토큰화된 입력 대신 바이트를 직접 사용하여 BERT 스타일의 마스킹 언어 모델링을 수행할 수 있습니다.
해당 논문의 초록은 다음과 같습니다:
*최근 제안된 Perceiver 모델은 이미지, 오디오, 멀티모달, 포인트 클라우드 등 여러 도메인에서 좋은 결과를 얻으면서도 입력 크기에 따라 계산 및 메모리가 선형으로 확장됩니다. Perceiver는 다양한 종류의 입력을 지원하지만, 클래스 점수와 같은 매우 단순한 출력만 생성할 수 있습니다. Perceiver IO는 모델의 잠재 공간을 유연하게 쿼리하여 임의의 크기와 의미를 가진 출력을 생성하도록 학습함으로써, 원래 모델의 매력적인 특성을 희생하지 않으면서도 이러한 한계를 극복합니다. Perceiver IO는 여전히 모델의 깊이를 데이터 크기와 분리하고 데이터 크기에 따라 선형으로 확장되지만, 이제 입력과 출력 크기에 모두 해당합니다. 완전한 Perceiver IO 모델은 자연어 및 시각 이해, StarCraft II, 멀티태스크 및 멀티모달 도메인처럼 고도로 구조화된 출력 공간을 가진 작업에서 강력한 결과를 달성합니다. 특히, Perceiver IO는 입력 토큰화가 필요 없이 GLUE 언어 벤치마크에서 Transformer 기반 BERT 베이스라인과 동등한 성능을 보이며, Sintel 광학 흐름 추정에서 최첨단 성능을 달성합니다.*
Perceiver의 작동 방식을 요약한 TLDR입니다:
Transformer의 self-attention 메커니즘의 주요 문제는 시간과 메모리 요구량이 시퀀스 길이에 따라 제곱으로 증가한다는 점입니다. 따라서 BERT와 RoBERTa와 같은 모델은 최대 시퀀스 길이가 512 토큰으로 제한됩니다. Perceiver는 입력에 self-attention을 수행하는 대신, 잠재 변수(latent variables) 집합에 self-attention을 수행하고, 입력은 cross-attention에만 사용하여 이 문제를 해결하고자 합니다. 이렇게 하면 256개나 512개와 같이 고정된 수의 잠재 변수를 사용하므로, 시간과 메모리 요구량이 더 이상 입력의 길이에 의존하지 않습니다. 이러한 잠재 변수는 무작위로 초기화된 후, backpropagation을 사용하여 end-to-end로 학습됩니다.
내부적으로 [PerceiverModel](/docs/transformers/v5.23.0/ko/model_doc/perceiver#transformers.PerceiverModel)은 `(batch_size, num_latents, d_latents)` 형태의 텐서인 latents를 생성합니다. 모델에는 텍스트, 이미지, 오디오 등 다양한 형태의 `inputs`를 제공해야 하며, 모델은 이를 사용하여 latents와 cross-attention을 수행합니다. Perceiver 인코더의 출력은 동일한 형태의 텐서입니다. 이후 BERT와 유사하게, latents의 마지막 hidden states를 시퀀스 차원 방향으로 평균화하여 분류 logits로 변환한 뒤, 그 위에 선형 레이어를 배치하여 `d_latents`를 `num_labels`로 투영할 수 있습니다.
이것은 원래 Perceiver 논문에서 제시된 아이디어였습니다. 하지만 이 방식은 분류 로짓만 출력할 수 있었습니다. 후속 연구인 PerceiverIO에서는 이를 일반화하여 모델이 임의의 크기의 출력도 생성할 수 있도록 했습니다. 어떻게 가능할까요? 아이디어는 실제로 비교적 단순합니다: 임의의 크기의 출력을 정의한 다음, latents의 마지막 hidden states를 사용하여 cross-attention을 적용합니다. 이때 출력은 query로, latents는 key와 value로 사용됩니다.
Perceiver로 masked language modeling(BERT 스타일)을 수행한다고 가정해 보겠습니다. Perceiver의 입력 길이는 self-attention 레이어의 계산 시간에 영향을 주지 않으므로, 모델에 `inputs`로 길이 2048의 raw bytes를 제공할 수 있습니다. 이제 이 2048개 토큰 중 일부를 mask하면, `outputs`의 shape을 `(batch_size, 2048, 768)`로 정의할 수 있습니다. 다음으로, latents의 최종 hidden states와 cross-attention을 수행하여 `outputs` 텐서를 업데이트합니다. cross-attention 이후에도 여전히 shape이 `(batch_size, 2048, 768)`인 텐서가 됩니다. 이 위에 일반적인 language modeling head를 올려 마지막 차원을 모델의 vocabulary size로 투영하면, 즉 shape이 `(batch_size, 2048, 262)`인 logits를 생성할 수 있습니다(Perceiver는 vocabulary size가 262인 byte ID를 사용하므로).
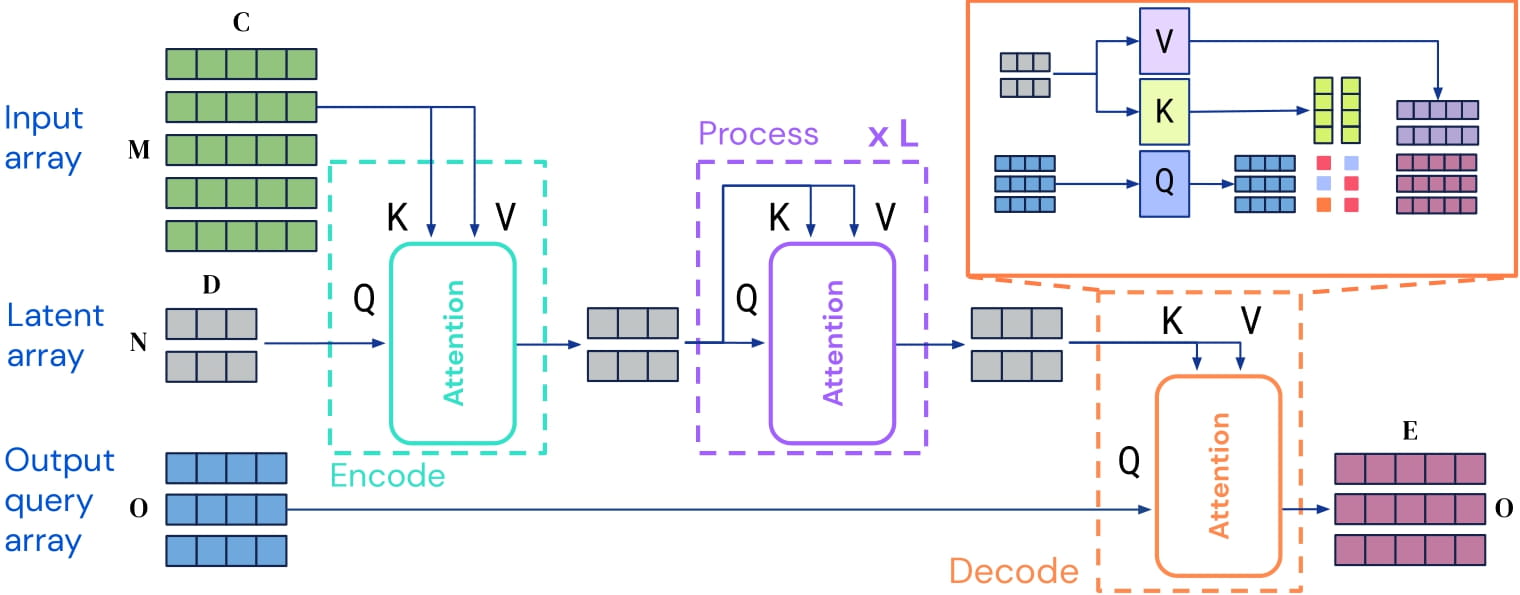 Perceiver IO 아키텍처. 원 논문에서 가져옴
이 모델은 [nielsr](https://huggingface.co/nielsr)에 의해 기여되었습니다. 원본 코드는 [여기](https://github.com/deepmind/deepmind-research/tree/master/perceiver)에서 찾을 수 있습니다.
PyTorch의 버그로 인해 Perceiver는 `torch.nn.DataParallel`과 **동작하지 않습니다**. [이슈 #36035](https://github.com/pytorch/pytorch/issues/36035)를 참조하세요.
## 리소스
- Perceiver를 가장 빠르게 시작하는 방법은 [tutorial notebooks](https://github.com/NielsRogge/Transformers-Tutorials/tree/master/Perceiver)를 확인하는 것입니다.
- 모델의 작동 방식을 완전히 이해하려면 [블로그 게시물](https://huggingface.co/blog/perceiver)을 참고하세요.
is implemented in the library. Note that the models available in the library only showcase some examples of what you can do with the Perceiver. There are many more use cases, including question answering, named-entity recognition, object detection, audio classification, video classification, etc.
- [텍스트 분류 작업 가이드](../tasks/sequence_classification)
- [마스크 언어 모델링 작업 가이드](../tasks/masked_language_modeling)
- [이미지 분류 작업 가이드](../tasks/image_classification)
## Perceiver 전용 출력[[transformers.models.perceiver.modeling_perceiver.PerceiverModelOutput]]
#### transformers.models.perceiver.modeling_perceiver.PerceiverModelOutput[[transformers.models.perceiver.modeling_perceiver.PerceiverModelOutput]]
```python
transformers.models.perceiver.modeling_perceiver.PerceiverModelOutput(logits: typing.Optional[torch.Tensor] = None, last_hidden_state: typing.Optional[torch.Tensor] = None, hidden_states: tuple[torch.Tensor] | None = None, attentions: tuple[torch.Tensor] | None = None, cross_attentions: tuple[torch.Tensor] | None = None)
```
[소스](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/perceiver/modeling_perceiver.py#L53)
**매개변수:**
logits (`torch.Tensor`, shape `(batch_size, num_labels)`) : SoftMax 적용 전 분류(또는 config.num_labels==1인 경우 회귀) 점수.
last_hidden_state (`torch.Tensor`, shape `(batch_size, sequence_length, hidden_size)`, *선택 사항*) : 모델의 마지막 레이어 출력에서 생성된 hidden-states 시퀀스.
hidden_states (`tuple[torch.Tensor]`, *선택 사항*, `output_hidden_states=True`가 전달되거나 `config.output_hidden_states=True`인 경우 반환됨) : `torch.Tensor`의 튜플(모델에 임베딩 레이어가 있는 경우 임베딩의 출력에 대한 것 1개 + 각 레이어의 출력에 대한 것 1개)로, 모양은 `(batch_size, sequence_length, hidden_size)`입니다. 각 레이어 출력 시점의 모델 hidden-states와 선택적인 초기 임베딩 출력을 포함합니다.
attentions (`tuple[torch.Tensor]`, *선택 사항*, `output_attentions=True`가 전달되었거나 `config.output_attentions=True`인 경우 반환됨) : `torch.Tensor`의 튜플(레이어당 하나), shape은 `(batch_size, num_heads, sequence_length, sequence_length)`입니다. attention softmax 이후의 attention 가중치로, self-attention 헤드에서 가중 평균을 계산하는 데 사용됩니다.
cross_attentions (`tuple[torch.Tensor]`, *선택 사항*, `output_attentions=True`가 전달되었거나 `config.output_attentions=True`인 경우 반환됨) : `torch.Tensor`의 Tuple (각 레이어마다 하나), shape은 `(batch_size, num_heads, sequence_length, sequence_length)`. attention softmax를 거친 decoder의 cross-attention 레이어의 attention 가중치로, cross-attention heads에서 가중 평균을 계산하는 데 사용됩니다.
숨겨진 상태, 어텐션 및 크로스 어텐션을 포함할 수 있는 Perceiver 기본 모델의 출력에 대한 기본 클래스입니다.
#### transformers.models.perceiver.modeling_perceiver.PerceiverDecoderOutput[[transformers.models.perceiver.modeling_perceiver.PerceiverDecoderOutput]]
```python
transformers.models.perceiver.modeling_perceiver.PerceiverDecoderOutput(logits: typing.Optional[torch.Tensor] = None, cross_attentions: tuple[torch.Tensor] | None = None)
```
[소스](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/perceiver/modeling_perceiver.py#L72)
**매개변수:**
logits (`torch.Tensor`, shape `(batch_size, num_labels)`) : 기본 decoder의 출력입니다.
cross_attentions (`tuple[torch.Tensor]`, *선택 사항*, `output_attentions=True`가 전달되었거나 `config.output_attentions=True`인 경우 반환됨) : `torch.Tensor`의 Tuple (각 레이어마다 하나), shape은 `(batch_size, num_heads, sequence_length, sequence_length)`. attention softmax를 거친 decoder의 cross-attention 레이어의 attention 가중치로, cross-attention heads에서 가중 평균을 계산하는 데 사용됩니다.
Perceiver 디코더 출력의 베이스 클래스로, 크로스 어텐션이 포함될 수 있습니다.
#### transformers.models.perceiver.modeling_perceiver.PerceiverMaskedLMOutput[[transformers.models.perceiver.modeling_perceiver.PerceiverMaskedLMOutput]]
```python
transformers.models.perceiver.modeling_perceiver.PerceiverMaskedLMOutput(loss: typing.Optional[torch.Tensor] = None, logits: typing.Optional[torch.Tensor] = None, hidden_states: tuple[torch.Tensor] | None = None, attentions: tuple[torch.Tensor] | None = None, cross_attentions: tuple[torch.Tensor] | None = None)
```
[소스](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/perceiver/modeling_perceiver.py#L88)
**매개변수:**
loss (`torch.Tensor`, shape `(1,)`, *선택*, `labels`가 제공될 때 반환됨) : Masked language modeling(MLM) 손실.
logits (`torch.Tensor`, shape `(batch_size, sequence_length, config.vocab_size)`) : 언어 모델링 헤드에 대한 예측 점수(SoftMax 적용 전 각 어휘 토큰의 점수).
hidden_states (`tuple[torch.Tensor]`, *선택 사항*, `output_hidden_states=True`가 전달되거나 `config.output_hidden_states=True`인 경우 반환됨) : `torch.Tensor`의 튜플(모델에 임베딩 레이어가 있는 경우 임베딩의 출력에 대한 것 1개 + 각 레이어의 출력에 대한 것 1개)로, 모양은 `(batch_size, sequence_length, hidden_size)`입니다. 각 레이어 출력 시점의 모델 hidden-states와 선택적인 초기 임베딩 출력을 포함합니다.
attentions (`tuple[torch.Tensor]`, *선택 사항*, `output_attentions=True`가 전달되었거나 `config.output_attentions=True`인 경우 반환됨) : `torch.Tensor`의 튜플(레이어당 하나), shape은 `(batch_size, num_heads, sequence_length, sequence_length)`입니다. attention softmax 이후의 attention 가중치로, self-attention 헤드에서 가중 평균을 계산하는 데 사용됩니다.
cross_attentions (`tuple[torch.Tensor]`, *선택 사항*, `output_attentions=True`가 전달되었거나 `config.output_attentions=True`인 경우 반환됨) : `torch.Tensor`의 Tuple (각 레이어마다 하나), shape은 `(batch_size, num_heads, sequence_length, sequence_length)`. attention softmax를 거친 decoder의 cross-attention 레이어의 attention 가중치로, cross-attention heads에서 가중 평균을 계산하는 데 사용됩니다.
Perceiver의 masked language model 출력을 위한 베이스 클래스입니다.
#### transformers.models.perceiver.modeling_perceiver.PerceiverClassifierOutput[[transformers.models.perceiver.modeling_perceiver.PerceiverClassifierOutput]]
```python
transformers.models.perceiver.modeling_perceiver.PerceiverClassifierOutput(loss: typing.Optional[torch.Tensor] = None, logits: typing.Optional[torch.Tensor] = None, hidden_states: tuple[torch.Tensor] | None = None, attentions: tuple[torch.Tensor] | None = None, cross_attentions: tuple[torch.Tensor] | None = None)
```
[소스](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/perceiver/modeling_perceiver.py#L110)
**매개변수:**
loss (`torch.Tensor`, shape `(1,)`, *선택*, `labels`가 제공될 때 반환됨) : 분류(또는 config.num_labels==1인 경우 회귀) 손실.
logits (`torch.Tensor`, shape `(batch_size, config.num_labels)`) : SoftMax 적용 전 분류(또는 config.num_labels==1인 경우 회귀) 점수.
hidden_states (`tuple[torch.Tensor]`, *선택 사항*, `output_hidden_states=True`가 전달되거나 `config.output_hidden_states=True`인 경우 반환됨) : `torch.Tensor`의 튜플(모델에 임베딩 레이어가 있는 경우 임베딩의 출력에 대한 것 1개 + 각 레이어의 출력에 대한 것 1개)로, 모양은 `(batch_size, sequence_length, hidden_size)`입니다. 각 레이어 출력 시점의 모델 hidden-states와 선택적인 초기 임베딩 출력을 포함합니다.
attentions (`tuple[torch.Tensor]`, *선택 사항*, `output_attentions=True`가 전달되었거나 `config.output_attentions=True`인 경우 반환됨) : `torch.Tensor`의 튜플(레이어당 하나), shape은 `(batch_size, num_heads, sequence_length, sequence_length)`입니다. attention softmax 이후의 attention 가중치로, self-attention 헤드에서 가중 평균을 계산하는 데 사용됩니다.
cross_attentions (`tuple[torch.Tensor]`, *선택 사항*, `output_attentions=True`가 전달되었거나 `config.output_attentions=True`인 경우 반환됨) : `torch.Tensor`의 Tuple (각 레이어마다 하나), shape은 `(batch_size, num_heads, sequence_length, sequence_length)`. attention softmax를 거친 decoder의 cross-attention 레이어의 attention 가중치로, cross-attention heads에서 가중 평균을 계산하는 데 사용됩니다.
시퀀스/이미지 분류 모델, 광학 흐름 및 멀티모달 오토인코딩의 Perceiver 출력에 대한 베이스 클래스
## PerceiverConfig[[transformers.PerceiverConfig]]
#### transformers.PerceiverConfig[[transformers.PerceiverConfig]]
```python
transformers.PerceiverConfig(transformers_version: str | None = None, architectures: list[str] | None = None, output_hidden_states: bool | None = False, return_dict: bool | None = True, dtype: str | torch.dtype | None = None, chunk_size_feed_forward: int = 0, is_encoder_decoder: bool = False, id2label: dict[int, str] | dict[str, str] | None = None, label2id: dict[str, int] | dict[str, str] | None = None, problem_type: Literal['regression', 'single_label_classification', 'multi_label_classification'] | None = None, num_latents: int = 256, d_latents: int = 1280, d_model: int = 768, num_blocks: int = 1, num_self_attends_per_block: int = 26, num_self_attention_heads: int = 8, num_cross_attention_heads: int = 8, qk_channels: int | None = None, v_channels: int | None = None, cross_attention_shape_for_attention: str = 'kv', self_attention_widening_factor: int = 1, cross_attention_widening_factor: int = 1, hidden_act: str = 'gelu', attention_probs_dropout_prob: float | int = 0.1, initializer_range: float = 0.02, layer_norm_eps: float = 1e-12, use_query_residual: bool = True, vocab_size: int = 262, max_position_embeddings: int = 2048, image_size: int | list[int] | tuple[int, int] = 56, train_size: list[int] | tuple[int, ...] = (368, 496), num_frames: int = 16, audio_samples_per_frame: int = 1920, samples_per_patch: int = 16, output_shape: list[int] | tuple[int, ...] = (1, 16, 224, 224), output_num_channels: int = 512, _label_trainable_num_channels: int = 1024)
```
[소스](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/perceiver/configuration_perceiver.py#L24)
**매개변수:**
num_latents (`int`, *선택 사항*, 기본값 256) : latent의 개수입니다.
d_latents (`int`, *선택 사항*, 기본값 1280) : 잠재 임베딩의 차원.
d_model (`int`, *선택 사항*, 기본값 `768`) : 인코더 레이어와 풀러 레이어의 크기입니다.
num_blocks (`int`, *선택 사항*, 기본값 1) : Transformer 인코더의 블록 수.
num_self_attends_per_block (`int`, *선택 사항*, 기본값 26) : 블록당 self-attention 레이어의 수입니다.
num_self_attention_heads (`int`, *선택 사항*, 기본값 8) : Transformer 인코더의 각 self-attention 레이어에 사용되는 attention head의 수.
num_cross_attention_heads (`int`, *선택 사항*, 기본값 8) : Transformer 인코더의 각 cross-attention 레이어에 사용할 attention head 수.
qk_channels (`int`, *선택 사항*) : 인코더의 크로스 어텐션 및 셀프 어텐션 레이어에서 어텐션을 적용하기 전에 쿼리와 키를 투영할 차원입니다. 지정되지 않으면 쿼리의 차원을 유지하는 것이 기본값입니다.
v_channels (`int`, *선택 사항*) : 인코더의 크로스 어텐션 및 셀프 어텐션 레이어에서 어텐션을 적용하기 전에 값을 투영할 차원입니다. 지정하지 않으면 쿼리의 차원을 유지하는 것이 기본값입니다.
cross_attention_shape_for_attention (`str`, *선택 사항*, 기본값 `"kv"`) : 인코더의 cross-attention 레이어에서 쿼리와 키를 다운샘플링할 때 사용할 차원.
self_attention_widening_factor (`int`, *선택 사항*, 기본값 1) : Transformer 인코더의 cross-attention 레이어에서 feed-forward 레이어의 차원.
cross_attention_widening_factor (`int`, *선택 사항*, 기본값 1) : Transformer 인코더의 self-attention 레이어에서 feed-forward 레이어의 차원.
hidden_act (`str`, *선택 사항*, 기본값 `gelu`) : 디코더에서 사용되는 비선형 활성화 함수(함수 또는 문자열). 예를 들어, `"gelu"`, `"relu"`, `"silu"` 등이 있습니다.
attention_probs_dropout_prob (`Union[float, int]`, *선택 사항*, 기본값 `0.1`) : attention 확률에 적용할 dropout 비율입니다.
initializer_range (`float`, *선택 사항*, 기본값 `0.02`) : 모든 가중치 행렬을 초기화하는 truncated_normal_initializer의 표준 편차입니다.
layer_norm_eps (`float`, *선택 사항*, 기본값 `1e-12`) : layer normalization 레이어에서 사용되는 epsilon 값입니다.
use_query_residual (`float`, *선택 사항*, 기본값 `True`) : 인코더의 크로스 어텐션 레이어에 쿼리 잔차를 추가할지 여부.
vocab_size (`int`, *선택 사항*, 기본값 `262`) : 모델의 어휘 크기입니다. `input_ids`로 표현할 수 있는 서로 다른 토큰의 수를 정의합니다.
max_position_embeddings (`int`, *선택 사항*, 기본값 `2048`) : 이 모델이 사용될 수 있는 최대 시퀀스 길이입니다.
image_size (`int`, *선택 사항*, 기본값 56) : [PerceiverForImageClassificationLearned](/docs/transformers/v5.23.0/ko/model_doc/perceiver#transformers.PerceiverForImageClassificationLearned)의 전처리 후 이미지 크기입니다.
train_size (`list[int]`, *선택 사항*, 기본값 `[368, 496]`) : 광류 모델의 이미지 학습 크기입니다.
num_frames (`int`, *선택 사항*, 기본값 16) : 멀티모달 오토인코딩 모델에 사용되는 비디오 프레임 수입니다.
audio_samples_per_frame (`int`, *선택 사항*, 기본값 1920) : 멀티모달 오토인코딩 모델에서 프레임당 오디오 샘플 수입니다.
samples_per_patch (`int`, *선택 사항*, 기본값 16) : 멀티모달 오토인코딩 모델을 위해 오디오를 전처리할 때 패치당 오디오 샘플 수.
output_shape (`list[int]`, *선택 사항*, 기본값 `[1, 16, 224, 224]`) : 멀티모달 오토인코딩 모델의 비디오 디코더 쿼리에 대한 출력의 형태(batch_size, num_frames, height, width)입니다. 이는 채널 차원을 제외합니다.
output_num_channels (`int`, *선택 사항*, 기본값 512) : 각 모달리티 디코더의 출력 채널 수.
이것은 PerceiverModel의 구성을 저장하기 위한 구성 클래스입니다. 지정된 인자에 따라 Perceiver 모델을 인스턴스화하여 모델 아키텍처를 정의하는 데 사용됩니다. 기본값으로 구성을 인스턴스화하면 [deepmind/language-perceiver](https://huggingface.co/deepmind/language-perceiver)와 유사한 구성이 생성됩니다.
Configuration 객체는 [PreTrainedConfig](/docs/transformers/v5.23.0/ko/main_classes/configuration#transformers.PreTrainedConfig)를 상속하며, 모델 출력을 제어하는 데 사용할 수 있습니다. 자세한 내용은 [PreTrainedConfig](/docs/transformers/v5.23.0/ko/main_classes/configuration#transformers.PreTrainedConfig)의 문서를 참고하세요.
예:
```python
>>> from transformers import PerceiverModel, PerceiverConfig
>>> # Initializing a Perceiver deepmind/language-perceiver style configuration
>>> configuration = PerceiverConfig()
>>> # Initializing a model from the deepmind/language-perceiver style configuration
>>> model = PerceiverModel(configuration)
>>> # Accessing the model configuration
>>> configuration = model.config
```
## PerceiverTokenizer[[transformers.PerceiverTokenizer]]
#### transformers.PerceiverTokenizer[[transformers.PerceiverTokenizer]]
```python
transformers.PerceiverTokenizer(pad_token = '[PAD]', bos_token = '[BOS]', eos_token = '[EOS]', mask_token = '[MASK]', cls_token = '[CLS]', sep_token = '[SEP]', model_max_length = 2048, **kwargs)
```
[소스](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/perceiver/tokenization_perceiver.py#L23)
**매개변수:**
pad_token (`str`, *선택 사항*, 기본값 `"[PAD]"`) : 패딩에 사용되는 토큰입니다. 예를 들어, 길이가 다른 시퀀스를 배치할 때 사용됩니다.
bos_token (`str`, *선택 사항*, 기본값 `"[BOS]"`) : BOS 토큰(어휘에 예약되어 있지만 실제로는 사용되지 않음).
eos_token (`str`, *선택 사항*, 기본값 `"[EOS]"`) : 시퀀스 종료 토큰(어휘에 예약되어 있지만 실제로는 사용되지 않음). 특수 토큰을 사용하여 시퀀스를 구성할 때, 시퀀스 종료에 사용되는 토큰은 이 토큰이 아닙니다. 사용되는 토큰은 `sep_token`입니다.
mask_token (`str`, *선택 사항*, 기본값 `"[MASK]"`) : masked language modeling에 유용한 MASK 토큰입니다.
cls_token (`str`, *선택 사항*, 기본값 `"[CLS]"`) : CLS 토큰(어휘에 예약되어 있지만 실제로는 사용되지 않음).
sep_token (`str`, *선택 사항*, 기본값 `"[SEP]"`) : 두 시퀀스로 시퀀스를 구성할 때 사용되는 구분자 토큰입니다.
Perceiver 토크나이저를 구성합니다. Perceiver는 단순히 원시 바이트의 utf-8 인코딩을 사용합니다.
이 토크나이저는 대부분의 주요 메서드를 포함하는 [PreTrainedTokenizer](/docs/transformers/v5.23.0/ko/main_classes/tokenizer#transformers.PythonBackend)를 상속합니다. 해당 메서드에 대한 자세한 정보는 이 상위 클래스를 참고하세요.
#### __call__[[transformers.PerceiverTokenizer.__call__]]
```python
__call__(text: TextInput | PreTokenizedInput | list[TextInput] | list[PreTokenizedInput] | None = None, text_pair: TextInput | PreTokenizedInput | list[TextInput] | list[PreTokenizedInput] | None = None, text_target: TextInput | PreTokenizedInput | list[TextInput] | list[PreTokenizedInput] | None = None, text_pair_target: TextInput | PreTokenizedInput | list[TextInput] | list[PreTokenizedInput] | None = None, add_special_tokens: bool = True, padding: bool | str | PaddingStrategy = False, truncation: bool | str | TruncationStrategy | None = None, max_length: int | None = None, stride: int = 0, is_split_into_words: bool = False, pad_to_multiple_of: int | None = None, padding_side: str | None = None, return_tensors: str | TensorType | None = None, return_token_type_ids: bool | None = None, return_attention_mask: bool | None = None, return_overflowing_tokens: bool = False, return_special_tokens_mask: bool = False, return_offsets_mapping: bool = False, return_length: bool = False, verbose: bool = True, tokenizer_kwargs: dict[str, Any] | None = None, **kwargs)
```
[소스](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/tokenization_utils_base.py#L2448)
**매개변수:**
text (`str`, `list[str]`, `list[list[str]]`, *선택*) : 인코딩할 시퀀스 또는 시퀀스 배치입니다. 각 시퀀스는 문자열 또는 문자열 목록(사전 토큰화된 문자열)일 수 있습니다. 시퀀스가 문자열 목록(사전 토큰화)로 제공되는 경우, `is_split_into_words=True`를 설정해야 합니다(시퀀스 배치와의 모호성을 제거하기 위함).
text_pair (`str`, `list[str]`, `list[list[str]]`, *선택*) : 인코딩할 시퀀스 또는 시퀀스 배치입니다. 각 시퀀스는 문자열 또는 문자열 목록(사전 토큰화된 문자열)일 수 있습니다. 시퀀스가 문자열 목록(사전 토큰화)로 제공되는 경우, `is_split_into_words=True`를 설정해야 합니다(시퀀스 배치와의 모호성을 제거하기 위함).
text_target (`str`, `list[str]`, `list[list[str]]`, *선택*) : 대상 텍스트로 인코딩할 시퀀스 또는 시퀀스 배치입니다. 각 시퀀스는 문자열 또는 문자열 목록(사전 토큰화된 문자열)일 수 있습니다. 시퀀스가 문자열 목록(사전 토큰화)로 제공되는 경우, `is_split_into_words=True`를 설정해야 합니다(시퀀스 배치와의 모호성을 제거하기 위함).
text_pair_target (`str`, `list[str]`, `list[list[str]]`, *선택*) : 대상 텍스트로 인코딩할 시퀀스 또는 시퀀스 배치입니다. 각 시퀀스는 문자열 또는 문자열 목록(사전 토큰화된 문자열)일 수 있습니다. 시퀀스가 문자열 목록(사전 토큰화)로 제공되는 경우, `is_split_into_words=True`를 설정해야 합니다(시퀀스 배치와의 모호성을 제거하기 위함).
tokenizer_kwargs (`dict[str, Any]`, *선택*) : 토크나이저에 전달할 추가 kwargs입니다. 명시적 매개변수 및 기타 kwargs와 병합되며, 명시적 매개변수가 우선합니다.
add_special_tokens (`bool`, *선택 사항*, 기본값 `True`) : 시퀀스를 인코딩할 때 특수 토큰을 추가할지 여부입니다. 이는 입력 id에 자동으로 추가되는 토큰을 정의하는 기반 `PretrainedTokenizerBase.build_inputs_with_special_tokens` 함수를 사용합니다. `bos` 또는 `eos` 토큰을 자동으로 추가하려는 경우 유용합니다.
padding (`bool`, `str` 또는 [PaddingStrategy](/docs/transformers/v5.23.0/ko/internal/file_utils#transformers.utils.PaddingStrategy), *optional*, 기본값 `False`) : 패딩을 활성화하고 제어합니다. 다음 값을 허용합니다: - `True` 또는 `'longest'`: 배치 내 가장 긴 시퀀스 길이로 패딩합니다(단일 시퀀스만 제공된 경우 패딩하지 않음). - `'max_length'`: `max_length` 인수로 지정된 최대 길이로 패딩하거나, 해당 인수가 제공되지 않으면 모델이 허용하는 최대 입력 길이로 패딩합니다. - `False` 또는 `'do_not_pad'` (기본값): 패딩하지 않음(즉, 서로 다른 길이의 시퀀스를 가진 배치를 출력할 수 있음).
truncation (`bool`, `str` 또는 [TruncationStrategy](/docs/transformers/v5.23.0/ko/internal/tokenization_utils#transformers.tokenization_utils_base.TruncationStrategy), *optional*, 기본값 `False`) : 잘림(truncation)을 활성화하고 제어합니다. 다음 값을 허용합니다: - `True` 또는 `'longest_first'`: `max_length` 인수로 지정된 최대 길이로 잘거나, 해당 인수가 제공되지 않으면 모델이 허용하는 최대 입력 길이로 잘릅니다. 이 경우 토큰 단위로 잘리며, 시퀀스 쌍(또는 쌍의 배치)이 제공되면 쌍에서 가장 긴 시퀀스에서 토큰을 하나씩 제거합니다. - `'only_first'`: `max_length` 인수로 지정된 최대 길이로 잘거나, 해당 인수가 제공되지 않으면 모델이 허용하는 최대 입력 길이로 잘릅니다. 이 경우 시퀀스 쌍(또는 쌍의 배치)이 제공되면 쌍의 첫 번째 시퀀스만 잘릅니다. - `'only_second'`: `max_length` 인수로 지정된 최대 길이로 잘거나, 해당 인수가 제공되지 않으면 모델이 허용하는 최대 입력 길이로 잘릅니다. 이 경우 시퀀스 쌍(또는 쌍의 배치)이 제공되면 쌍의 두 번째 시퀀스만 잘릅니다. - `False` 또는 `'do_not_truncate'` (기본값): 잘리지 않습니다(즉, 모델이 허용하는 최대 입력 크기보다 긴 시퀀스 길이를 가진 배치를 출력할 수 있습니다).
max_length (`int`, *선택 사항*) : truncation/padding 매개변수 중 하나가 사용할 최대 길이를 제어합니다. 설정하지 않거나 `None`으로 설정한 경우, truncation/padding 매개변수 중 하나가 최대 길이를 요구하면 미리 정의된 모델 최대 길이를 사용합니다. 모델에 특정 최대 입력 길이가 없는 경우(XLNet 등) 최대 길이로 truncation/padding하는 기능이 비활성화됩니다.
stride (`int`, *선택 사항*, 기본값 0) : `max_length`와 함께 숫자로 설정하면, `return_overflowing_tokens=True`일 때 반환되는 오버플로 토큰에는 잘림된 시퀀스로 반환되는 시퀀스의 끝부분에서 가져온 일부 토큰이 포함되어 잘림된 시퀀스와 오버플로 시퀀스 사이에 일부 중복이 제공됩니다. 이 인수의 값은 중복되는 토큰의 수를 정의합니다.
is_split_into_words (`bool`, *선택 사항*, 기본값 `False`) : 입력이 이미 사전 토큰화(예: 단어 단위로 분리)되었는지 여부입니다. `True`로 설정하면, 토크나이저는 입력이 이미 단어 단위로 분리되어 있다고 가정하고(예: 공백 기준으로 분리) 이를 토큰화합니다. 이는 NER 또는 토큰 분류에 유용합니다.
pad_to_multiple_of (`int`, *선택 사항*) : 설정 시 시퀀스를 제공된 값의 배수로 패딩합니다. `padding`이 활성화되어 있어야 합니다. 이는 Volta에서 `>= 7.5`의 컴퓨트 캐퍼빌리티를 가진 NVIDIA 하드웨어에서 Tensor Cores 사용을 활성화하는 데 특히 유용합니다.
padding_side (`str`, *선택 사항*) : 모델에 패딩을 적용할 쪽입니다. ['right', 'left'] 중에서 선택해야 합니다. 기본값은 동일한 이름의 클래스 속성에서 가져옵니다.
return_tensors (`str` 또는 [TensorType](/docs/transformers/v5.23.0/ko/internal/file_utils#transformers.TensorType), *optional*) : 설정된 경우, python 정수 목록 대신 텐서를 반환합니다. 허용되는 값은 다음과 같습니다: - `'pt'`: PyTorch `torch.Tensor` 객체를 반환합니다. - `'np'`: Numpy `np.ndarray` 객체를 반환합니다.
return_token_type_ids (`bool`, *선택 사항*) : 토큰 타입 ID를 반환할지 여부입니다. 기본값으로 두면, `return_outputs` 속성으로 정의된 해당 토크나이저의 기본값에 따라 토큰 타입 ID를 반환합니다. [토큰 타입 ID란 무엇인가요?](../glossary#token-type-ids)
return_attention_mask (`bool`, *선택 사항*) : attention mask를 반환할지 여부입니다. 기본값으로 두면, `return_outputs` 속성으로 정의된 해당 tokenizer의 기본값에 따라 attention mask를 반환합니다. [attention mask란 무엇인가요?](../glossary#attention-mask)
return_overflowing_tokens (`bool`, *선택 사항*, 기본값 `False`) : 넘친 토큰 시퀀스를 반환할지 여부입니다. 입력 ID의 시퀀스 쌍(또는 쌍의 배치)이 `truncation_strategy = longest_first` 또는 `True`와 함께 제공되면, 넘친 토큰을 반환하는 대신 오류가 발생합니다.
return_special_tokens_mask (`bool`, *선택 사항*, 기본값 `False`) : 특수 토큰 마스크 정보를 반환할지 여부.
return_offsets_mapping (`bool`, *선택 사항*, 기본값 `False`) : 각 토큰에 대해 `(char_start, char_end)`를 반환할지 여부입니다. 이 기능은 [PreTrainedTokenizerFast](/docs/transformers/v5.23.0/ko/main_classes/tokenizer#transformers.TokenizersBackend)를 상속하는 fast tokenizer에서만 사용할 수 있으며, Python의 tokenizer를 사용하는 경우 이 메서드는 `NotImplementedError`를 발생시킵니다.
return_length (`bool`, *선택 사항*, 기본값 `False`) : 인코딩된 입력의 길이를 반환할지 여부.
verbose (`bool`, *선택 사항*, 기본값 `True`) : 추가 정보와 경고를 출력할지 여부.
- ****kwargs** : `self.tokenize()` 메서드에 전달됩니다
**반환값:** [BatchEncoding](/docs/transformers/v5.23.0/ko/main_classes/tokenizer#transformers.BatchEncoding)
다음 필드를 가진 [BatchEncoding](/docs/transformers/v5.23.0/ko/main_classes/tokenizer#transformers.BatchEncoding):
- **input_ids** -- 모델에 입력할 토큰 ID 목록.
[입력 ID란 무엇인가요?](../glossary#input-ids)
- **token_type_ids** -- 모델에 입력할 토큰 유형 ID 목록(`return_token_type_ids=True`인 경우 또는 `self.model_input_names`에 *"token_type_ids"*가 포함된 경우).
[토큰 타입 ID란 무엇인가요?](../glossary#token-type-ids)
- **attention_mask** -- 모델이 어떤 토큰에 주의를 기울여야 하는지 지정하는 인덱스 목록(`return_attention_mask=True`인 경우 또는 `self.model_input_names`에 *"attention_mask"*가 포함된 경우).
[어텐션 마스크란 무엇인가요?](../glossary#attention-mask)
- **overflowing_tokens** -- 넘친 토큰 시퀀스 목록(`max_length`이 지정되고 `return_overflowing_tokens=True`인 경우).
- **num_truncated_tokens** -- 잘림된 토큰의 개수(`max_length`가 지정되고 `return_overflowing_tokens=True`인 경우).
- **special_tokens_mask** -- 0과 1의 목록으로, 1은 추가된 특수 토큰을, 0은 일반 시퀀스 토큰을 나타냅니다(`add_special_tokens=True`이고 `return_special_tokens_mask=True`인 경우).
- **length** -- 입력의 길이 (`return_length=True`인 경우)
하나 이상의 시퀀스 또는 하나 이상의 시퀀스 쌍을 토큰화하고 모델에 맞게 준비하는 주요 메서드입니다.
## PerceiverImageProcessor[[transformers.PerceiverImageProcessor]]
#### transformers.PerceiverImageProcessor[[transformers.PerceiverImageProcessor]]
```python
transformers.PerceiverImageProcessor(**kwargs: *)
```
[소스](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/perceiver/image_processing_perceiver.py#L33)
**매개변수:**
do_convert_rgb (`bool`, *kwargs*, *선택*) : 이미지를 RGB로 변환할지 여부.
do_resize (`bool`, *kwargs*, *선택 사항*, 기본값 `True`) : 이미지를 리사이즈할지 여부.
size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*, 기본값 `{'height' : 224, 'width': 224}`): 모델에 대한 최대 입력 차원을 설명합니다.
default_to_square (`bool`, *kwargs*, *선택 사항*, 기본값 `True`) : size가 int인 경우 리사이즈 시 정사각형 이미지로 설정할지 여부.
crop_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*, 기본값 `{'height' : 256, 'width': 256}`): `center_crop`를 적용한 후 출력 이미지의 크기.
resample (`Annotated[Union[int, PILImageResampling, NoneType], None]`, *kwargs*, 기본값 `3`) : 이미지를 리사이즈할 때 사용할 리샘플링 필터입니다. `PILImageResampling` enum 중 하나를 사용할 수 있습니다. `do_resize`가 `True`로 설정된 경우에만 효과가 있습니다.
do_rescale (`bool`, *kwargs*, *선택 사항*, 기본값 `True`) : 이미지를 다시 스케일링할지 여부.
rescale_factor (`float`, *kwargs*, *선택 사항*, 기본값 `0.00392156862745098`) : `do_rescale`이 `True`로 설정된 경우 이미지를 재조정하는 데 사용되는 재조정 계수입니다.
do_normalize (`bool`, *kwargs*, *선택 사항*, 기본값 `True`) : 이미지를 정규화할지 여부.
image_mean (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *선택 사항*, 기본값은 `[0.485, 0.456, 0.406]`) : 정규화에 사용할 이미지 평균입니다. `do_normalize`가 `True`로 설정된 경우에만 효과가 있습니다.
image_std (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *선택 사항*, 기본값은 `[0.229, 0.224, 0.225]`) : 정규화에 사용할 이미지 표준 편차입니다. `do_normalize`가 `True`로 설정된 경우에만 효과가 있습니다.
do_pad (`bool`, *kwargs*, *선택*) : 이미지를 패딩할지 여부입니다. 패딩은 배치 내 가장 큰 크기로 수행하거나, 이미지마다 고정된 정사각형 크기로 수행합니다. 정확한 패딩 전략은 모델에 따라 달라집니다.
pad_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : 이미지를 패딩할 `{"height": int, "width" int}` 크기를 지정합니다. 전처리용으로 제공된 모든 이미지 크기보다 커야 합니다. `pad_size`가 제공되지 않으면, 이미지는 배치 내 가장 큰 높이와 너비로 패딩됩니다. `do_pad=True.`일 때만 적용됩니다.
do_center_crop (`bool`, *kwargs*, *선택 사항*, 기본값 `True`) : 이미지를 중앙 크롭할지 여부.
data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *선택*) : `ChannelDimension.FIRST`만 지원됩니다. 느린 프로세서와의 호환성을 위해 추가되었습니다.
input_data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *선택*) : 입력 이미지의 채널 차원 형식입니다. 설정하지 않으면 입력 이미지에서 채널 차원 형식을 추론합니다. 다음 중 하나일 수 있습니다: - `"channels_first"` 또는 `ChannelDimension.FIRST`: (num_channels, height, width) 형식의 이미지. - `"channels_last"` 또는 `ChannelDimension.LAST`: (height, width, num_channels) 형식의 이미지. - `"none"` 또는 `ChannelDimension.NONE`: (height, width) 형식의 이미지.
device (`Annotated[Union[str, torch.device, NoneType], None]`, *kwargs*) : 비디오를 처리할 장치입니다. 설정되지 않은 경우, 입력 비디오에서 장치를 추론합니다.
return_tensors (`Annotated[str | ~utils.generic.TensorType | None, None]`, *kwargs*) : `'pt'`로 설정된 경우 스택된 텐서를 반환하고, 그렇지 않으면 텐서 목록을 반환합니다.
disable_grouping (`bool`, *kwargs*, *선택*) : 이미지의 크기에 따른 그룹화를 비활성화하여 이미지를 배치 대신 개별적으로 처리할지 여부입니다. None인 경우, 이미지가 CPU에 있으면 True, 그렇지 않으면 False로 설정됩니다. 이 선택은 https://github.com/huggingface/transformers/pull/38157에 자세히 설명된 경험적 관찰에 기반합니다.
image_seq_length (`int`, *kwargs*, *선택*) : 입력의 각 이미지에 사용할 이미지 토큰의 수입니다. 하위 호환성을 위해 추가되었지만, 향후 모델에서는 프로세서 속성으로 설정해야 합니다.
PerceiverImageProcessor 이미지 프로세서를 생성합니다.
#### preprocess[[transformers.PerceiverImageProcessor.preprocess]]
```python
preprocess(images: typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor']], *args, image_like_kwargs: dict[str, typing.Any] | None = None, **kwargs: *)
```
[소스](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/image_processing_utils.py#L382)
**매개변수:**
images (`Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor]]`) : 전처리할 이미지. 픽셀 값이 0에서 255 범위로 이루어진 단일 이미지 또는 배치 이미지를 기대합니다. 픽셀 값이 0에서 1 범위로 이루어진 이미지를 전달하는 경우 `do_rescale=False`로 설정하세요.
image_like_kwargs (`dict[str, Any]`, *선택*) : 추가 이미지 형식 입력을 전처리할 때 사용하는 개발자 플래그입니다. 입력을 kwarg로 전달하는 것이 작동하지 않을 때만 사용하세요. 예를 들어, `preprocess(images, masks=masks)`가 권장되는 방식이지만 일부 모델에서는 인자 우선순위 문제가 발생할 수 있습니다. 이러한 경우 대신 `preprocess(images, image_like_inputs={"masks": masks})`를 사용할 수 있습니다.
do_convert_rgb (`bool`, *kwargs*, *선택*) : 이미지를 RGB로 변환할지 여부.
do_resize (`bool`, *kwargs*, *선택*) : 이미지를 리사이즈할지 여부.
size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : 모델의 최대 입력 차원을 설명합니다.
default_to_square (`bool`, *kwargs*, *선택*) : size가 int인 경우 리사이즈 시 정사각형 이미지로 기본 설정할지 여부.
crop_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : `center_crop`를 적용한 후의 출력 이미지 크기.
resample (`Annotated[Union[int, PILImageResampling, NoneType], None]`, *kwargs*) : 이미지를 리사이즈할 때 사용할 리샘플링 필터입니다. `PILImageResampling` enum 중 하나를 사용할 수 있습니다. `do_resize`가 `True`로 설정된 경우에만 효과가 있습니다.
do_rescale (`bool`, *kwargs*, *선택*) : 이미지를 다시 스케일링할지 여부.
rescale_factor (`float`, *kwargs*, *선택*) : `do_rescale`가 `True`로 설정된 경우 이미지를 재조정하는 데 사용되는 재조정 계수입니다.
do_normalize (`bool`, *kwargs*, *선택*) : 이미지를 정규화할지 여부.
image_mean (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *선택*) : 정규화에 사용할 이미지 평균값. `do_normalize`이 `True`로 설정된 경우에만 효과가 있습니다.
image_std (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *선택*) : 정규화에 사용할 이미지 표준 편차. `do_normalize`가 `True`로 설정된 경우에만 효과가 있습니다.
do_pad (`bool`, *kwargs*, *선택*) : 이미지를 패딩할지 여부입니다. 패딩은 배치 내 가장 큰 크기로 수행하거나, 이미지마다 고정된 정사각형 크기로 수행합니다. 정확한 패딩 전략은 모델에 따라 달라집니다.
pad_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : 이미지를 패딩할 `{"height": int, "width" int}` 크기를 지정합니다. 전처리용으로 제공된 모든 이미지 크기보다 커야 합니다. `pad_size`가 제공되지 않으면, 이미지는 배치 내 가장 큰 높이와 너비로 패딩됩니다. `do_pad=True.`일 때만 적용됩니다.
do_center_crop (`bool`, *kwargs*, *선택*) : 이미지를 중앙 크롭할지 여부.
data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *선택*) : `ChannelDimension.FIRST`만 지원됩니다. 느린 프로세서와의 호환성을 위해 추가되었습니다.
input_data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *선택*) : 입력 이미지의 채널 차원 형식입니다. 설정하지 않으면 입력 이미지에서 채널 차원 형식을 추론합니다. 다음 중 하나일 수 있습니다: - `"channels_first"` 또는 `ChannelDimension.FIRST`: (num_channels, height, width) 형식의 이미지. - `"channels_last"` 또는 `ChannelDimension.LAST`: (height, width, num_channels) 형식의 이미지. - `"none"` 또는 `ChannelDimension.NONE`: (height, width) 형식의 이미지.
device (`Annotated[Union[str, torch.device, NoneType], None]`, *kwargs*) : 비디오를 처리할 장치입니다. 설정되지 않은 경우, 입력 비디오에서 장치를 추론합니다.
return_tensors (`Annotated[str | ~utils.generic.TensorType | None, None]`, *kwargs*) : `'pt'`로 설정된 경우 스택된 텐서를 반환하고, 그렇지 않으면 텐서 목록을 반환합니다.
disable_grouping (`bool`, *kwargs*, *선택*) : 이미지의 크기에 따른 그룹화를 비활성화하여 이미지를 배치 대신 개별적으로 처리할지 여부입니다. None인 경우, 이미지가 CPU에 있으면 True, 그렇지 않으면 False로 설정됩니다. 이 선택은 https://github.com/huggingface/transformers/pull/38157에 자세히 설명된 경험적 관찰에 기반합니다.
image_seq_length (`int`, *kwargs*, *선택*) : 입력의 각 이미지에 사용할 이미지 토큰의 수입니다. 하위 호환성을 위해 추가되었지만, 향후 모델에서는 프로세서 속성으로 설정해야 합니다.
**반환값:** `~image_processing_base.BatchFeature`
- **data** (`dict`) -- __call__ 메서드가 반환하는 리스트/배열/텐서 딕셔너리('pixel_values' 등).
- **tensor_type** (`Union[None, str, TensorType]`, *선택 사항*) -- 초기화 시 PyTorch/Numpy 텐서에서 정수 목록을 변환하려면 여기에 tensor_type을 지정할 수 있습니다.
이미지 또는 이미지 배치(batch)를 전처리합니다.
## PerceiverImageProcessorPil[[transformers.PerceiverImageProcessorPil]]
#### transformers.PerceiverImageProcessorPil[[transformers.PerceiverImageProcessorPil]]
```python
transformers.PerceiverImageProcessorPil(**kwargs: *)
```
[소스](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/perceiver/image_processing_pil_perceiver.py#L31)
**매개변수:**
do_convert_rgb (`bool`, *kwargs*, *선택*) : 이미지를 RGB로 변환할지 여부.
do_resize (`bool`, *kwargs*, *선택 사항*, 기본값 `True`) : 이미지를 리사이즈할지 여부.
size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*, 기본값 `{'height' : 224, 'width': 224}`): 모델에 대한 최대 입력 차원을 설명합니다.
default_to_square (`bool`, *kwargs*, *선택 사항*, 기본값 `True`) : size가 int인 경우 리사이즈 시 정사각형 이미지로 설정할지 여부.
crop_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*, 기본값 `{'height' : 256, 'width': 256}`): `center_crop`를 적용한 후 출력 이미지의 크기.
resample (`Annotated[Union[int, PILImageResampling, NoneType], None]`, *kwargs*, 기본값 `3`) : 이미지를 리사이즈할 때 사용할 리샘플링 필터입니다. `PILImageResampling` enum 중 하나를 사용할 수 있습니다. `do_resize`가 `True`로 설정된 경우에만 효과가 있습니다.
do_rescale (`bool`, *kwargs*, *선택 사항*, 기본값 `True`) : 이미지를 다시 스케일링할지 여부.
rescale_factor (`float`, *kwargs*, *선택 사항*, 기본값 `0.00392156862745098`) : `do_rescale`이 `True`로 설정된 경우 이미지를 재조정하는 데 사용되는 재조정 계수입니다.
do_normalize (`bool`, *kwargs*, *선택 사항*, 기본값 `True`) : 이미지를 정규화할지 여부.
image_mean (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *선택 사항*, 기본값은 `[0.485, 0.456, 0.406]`) : 정규화에 사용할 이미지 평균입니다. `do_normalize`가 `True`로 설정된 경우에만 효과가 있습니다.
image_std (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *선택 사항*, 기본값은 `[0.229, 0.224, 0.225]`) : 정규화에 사용할 이미지 표준 편차입니다. `do_normalize`가 `True`로 설정된 경우에만 효과가 있습니다.
do_pad (`bool`, *kwargs*, *선택*) : 이미지를 패딩할지 여부입니다. 패딩은 배치 내 가장 큰 크기로 수행하거나, 이미지마다 고정된 정사각형 크기로 수행합니다. 정확한 패딩 전략은 모델에 따라 달라집니다.
pad_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : 이미지를 패딩할 `{"height": int, "width" int}` 크기를 지정합니다. 전처리용으로 제공된 모든 이미지 크기보다 커야 합니다. `pad_size`가 제공되지 않으면, 이미지는 배치 내 가장 큰 높이와 너비로 패딩됩니다. `do_pad=True.`일 때만 적용됩니다.
do_center_crop (`bool`, *kwargs*, *선택 사항*, 기본값 `True`) : 이미지를 중앙 크롭할지 여부.
data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *선택*) : `ChannelDimension.FIRST`만 지원됩니다. 느린 프로세서와의 호환성을 위해 추가되었습니다.
input_data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *선택*) : 입력 이미지의 채널 차원 형식입니다. 설정하지 않으면 입력 이미지에서 채널 차원 형식을 추론합니다. 다음 중 하나일 수 있습니다: - `"channels_first"` 또는 `ChannelDimension.FIRST`: (num_channels, height, width) 형식의 이미지. - `"channels_last"` 또는 `ChannelDimension.LAST`: (height, width, num_channels) 형식의 이미지. - `"none"` 또는 `ChannelDimension.NONE`: (height, width) 형식의 이미지.
device (`Annotated[Union[str, torch.device, NoneType], None]`, *kwargs*) : 비디오를 처리할 장치입니다. 설정되지 않은 경우, 입력 비디오에서 장치를 추론합니다.
return_tensors (`Annotated[str | ~utils.generic.TensorType | None, None]`, *kwargs*) : `'pt'`로 설정된 경우 스택된 텐서를 반환하고, 그렇지 않으면 텐서 목록을 반환합니다.
disable_grouping (`bool`, *kwargs*, *선택*) : 이미지의 크기에 따른 그룹화를 비활성화하여 이미지를 배치 대신 개별적으로 처리할지 여부입니다. None인 경우, 이미지가 CPU에 있으면 True, 그렇지 않으면 False로 설정됩니다. 이 선택은 https://github.com/huggingface/transformers/pull/38157에 자세히 설명된 경험적 관찰에 기반합니다.
image_seq_length (`int`, *kwargs*, *선택*) : 입력의 각 이미지에 사용할 이미지 토큰의 수입니다. 하위 호환성을 위해 추가되었지만, 향후 모델에서는 프로세서 속성으로 설정해야 합니다.
PerceiverImageProcessor 이미지 프로세서를 생성합니다.
#### preprocess[[transformers.PerceiverImageProcessorPil.preprocess]]
```python
preprocess(images: typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor']], *args, image_like_kwargs: dict[str, typing.Any] | None = None, **kwargs: *)
```
[소스](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/image_processing_utils.py#L382)
**매개변수:**
images (`Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor]]`) : 전처리할 이미지. 픽셀 값이 0에서 255 범위로 이루어진 단일 이미지 또는 배치 이미지를 기대합니다. 픽셀 값이 0에서 1 범위로 이루어진 이미지를 전달하는 경우 `do_rescale=False`로 설정하세요.
image_like_kwargs (`dict[str, Any]`, *선택*) : 추가 이미지 형식 입력을 전처리할 때 사용하는 개발자 플래그입니다. 입력을 kwarg로 전달하는 것이 작동하지 않을 때만 사용하세요. 예를 들어, `preprocess(images, masks=masks)`가 권장되는 방식이지만 일부 모델에서는 인자 우선순위 문제가 발생할 수 있습니다. 이러한 경우 대신 `preprocess(images, image_like_inputs={"masks": masks})`를 사용할 수 있습니다.
do_convert_rgb (`bool`, *kwargs*, *선택*) : 이미지를 RGB로 변환할지 여부.
do_resize (`bool`, *kwargs*, *선택*) : 이미지를 리사이즈할지 여부.
size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : 모델의 최대 입력 차원을 설명합니다.
default_to_square (`bool`, *kwargs*, *선택*) : size가 int인 경우 리사이즈 시 정사각형 이미지로 기본 설정할지 여부.
crop_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : `center_crop`를 적용한 후의 출력 이미지 크기.
resample (`Annotated[Union[int, PILImageResampling, NoneType], None]`, *kwargs*) : 이미지를 리사이즈할 때 사용할 리샘플링 필터입니다. `PILImageResampling` enum 중 하나를 사용할 수 있습니다. `do_resize`가 `True`로 설정된 경우에만 효과가 있습니다.
do_rescale (`bool`, *kwargs*, *선택*) : 이미지를 다시 스케일링할지 여부.
rescale_factor (`float`, *kwargs*, *선택*) : `do_rescale`가 `True`로 설정된 경우 이미지를 재조정하는 데 사용되는 재조정 계수입니다.
do_normalize (`bool`, *kwargs*, *선택*) : 이미지를 정규화할지 여부.
image_mean (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *선택*) : 정규화에 사용할 이미지 평균값. `do_normalize`이 `True`로 설정된 경우에만 효과가 있습니다.
image_std (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *선택*) : 정규화에 사용할 이미지 표준 편차. `do_normalize`가 `True`로 설정된 경우에만 효과가 있습니다.
do_pad (`bool`, *kwargs*, *선택*) : 이미지를 패딩할지 여부입니다. 패딩은 배치 내 가장 큰 크기로 수행하거나, 이미지마다 고정된 정사각형 크기로 수행합니다. 정확한 패딩 전략은 모델에 따라 달라집니다.
pad_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : 이미지를 패딩할 `{"height": int, "width" int}` 크기를 지정합니다. 전처리용으로 제공된 모든 이미지 크기보다 커야 합니다. `pad_size`가 제공되지 않으면, 이미지는 배치 내 가장 큰 높이와 너비로 패딩됩니다. `do_pad=True.`일 때만 적용됩니다.
do_center_crop (`bool`, *kwargs*, *선택*) : 이미지를 중앙 크롭할지 여부.
data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *선택*) : `ChannelDimension.FIRST`만 지원됩니다. 느린 프로세서와의 호환성을 위해 추가되었습니다.
input_data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *선택*) : 입력 이미지의 채널 차원 형식입니다. 설정하지 않으면 입력 이미지에서 채널 차원 형식을 추론합니다. 다음 중 하나일 수 있습니다: - `"channels_first"` 또는 `ChannelDimension.FIRST`: (num_channels, height, width) 형식의 이미지. - `"channels_last"` 또는 `ChannelDimension.LAST`: (height, width, num_channels) 형식의 이미지. - `"none"` 또는 `ChannelDimension.NONE`: (height, width) 형식의 이미지.
device (`Annotated[Union[str, torch.device, NoneType], None]`, *kwargs*) : 비디오를 처리할 장치입니다. 설정되지 않은 경우, 입력 비디오에서 장치를 추론합니다.
return_tensors (`Annotated[str | ~utils.generic.TensorType | None, None]`, *kwargs*) : `'pt'`로 설정된 경우 스택된 텐서를 반환하고, 그렇지 않으면 텐서 목록을 반환합니다.
disable_grouping (`bool`, *kwargs*, *선택*) : 이미지의 크기에 따른 그룹화를 비활성화하여 이미지를 배치 대신 개별적으로 처리할지 여부입니다. None인 경우, 이미지가 CPU에 있으면 True, 그렇지 않으면 False로 설정됩니다. 이 선택은 https://github.com/huggingface/transformers/pull/38157에 자세히 설명된 경험적 관찰에 기반합니다.
image_seq_length (`int`, *kwargs*, *선택*) : 입력의 각 이미지에 사용할 이미지 토큰의 수입니다. 하위 호환성을 위해 추가되었지만, 향후 모델에서는 프로세서 속성으로 설정해야 합니다.
**반환값:** `~image_processing_base.BatchFeature`
- **data** (`dict`) -- __call__ 메서드가 반환하는 리스트/배열/텐서 딕셔너리('pixel_values' 등).
- **tensor_type** (`Union[None, str, TensorType]`, *선택 사항*) -- 초기화 시 PyTorch/Numpy 텐서에서 정수 목록을 변환하려면 여기에 tensor_type을 지정할 수 있습니다.
이미지 또는 이미지 배치(batch)를 전처리합니다.
## PerceiverTextPreprocessor[[transformers.models.perceiver.modeling_perceiver.PerceiverTextPreprocessor]]
#### transformers.models.perceiver.modeling_perceiver.PerceiverTextPreprocessor[[transformers.models.perceiver.modeling_perceiver.PerceiverTextPreprocessor]]
```python
transformers.models.perceiver.modeling_perceiver.PerceiverTextPreprocessor(config: PerceiverConfig)
```
[소스](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/perceiver/modeling_perceiver.py#L2662)
**매개변수:**
config ([PerceiverConfig](/docs/transformers/v5.23.0/ko/model_doc/perceiver#transformers.PerceiverConfig)) : 모델 구성
Perceiver Encoder를 위한 텍스트 전처리. `inputs`를 임베딩하고 위치 인코딩을 추가하는 데 사용할 수 있습니다.
임베딩의 차원은 구성의 `d_model` 속성에 의해 결정됩니다.
## PerceiverImagePreprocessor[[transformers.models.perceiver.modeling_perceiver.PerceiverImagePreprocessor]]
#### transformers.models.perceiver.modeling_perceiver.PerceiverImagePreprocessor[[transformers.models.perceiver.modeling_perceiver.PerceiverImagePreprocessor]]
```python
transformers.models.perceiver.modeling_perceiver.PerceiverImagePreprocessor(config, prep_type = 'conv', spatial_downsample: int = 4, temporal_downsample: int = 1, position_encoding_type: str = 'fourier', in_channels: int = 3, out_channels: int = 64, conv_after_patching: bool = False, conv_after_patching_in_channels: int = 54, conv2d_use_batchnorm: bool = True, concat_or_add_pos: str = 'concat', project_pos_dim: int = -1, **position_encoding_kwargs)
```
[소스](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/perceiver/modeling_perceiver.py#L2825)
**매개변수:**
config ([*PerceiverConfig*]) : 모델 구성.
prep_type (`str`, *선택 사항*, 기본값 `"conv"`) : 전처리 유형. "conv1x1", "conv", "patches", "pixels" 중 하나를 사용할 수 있습니다.
spatial_downsample (`int`, *선택 사항*, 기본값 4) : 공간 다운샘플링 계수.
temporal_downsample (`int`, *선택 사항*, 기본값 1) : 시간 하위 샘플링 계수(시간 차원이 존재하는 경우에만 관련됨).
position_encoding_type (`str`, *선택 사항*, 기본값 `"fourier"`) : 위치 인코딩 유형. "fourier" 또는 "trainable"을 사용할 수 있습니다.
in_channels (`int`, *선택 사항*, 기본값 3) : 입력의 채널 수.
out_channels (`int`, *선택 사항*, 기본값 64) : 출력의 채널 수.
conv_after_patching (`bool`, *선택 사항*, 기본값 `False`) : 패칭 후 컨볼루션 레이어를 적용할지 여부.
conv_after_patching_in_channels (`int`, *선택 사항*, 기본값 54) : 패칭 후 컨볼루션 레이어 입력의 채널 수.
conv2d_use_batchnorm (`bool`, *선택 사항*, 기본값 `True`) : 컨볼루션 레이어에서 배치 정규화를 사용할지 여부.
concat_or_add_pos (`str`, *선택 사항*, 기본값 `"concat"`) : 위치 인코딩을 입력에 결합하는 방법입니다. "concat" 또는 "add"를 사용할 수 있습니다.
project_pos_dim (`int`, *선택 사항*, 기본값 -1) : 위치 인코딩을 투영할 차원입니다. -1이면 투영이 적용되지 않습니다.
- ****position_encoding_kwargs** (`Dict`, *선택 사항*) : 위치 인코딩을 위한 키워드 인자입니다.
Perceiver Encoder를 위한 이미지 전처리.
Note: *out_channels* 인자는 *prep_type*이 "conv1x1" 또는 "conv"로 설정된 경우 컨볼루션 레이어의 출력 채널을 가리킵니다. 절대 위치 임베딩을 추가하는 경우, 위치 인코딩 kwargs의 *num_channels*가 *out_channels*와 같도록 설정되어 있는지 확인해야 합니다.
## PerceiverOneHotPreprocessor[[transformers.models.perceiver.modeling_perceiver.PerceiverOneHotPreprocessor]]
#### transformers.models.perceiver.modeling_perceiver.PerceiverOneHotPreprocessor[[transformers.models.perceiver.modeling_perceiver.PerceiverOneHotPreprocessor]]
```python
transformers.models.perceiver.modeling_perceiver.PerceiverOneHotPreprocessor(config: PerceiverConfig)
```
[소스](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/perceiver/modeling_perceiver.py#L3063)
**매개변수:**
config ([PerceiverConfig](/docs/transformers/v5.23.0/ko/model_doc/perceiver#transformers.PerceiverConfig)) : 모델 구성
Perceiver Encoder용 원-핫(One-hot) 전처리기입니다. 입력에 더미 인덱스 차원을 추가하는 데 사용할 수 있습니다.
## PerceiverAudioPreprocessor[[transformers.models.perceiver.modeling_perceiver.PerceiverAudioPreprocessor]]
#### transformers.models.perceiver.modeling_perceiver.PerceiverAudioPreprocessor[[transformers.models.perceiver.modeling_perceiver.PerceiverAudioPreprocessor]]
```python
transformers.models.perceiver.modeling_perceiver.PerceiverAudioPreprocessor(config, prep_type: str = 'patches', samples_per_patch: int = 96, position_encoding_type: str = 'fourier', concat_or_add_pos: str = 'concat', out_channels = 64, project_pos_dim = -1, **position_encoding_kwargs)
```
[소스](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/perceiver/modeling_perceiver.py#L3089)
**매개변수:**
config ([*PerceiverConfig*]) : 모델 구성.
prep_type (`str`, *선택 사항*, 기본값 `"patches"`) : 사용할 Preprocessor 유형입니다. "patches"만 지원됩니다.
samples_per_patch (`int`, *선택 사항*, 기본값 96) : 패치당 샘플 수.
position_encoding_type (`str`, *선택 사항*, 기본값 `"fourier"`) : 사용할 위치 인코딩의 유형입니다. "trainable" 또는 "fourier"를 사용할 수 있습니다.
concat_or_add_pos (`str`, *선택 사항*, 기본값 `"concat"`) : 위치 인코딩을 입력에 결합하는 방법입니다. "concat" 또는 "add"를 사용할 수 있습니다.
out_channels (`int`, *선택 사항*, 기본값 64) : 출력의 채널 수.
project_pos_dim (`int`, *선택 사항*, 기본값 -1) : 위치 인코딩을 투영할 차원입니다. -1이면 투영이 적용되지 않습니다.
- ****position_encoding_kwargs** (`Dict`, *선택 사항*) : 위치 인코딩을 위한 키워드 인자입니다.
Perceiver Encoder를 위한 오디오 전처리.
## PerceiverMultimodalPreprocessor[[transformers.models.perceiver.modeling_perceiver.PerceiverMultimodalPreprocessor]]
#### transformers.models.perceiver.modeling_perceiver.PerceiverMultimodalPreprocessor[[transformers.models.perceiver.modeling_perceiver.PerceiverMultimodalPreprocessor]]
```python
transformers.models.perceiver.modeling_perceiver.PerceiverMultimodalPreprocessor(modalities: collections.abc.Mapping[str, collections.abc.Callable[..., tuple[torch.Tensor, typing.Optional[torch.Tensor], torch.Tensor]]], mask_probs: collections.abc.Mapping[str, float] | None = None, min_padding_size: int = 2)
```
[소스](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/perceiver/modeling_perceiver.py#L3192)
**매개변수:**
modalities (`Mapping[str, PreprocessorType]`) : 모달리티 이름을 프리프로세서로 매핑하는 딕셔너리.
mask_probs (`dict[str, float]`) : 모달리티 이름을 해당 모달리티의 마스킹 확률로 매핑하는 딕셔너리.
min_padding_size (`int`, *선택 사항*, 기본값 2) : 모든 모달리티에 대한 최소 패딩 크기입니다. 최종 출력의 num_channels는 모든 모달리티 중 최대 채널 수에 min_padding_size를 더한 값과 같습니다.
Perceiver Encoder를 위한 멀티모달 전처리.
각 모달리티의 입력은 전처리된 후, 학습 가능한 위치 임베딩으로 패딩되어 동일한 채널 수를 갖도록 합니다.
## PerceiverProjectionDecoder[[transformers.models.perceiver.modeling_perceiver.PerceiverProjectionDecoder]]
#### transformers.models.perceiver.modeling_perceiver.PerceiverProjectionDecoder[[transformers.models.perceiver.modeling_perceiver.PerceiverProjectionDecoder]]
```python
transformers.models.perceiver.modeling_perceiver.PerceiverProjectionDecoder(config)
```
[소스](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/perceiver/modeling_perceiver.py#L1839)
**매개변수:**
config ([PerceiverConfig](/docs/transformers/v5.23.0/ko/model_doc/perceiver#transformers.PerceiverConfig)) : 모델 구성
베이스라인 예측 디코더(크로스 어텐션 없음).
## PerceiverBasicDecoder[[transformers.models.perceiver.modeling_perceiver.PerceiverBasicDecoder]]
#### transformers.models.perceiver.modeling_perceiver.PerceiverBasicDecoder[[transformers.models.perceiver.modeling_perceiver.PerceiverBasicDecoder]]
```python
transformers.models.perceiver.modeling_perceiver.PerceiverBasicDecoder(config: PerceiverConfig, output_num_channels: int, position_encoding_type: str | None = 'trainable', output_index_dims: int | None = None, num_channels: int | None = 128, subsampled_index_dims: int | None = None, qk_channels: int | None = None, v_channels: int | None = None, num_heads: int | None = 1, widening_factor: int | None = 1, use_query_residual: bool | None = False, concat_preprocessed_input: bool | None = False, final_project: bool | None = True, position_encoding_only: bool | None = False, **position_encoding_kwargs)
```
[소스](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/perceiver/modeling_perceiver.py#L1863)
**매개변수:**
config ([*PerceiverConfig*]) : 모델 구성.
output_num_channels (`int`, *선택 사항*) : 출력의 채널 수. *final_project*가 `True`로 설정된 경우에만 사용됩니다.
position_encoding_type (`str`, *선택 사항*, 기본값 "trainable") : 사용할 위치 인코딩의 유형입니다. "trainable", "fourier", "none" 중 하나여야 합니다.
output_index_dims (`int`, *선택 사항*) : 출력 쿼리의 차원 수입니다. 'position_encoding_type' == 'none'인 경우 무시됩니다.
num_channels (`int`, *선택 사항*, 기본값 128) : 디코더 쿼리의 채널 수입니다. 'position_encoding_type' == 'none'인 경우 무시됩니다.
qk_channels (`int`, *선택 사항*) : 크로스 어텐션 레이어에서 쿼리와 키의 채널 수.
v_channels (`int`, *선택 사항*) : 크로스 어텐션 레이어의 값 채널 수.
num_heads (`int`, *선택 사항*, 기본값 1) : 크로스 어텐션 레이어의 어텐션 헤드 수입니다.
widening_factor (`int`, *선택 사항*, 기본값 1) : cross-attention 레이어의 확장 계수입니다.
use_query_residual (`bool`, *선택 사항*, 기본값 `False`) : cross-attention 레이어의 출력과 query 사이에 residual connection을 사용할지 여부.
concat_preprocessed_input (`bool`, *선택 사항*, 기본값 `False`) : 전처리된 입력을 쿼리에 연결할지 여부.
final_project (`bool`, *선택 사항*, 기본값 `True`) : cross-attention 레이어의 출력을 대상 차원으로 투영할지 여부.
position_encoding_only (`bool`, *선택 사항*, 기본값 `False`) : 이 클래스를 출력 쿼리 정의에만 사용할지 여부.
Cross-attention 기반 decoder. 이 클래스는 latents가 keys와 values를 생성하는 cross-attention 연산을 사용하여 latents의 최종 hidden states를 디코딩하는 데 사용할 수 있습니다.
이 클래스의 출력 형식은 출력 쿼리(또는 디코더 쿼리라고도 함)를 어떻게 정의하는지에 따라 달라집니다.
## PerceiverClassificationDecoder[[transformers.models.perceiver.modeling_perceiver.PerceiverClassificationDecoder]]
#### transformers.models.perceiver.modeling_perceiver.PerceiverClassificationDecoder[[transformers.models.perceiver.modeling_perceiver.PerceiverClassificationDecoder]]
```python
transformers.models.perceiver.modeling_perceiver.PerceiverClassificationDecoder(config, **decoder_kwargs)
```
[소스](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/perceiver/modeling_perceiver.py#L2048)
**매개변수:**
config ([PerceiverConfig](/docs/transformers/v5.23.0/ko/model_doc/perceiver#transformers.PerceiverConfig)) : 모델 구성
Cross-attention 기반 분류 디코더. `PerceiverBasicDecoder`의 경량 래퍼로, logit을 출력합니다. (batch_size, num_latents, d_latents) 형태의 Perceiver 인코더 출력을 (batch_size, num_labels) 형태의 텐서로 변환합니다. 쿼리는 (batch_size, 1, num_labels) 형태입니다.
## PerceiverOpticalFlowDecoder[[transformers.models.perceiver.modeling_perceiver.PerceiverOpticalFlowDecoder]]
#### transformers.models.perceiver.modeling_perceiver.PerceiverOpticalFlowDecoder[[transformers.models.perceiver.modeling_perceiver.PerceiverOpticalFlowDecoder]]
```python
transformers.models.perceiver.modeling_perceiver.PerceiverOpticalFlowDecoder(config, output_image_shape, output_num_channels = 2, rescale_factor = 100.0, **decoder_kwargs)
```
[소스](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/perceiver/modeling_perceiver.py#L2094)
Cross-attention 기반 광학 흐름 디코더.
## PerceiverBasicVideoAutoencodingDecoder[[transformers.models.perceiver.modeling_perceiver.PerceiverBasicVideoAutoencodingDecoder]]
#### transformers.models.perceiver.modeling_perceiver.PerceiverBasicVideoAutoencodingDecoder[[transformers.models.perceiver.modeling_perceiver.PerceiverBasicVideoAutoencodingDecoder]]
```python
transformers.models.perceiver.modeling_perceiver.PerceiverBasicVideoAutoencodingDecoder(config: PerceiverConfig, output_shape: list[int], position_encoding_type: str, **decoder_kwargs)
```
[소스](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/perceiver/modeling_perceiver.py#L2129)
**매개변수:**
config ([*PerceiverConfig*]) : 모델 구성.
output_shape (`list[int]`) : 채널 차원을 제외한 출력의 Shape으로 (batch_size, num_frames, height, width)입니다.
position_encoding_type (`str`) : 사용할 위치 인코딩의 유형입니다. "trainable", "fourier", "none" 중 하나여야 합니다.
Cross-attention 기반 video-autoencoding decoder입니다. video reshaping 로직을 갖춘 *PerceiverBasicDecoder*의 경량 래퍼입니다.
## PerceiverMultimodalDecoder[[transformers.models.perceiver.modeling_perceiver.PerceiverMultimodalDecoder]]
#### transformers.models.perceiver.modeling_perceiver.PerceiverMultimodalDecoder[[transformers.models.perceiver.modeling_perceiver.PerceiverMultimodalDecoder]]
```python
transformers.models.perceiver.modeling_perceiver.PerceiverMultimodalDecoder(config: PerceiverConfig, modalities: dict[str, transformers.models.perceiver.modeling_perceiver.PerceiverAbstractDecoder], num_outputs: int, output_num_channels: int, min_padding_size: int | None = 2, subsampled_index_dims: dict[str, transformers.models.perceiver.modeling_perceiver.PerceiverAbstractDecoder] | None = None, **decoder_kwargs)
```
[소스](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/perceiver/modeling_perceiver.py#L2206)
**매개변수:**
config ([*PerceiverConfig*]) : 모델 구성.
modalities (`dict[str, PerceiverAbstractDecoder]`) : 모달리티 이름을 해당 모달리티의 디코더로 매핑하는 사전.
num_outputs (`int`) : 디코더의 출력 개수.
output_num_channels (`int`) : 출력의 채널 수.
min_padding_size (`int`, *선택 사항*, 기본값 2) : 모든 모달리티에 대한 최소 패딩 크기입니다. 최종 출력의 num_channels는 모든 모달리티 중 최대 채널 수에 min_padding_size를 더한 값과 같습니다.
subsampled_index_dims (`dict[str, PerceiverAbstractDecoder]`, *선택 사항*) : 각 모달리티의 디코더 쿼리에 사용할 서브샘플링된 인덱스 차원을 모달리티 이름으로 매핑하는 사전.
유니모달 디코더를 조합하여 멀티모달 디코딩을 수행합니다. 생성자의 *modalities* 인자는 모달리티 이름을 해당 모달리티의 디코더로 매핑하는 사전입니다. 이 디코더는 해당 모달리티의 쿼리를 구성하는 데 사용됩니다. 모달리티별 쿼리는 학습 가능한 모달리티별 패딩 파라미터로 패딩된 후, 시간 차원을 따라 연결됩니다.
다음으로, 모든 모달리티에 걸쳐 공유되는 cross attention 연산이 있습니다.
## PerceiverProjectionPostprocessor[[transformers.models.perceiver.modeling_perceiver.PerceiverProjectionPostprocessor]]
#### transformers.models.perceiver.modeling_perceiver.PerceiverProjectionPostprocessor[[transformers.models.perceiver.modeling_perceiver.PerceiverProjectionPostprocessor]]
```python
transformers.models.perceiver.modeling_perceiver.PerceiverProjectionPostprocessor(in_channels: int, out_channels: int)
```
[소스](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/perceiver/modeling_perceiver.py#L2804)
**매개변수:**
in_channels (`int`) : 입력의 채널 수.
out_channels (`int`) : 출력의 채널 수.
Perceiver의 투사 후처리입니다. 디코더 출力的 채널을 더 낮은 차원으로 투사하는 데 사용할 수 있습니다.
## PerceiverAudioPostprocessor[[transformers.models.perceiver.modeling_perceiver.PerceiverAudioPostprocessor]]
#### transformers.models.perceiver.modeling_perceiver.PerceiverAudioPostprocessor[[transformers.models.perceiver.modeling_perceiver.PerceiverAudioPostprocessor]]
```python
transformers.models.perceiver.modeling_perceiver.PerceiverAudioPostprocessor(config: PerceiverConfig, in_channels: int, postproc_type: str = 'patches')
```
[소스](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/perceiver/modeling_perceiver.py#L2777)
**매개변수:**
config ([*PerceiverConfig*]) : 모델 구성.
in_channels (`int`) : 입력의 채널 수.
postproc_type (`str`, *선택 사항*, 기본값 `"patches"`) : 사용할 Postprocessor 유형입니다. 현재 "patches"만 지원됩니다.
Perceiver의 오디오 후처리. 디코더 출력을 오디오 특징으로 변환하는 데 사용할 수 있습니다.
## PerceiverClassificationPostprocessor[[transformers.models.perceiver.modeling_perceiver.PerceiverClassificationPostprocessor]]
#### transformers.models.perceiver.modeling_perceiver.PerceiverClassificationPostprocessor[[transformers.models.perceiver.modeling_perceiver.PerceiverClassificationPostprocessor]]
```python
transformers.models.perceiver.modeling_perceiver.PerceiverClassificationPostprocessor(config: PerceiverConfig, in_channels: int)
```
[소스](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/perceiver/modeling_perceiver.py#L2757)
**매개변수:**
config ([*PerceiverConfig*]) : 모델 구성.
in_channels (`int`) : 입력의 채널 수.
Perceiver의 분류 후처리. 디코더 출력을 분류 로짓으로 변환하는 데 사용할 수 있습니다.
## PerceiverMultimodalPostprocessor[[transformers.models.perceiver.modeling_perceiver.PerceiverMultimodalPostprocessor]]
#### transformers.models.perceiver.modeling_perceiver.PerceiverMultimodalPostprocessor[[transformers.models.perceiver.modeling_perceiver.PerceiverMultimodalPostprocessor]]
```python
transformers.models.perceiver.modeling_perceiver.PerceiverMultimodalPostprocessor(modalities: collections.abc.Mapping[str, collections.abc.Callable[..., typing.Any]], input_is_dict: bool = False)
```
[소스](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/perceiver/modeling_perceiver.py#L2723)
**매개변수:**
modalities (`Mapping[str, PostprocessorType]`) : 모달리티 이름을 해당 모달리티의 postprocessor 클래스로 매핑하는 딕셔너리.
input_is_dict (`bool`, *선택 사항*, 기본값 `False`) : True인 경우, 입력이 사전 구조로 가정되며 출력은 동일한 사전 형태를 유지합니다. False인 경우, 입력은 *modality_sizes*에 의해 후처리 단계에서 슬라이스되는 텐서입니다.
Perceiver용 멀티모달 후처리. 모달리티별 후처리기를 단일 후처리기로 결합하는 데 사용할 수 있습니다.
## PerceiverModel[[transformers.PerceiverModel]]
#### transformers.PerceiverModel[[transformers.PerceiverModel]]
```python
transformers.PerceiverModel(config: PerceiverConfig, decoder: typing.Optional[ForwardRef('PerceiverAbstractDecoder')] = None, input_preprocessor: collections.abc.Callable[..., tuple[torch.Tensor, typing.Optional[torch.Tensor], torch.Tensor]] = None, output_postprocessor: collections.abc.Callable[..., typing.Any] = None)
```
[소스](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/perceiver/modeling_perceiver.py#L561)
**매개변수:**
config ([PerceiverConfig](/docs/transformers/v5.23.0/ko/model_doc/perceiver#transformers.PerceiverConfig)) : 모델의 모든 매개변수를 포함하는 모델 구성 클래스입니다. 구성 파일로 초기화하는 것은 모델과 관련된 가중치를 로드하지 않으며, 구성 정보만 로드합니다. 모델 가중치를 로드하려면 [from_pretrained()](/docs/transformers/v5.23.0/ko/main_classes/model#transformers.PreTrainedModel.from_pretrained) 메서드를 확인하세요.
decoder (`PerceiverDecoder`, *선택 사항*) : 잠재 표현을 작업 예측으로 변환하는 디코더 모듈입니다.
input_preprocessor (`PreprocessorType`, *선택 사항*) : 원시 입력을 모델용 텐서로 인코딩하는 Preprocessor입니다.
output_postprocessor (`PostprocessorType`, *선택 사항*) : 모델 출력을 최종 예측으로 변환하는 Postprocessor입니다.
Perceiver: 확장 가능하고 완전한 attention 기반 아키텍처
모델의 forward에서 `interpolate_pos_encoding`을 `True`로 설정하면, 학습에 사용된 해상도보다 높은 해상도의 이미지로 Perceiver를 fine-tune할 수 있습니다. 이렇게 하면 사전 학습된 position embeddings이 더 높은 해상도에 맞게 보간됩니다.
이 모델은 [PreTrainedModel](/docs/transformers/v5.23.0/ko/main_classes/model#transformers.PreTrainedModel)에서 상속됩니다. 라이브러리가 모든 모델에 대해 구현하는 일반적 메서드(다운로드 또는 저장, 입력 임베딩 크기 조정, 헤드 프루닝 등)에 대해서는 상위 클래스 문서를 확인하세요.
이 모델은 또한 PyTorch [torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module)의 하위 클래스입니다. 일반적인 PyTorch Module처럼 사용하며, 일반적인 사용법과 동작에 관한 모든 사항은 PyTorch 문서를 참조하세요.
#### forward[[transformers.PerceiverModel.forward]]
```python
forward(inputs: Tensor, attention_mask: typing.Optional[torch.Tensor] = None, subsampled_output_points: dict[str, torch.Tensor] | None = None, output_attentions: bool | None = None, output_hidden_states: bool | None = None, interpolate_pos_encoding: bool = False, return_dict: bool | None = None, **kwargs)
```
[소스](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/perceiver/modeling_perceiver.py#L597)
**매개변수:**
inputs (`torch.Tensor`) : perceiver의 입력값입니다. 이미지, 텍스트, 오디오, 비디오 등 무엇이든 될 수 있습니다.
attention_mask (`torch.Tensor`, shape `(batch_size, sequence_length)`, *선택 사항*) : 패딩 토큰 인덱스에 대한 attention을 수행하지 않도록 방지하는 마스크입니다. `[0, 1]`에서 선택된 마스크 값: - **마스크되지 않은** 토큰은 1, - **마스크된** 토큰은 0. [attention 마스크란?](../glossary#attention-mask)
subsampled_output_points (`dict[str, torch.Tensor]`, *선택 사항*) : 디코더의 쿼리로 사용되는 텐서의 사전입니다. 디코더는 이러한 쿼리를 모델의 잠재 표현(latent representation)으로 매핑합니다. 예를 들어, 특정 이미지 패치만 디코딩하는 경우와 같이 부분 샘플링된(subsampled) 디코딩에 사용됩니다.
output_attentions (`bool`, *선택 사항*) : 모든 어텐션 레이어의 어텐션 텐서를 반환할지 여부. 자세한 내용은 반환 텐서 섹션의 `attentions`를 참조하세요.
output_hidden_states (`bool`, *선택 사항*) : 모든 레이어의 hidden states를 반환할지 여부. 자세한 내용은 반환되는 텐서 중 `hidden_states` 항목을 참조하세요.
interpolate_pos_encoding (`bool`, *선택 사항*, 기본값 `False`) : 사전 학습된 위치 인코딩을 보간할지 여부.
return_dict (`bool`, *선택 사항*) : 일반 튜플 대신 [ModelOutput](/docs/transformers/v5.23.0/ko/main_classes/output#transformers.utils.ModelOutput)를 반환할지 여부.
**반환값:** [PerceiverModelOutput](/docs/transformers/v5.23.0/ko/model_doc/perceiver#transformers.models.perceiver.modeling_perceiver.PerceiverModelOutput) 또는 `tuple(torch.Tensor)`
구성([PerceiverConfig](/docs/transformers/v5.23.0/ko/model_doc/perceiver#transformers.PerceiverConfig))과 입력에 따라 다양한 요소를 포함하는 [PerceiverModelOutput](/docs/transformers/v5.23.0/ko/model_doc/perceiver#transformers.models.perceiver.modeling_perceiver.PerceiverModelOutput) 또는 `torch.Tensor`의 튜플(`return_dict=False`가 전달되거나 `config.return_dict=False`인 경우).
[PerceiverModel](/docs/transformers/v5.23.0/ko/model_doc/perceiver#transformers.PerceiverModel)의 forward 메서드는 `__call__` 특수 메서드를 오버라이드합니다.
`Module` 인스턴스는 전처리 및 후처리 단계를 실행하는 것을 처리하지만, 이 함수는 해당 단계를 조용히 무시하므로, 순전파(forward pass) 레시피를 이 함수 내에서 정의해야 하더라도 이후에는 이 함수 대신 `Module` 인스턴스를 호출해야 합니다.
- **logits** (`torch.Tensor`, shape `(batch_size, num_labels)`) -- SoftMax 적용 전 분류(또는 config.num_labels==1인 경우 회귀) 점수.
- **last_hidden_state** (`torch.Tensor`, shape `(batch_size, sequence_length, hidden_size)`, *선택 사항*) -- 모델의 마지막 레이어 출력에서 생성된 hidden-state 시퀀스입니다.
- **hidden_states** (`tuple[torch.Tensor]`, *선택*, `output_hidden_states=True`가 전달되었거나 `config.output_hidden_states=True`인 경우 반환됨) -- `torch.Tensor`의 튜플(모델에 임베딩 레이어가 있는 경우 임베딩 출력용 1개 + 각 레이어의 출력용 1개)로, 모양은 `(batch_size, sequence_length, hidden_size)`입니다.
각 레이어의 출력에서 모델의 Hidden-states와 선택적 초기 임베딩 출력을 포함합니다.
- **attentions** (`tuple[torch.Tensor]`, *선택*, `output_attentions=True`가 전달되었거나 `config.output_attentions=True`인 경우 반환됨) -- 각 레이어마다 하나씩 포함된 `torch.Tensor`의 튜플로, 모양은 `(batch_size, num_heads, sequence_length, sequence_length)`입니다.
self-attention 헤드에서 가중 평균을 계산하는 데 사용되는 attention softmax 이후의 attention 가중치입니다.
- **cross_attentions** (`tuple[torch.Tensor]`, *선택*, `output_attentions=True`가 전달되거나 `config.output_attentions=True`일 때 반환) -- 각 레이어마다 하나씩 포함된 `torch.Tensor`의 튜플로, shape는 `(batch_size, num_heads, sequence_length, sequence_length)`입니다.
decoder의 cross-attention 레이어에서 attention softmax를 적용한 후, cross-attention 헤드에서 가중 평균을 계산하는 데 사용되는 attention 가중치입니다.
예:
```python
>>> from transformers import PerceiverConfig, PerceiverTokenizer, PerceiverImageProcessor, PerceiverModel
>>> from transformers.models.perceiver.modeling_perceiver import (
... PerceiverTextPreprocessor,
... PerceiverImagePreprocessor,
... PerceiverClassificationDecoder,
... )
>>> import torch
>>> from huggingface_hub.utils import httpx
>>> from io import BytesIO
>>> from PIL import Image
>>> # EXAMPLE 1: using the Perceiver to classify texts
>>> # - we define a TextPreprocessor, which can be used to embed tokens
>>> # - we define a ClassificationDecoder, which can be used to decode the
>>> # final hidden states of the latents to classification logits
>>> # using trainable position embeddings
>>> config = PerceiverConfig()
>>> preprocessor = PerceiverTextPreprocessor(config)
>>> decoder = PerceiverClassificationDecoder(
... config,
... num_channels=config.d_latents,
... trainable_position_encoding_kwargs=dict(num_channels=config.d_latents, index_dims=1),
... use_query_residual=True,
... )
>>> model = PerceiverModel(config, input_preprocessor=preprocessor, decoder=decoder)
>>> # you can then do a forward pass as follows:
>>> tokenizer = PerceiverTokenizer()
>>> text = "hello world"
>>> inputs = tokenizer(text, return_tensors="pt").input_ids
>>> with torch.no_grad():
... outputs = model(inputs=inputs)
>>> logits = outputs.logits
>>> list(logits.shape)
[1, 2]
>>> # to train, one can train the model using standard cross-entropy:
>>> criterion = torch.nn.CrossEntropyLoss()
>>> labels = torch.tensor([1])
>>> loss = criterion(logits, labels)
>>> # EXAMPLE 2: using the Perceiver to classify images
>>> # - we define an ImagePreprocessor, which can be used to embed images
>>> config = PerceiverConfig(image_size=224)
>>> preprocessor = PerceiverImagePreprocessor(
... config,
... prep_type="conv1x1",
... spatial_downsample=1,
... out_channels=256,
... position_encoding_type="trainable",
... concat_or_add_pos="concat",
... project_pos_dim=256,
... trainable_position_encoding_kwargs=dict(
... num_channels=256,
... index_dims=config.image_size**2,
... ),
... )
>>> model = PerceiverModel(
... config,
... input_preprocessor=preprocessor,
... decoder=PerceiverClassificationDecoder(
... config,
... num_channels=config.d_latents,
... trainable_position_encoding_kwargs=dict(num_channels=config.d_latents, index_dims=1),
... use_query_residual=True,
... ),
... )
>>> # you can then do a forward pass as follows:
>>> image_processor = PerceiverImageProcessor()
>>> url = "http://images.cocodataset.org/val2017/000000039769.jpg"
>>> with httpx.stream("GET", url) as response:
... image = Image.open(BytesIO(response.read()))
>>> inputs = image_processor(image, return_tensors="pt").pixel_values
>>> with torch.no_grad():
... outputs = model(inputs=inputs)
>>> logits = outputs.logits
>>> list(logits.shape)
[1, 2]
>>> # to train, one can train the model using standard cross-entropy:
>>> criterion = torch.nn.CrossEntropyLoss()
>>> labels = torch.tensor([1])
>>> loss = criterion(logits, labels)
```
## PerceiverForMaskedLM[[transformers.PerceiverForMaskedLM]]
#### transformers.PerceiverForMaskedLM[[transformers.PerceiverForMaskedLM]]
```python
transformers.PerceiverForMaskedLM(config: PerceiverConfig)
```
[소스](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/perceiver/modeling_perceiver.py#L807)
**매개변수:**
config ([PerceiverConfig](/docs/transformers/v5.23.0/ko/model_doc/perceiver#transformers.PerceiverConfig)) : 모델의 모든 매개변수를 포함하는 모델 구성 클래스입니다. 구성 파일로 초기화하는 것은 모델과 관련된 가중치를 로드하지 않으며, 구성 정보만 로드합니다. 모델 가중치를 로드하려면 [from_pretrained()](/docs/transformers/v5.23.0/ko/main_classes/model#transformers.PreTrainedModel.from_pretrained) 메서드를 확인하세요.
Perceiver를 masked language modeling에 사용하는 예시.
이 모델은 [PreTrainedModel](/docs/transformers/v5.23.0/ko/main_classes/model#transformers.PreTrainedModel)에서 상속됩니다. 라이브러리가 모든 모델에 대해 구현하는 일반적 메서드(다운로드 또는 저장, 입력 임베딩 크기 조정, 헤드 프루닝 등)에 대해서는 상위 클래스 문서를 확인하세요.
이 모델은 또한 PyTorch [torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module)의 하위 클래스입니다. 일반적인 PyTorch Module처럼 사용하며, 일반적인 사용법과 동작에 관한 모든 사항은 PyTorch 문서를 참조하세요.
#### forward[[transformers.PerceiverForMaskedLM.forward]]
```python
forward(inputs: typing.Optional[torch.Tensor] = None, attention_mask: typing.Optional[torch.Tensor] = None, output_attentions: bool | None = None, output_hidden_states: bool | None = None, labels: typing.Optional[torch.Tensor] = None, return_dict: bool | None = None, input_ids: typing.Optional[torch.Tensor] = None, **kwargs)
```
[소스](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/perceiver/modeling_perceiver.py#L839)
**매개변수:**
inputs (`torch.Tensor`, *선택 사항*) : perceiver의 입력입니다. 이미지, 텍스트, 오디오, 비디오 등 무엇이든 될 수 있습니다.
attention_mask (`torch.Tensor`, shape `(batch_size, sequence_length)`, *선택 사항*) : 패딩 토큰 인덱스에 대한 attention을 수행하지 않도록 방지하는 마스크입니다. `[0, 1]`에서 선택된 마스크 값: - **마스크되지 않은** 토큰은 1, - **마스크된** 토큰은 0. [attention 마스크란?](../glossary#attention-mask)
output_attentions (`bool`, *선택 사항*) : 모든 어텐션 레이어의 어텐션 텐서를 반환할지 여부. 자세한 내용은 반환 텐서 섹션의 `attentions`를 참조하세요.
output_hidden_states (`bool`, *선택 사항*) : 모든 레이어의 hidden states를 반환할지 여부. 자세한 내용은 반환되는 텐서 중 `hidden_states` 항목을 참조하세요.
labels (`torch.LongTensor`, shape `(batch_size, sequence_length)`, *선택 사항*) : masked language modeling loss를 계산하기 위한 라벨. 인덱스는 `[-100, 0, ..., config.vocab_size]` 범위여야 합니다(`input_ids` docstring 참조). 인덱스가 `-100`로 설정된 토큰은 무시(마스크)되며, loss는 `[0, ..., config.vocab_size]` 범위의 라벨을 가진 토큰에 대해서만 계산됩니다.
return_dict (`bool`, *선택 사항*) : 일반 튜플 대신 [ModelOutput](/docs/transformers/v5.23.0/ko/main_classes/output#transformers.utils.ModelOutput)를 반환할지 여부.
input_ids (`torch.Tensor`, shape `(batch_size, sequence_length)`, *선택 사항*) : 어휘(input sequence tokens)의 인덱스입니다. 기본적으로 패딩은 무시됩니다. [AutoTokenizer](/docs/transformers/v5.23.0/ko/model_doc/auto#transformers.AutoTokenizer)를 사용하여 인덱스를 얻을 수 있습니다. 자세한 내용은 [PreTrainedTokenizer.encode()](/docs/transformers/v5.23.0/ko/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.encode) 및 [PreTrainedTokenizer.__call__()](/docs/transformers/v5.23.0/ko/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.__call__)를 참조하세요. [입력 ID란 무엇인가요?](../glossary#input-ids)
**반환값:** [PerceiverMaskedLMOutput](/docs/transformers/v5.23.0/ko/model_doc/perceiver#transformers.models.perceiver.modeling_perceiver.PerceiverMaskedLMOutput) 또는 `tuple(torch.Tensor)`
구성([PerceiverConfig](/docs/transformers/v5.23.0/ko/model_doc/perceiver#transformers.PerceiverConfig))과 입력에 따라 다양한 요소를 포함하는 [PerceiverMaskedLMOutput](/docs/transformers/v5.23.0/ko/model_doc/perceiver#transformers.models.perceiver.modeling_perceiver.PerceiverMaskedLMOutput) 또는 `torch.Tensor`의 튜플(`return_dict=False`가 전달되거나 `config.return_dict=False`인 경우).
[PerceiverForMaskedLM](/docs/transformers/v5.23.0/ko/model_doc/perceiver#transformers.PerceiverForMaskedLM)의 forward 메서드는 `__call__` 특수 메서드를 오버라이드합니다.
`Module` 인스턴스는 전처리 및 후처리 단계를 실행하는 것을 처리하지만, 이 함수는 해당 단계를 조용히 무시하므로, 순전파(forward pass) 레시피를 이 함수 내에서 정의해야 하더라도 이후에는 이 함수 대신 `Module` 인스턴스를 호출해야 합니다.
- **loss** (`torch.Tensor`, shape `(1,)`, *선택*, `labels`이 제공될 때 반환됨) -- Masked language modeling(MLM) loss.
- **logits** (`torch.Tensor`, shape `(batch_size, sequence_length, config.vocab_size)`) -- 언어 모델링 헤드에서 생성된 예측 점수(SoftMax 적용 전 각 어휘 토큰에 대한 점수).
- **hidden_states** (`tuple[torch.Tensor]`, *선택*, `output_hidden_states=True`가 전달되었거나 `config.output_hidden_states=True`인 경우 반환됨) -- `torch.Tensor`의 튜플(모델에 임베딩 레이어가 있는 경우 임베딩 출력용 1개 + 각 레이어의 출력용 1개)로, 모양은 `(batch_size, sequence_length, hidden_size)`입니다.
각 레이어의 출력에서 모델의 Hidden-states와 선택적 초기 임베딩 출력을 포함합니다.
- **attentions** (`tuple[torch.Tensor]`, *선택*, `output_attentions=True`가 전달되었거나 `config.output_attentions=True`인 경우 반환됨) -- 각 레이어마다 하나씩 포함된 `torch.Tensor`의 튜플로, 모양은 `(batch_size, num_heads, sequence_length, sequence_length)`입니다.
self-attention 헤드에서 가중 평균을 계산하는 데 사용되는 attention softmax 이후의 attention 가중치입니다.
- **cross_attentions** (`tuple[torch.Tensor]`, *선택*, `output_attentions=True`가 전달되거나 `config.output_attentions=True`일 때 반환) -- 각 레이어마다 하나씩 포함된 `torch.Tensor`의 튜플로, shape는 `(batch_size, num_heads, sequence_length, sequence_length)`입니다.
decoder의 cross-attention 레이어에서 attention softmax를 적용한 후, cross-attention 헤드에서 가중 평균을 계산하는 데 사용되는 attention 가중치입니다.
예:
```python
>>> from transformers import AutoTokenizer, PerceiverForMaskedLM
>>> import torch
>>> tokenizer = AutoTokenizer.from_pretrained("deepmind/language-perceiver")
>>> model = PerceiverForMaskedLM.from_pretrained("deepmind/language-perceiver")
>>> # training
>>> text = "This is an incomplete sentence where some words are missing."
>>> inputs = tokenizer(text, padding="max_length", return_tensors="pt")
>>> # mask " missing."
>>> inputs["input_ids"][0, 52:61] = tokenizer.mask_token_id
>>> labels = tokenizer(text, padding="max_length", return_tensors="pt").input_ids
>>> outputs = model(**inputs, labels=labels)
>>> loss = outputs.loss
>>> round(loss.item(), 2)
19.87
>>> logits = outputs.logits
>>> list(logits.shape)
[1, 2048, 262]
>>> # inference
>>> text = "This is an incomplete sentence where some words are missing."
>>> encoding = tokenizer(text, padding="max_length", return_tensors="pt")
>>> # mask bytes corresponding to " missing.". Note that the model performs much better if the masked span starts with a space.
>>> encoding["input_ids"][0, 52:61] = tokenizer.mask_token_id
>>> # forward pass
>>> with torch.no_grad():
... outputs = model(**encoding)
>>> logits = outputs.logits
>>> list(logits.shape)
[1, 2048, 262]
>>> masked_tokens_predictions = logits[0, 52:61].argmax(dim=-1).tolist()
>>> tokenizer.decode(masked_tokens_predictions)
' missing.'
```
## PerceiverForSequenceClassification[[transformers.PerceiverForSequenceClassification]]
#### transformers.PerceiverForSequenceClassification[[transformers.PerceiverForSequenceClassification]]
```python
transformers.PerceiverForSequenceClassification(config: PerceiverConfig)
```
[소스](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/perceiver/modeling_perceiver.py#L940)
**매개변수:**
config ([PerceiverConfig](/docs/transformers/v5.23.0/ko/model_doc/perceiver#transformers.PerceiverConfig)) : 모델의 모든 매개변수를 포함하는 모델 구성 클래스입니다. 구성 파일로 초기화하는 것은 모델과 관련된 가중치를 로드하지 않으며, 구성 정보만 로드합니다. 모델 가중치를 로드하려면 [from_pretrained()](/docs/transformers/v5.23.0/ko/main_classes/model#transformers.PreTrainedModel.from_pretrained) 메서드를 확인하세요.
Perceiver를 텍스트 분류에 사용하는 예시.
이 모델은 [PreTrainedModel](/docs/transformers/v5.23.0/ko/main_classes/model#transformers.PreTrainedModel)에서 상속됩니다. 라이브러리가 모든 모델에 대해 구현하는 일반적 메서드(다운로드 또는 저장, 입력 임베딩 크기 조정, 헤드 프루닝 등)에 대해서는 상위 클래스 문서를 확인하세요.
이 모델은 또한 PyTorch [torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module)의 하위 클래스입니다. 일반적인 PyTorch Module처럼 사용하며, 일반적인 사용법과 동작에 관한 모든 사항은 PyTorch 문서를 참조하세요.
#### forward[[transformers.PerceiverForSequenceClassification.forward]]
```python
forward(inputs: typing.Optional[torch.Tensor] = None, attention_mask: typing.Optional[torch.Tensor] = None, output_attentions: bool | None = None, output_hidden_states: bool | None = None, labels: typing.Optional[torch.Tensor] = None, return_dict: bool | None = None, input_ids: typing.Optional[torch.Tensor] = None, **kwargs)
```
[소스](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/perceiver/modeling_perceiver.py#L961)
**매개변수:**
inputs (`torch.Tensor`, *선택 사항*) : perceiver의 입력입니다. 이미지, 텍스트, 오디오, 비디오 등 무엇이든 될 수 있습니다.
attention_mask (`torch.Tensor`, shape `(batch_size, sequence_length)`, *선택 사항*) : 패딩 토큰 인덱스에 대한 attention을 수행하지 않도록 방지하는 마스크입니다. `[0, 1]`에서 선택된 마스크 값: - **마스크되지 않은** 토큰은 1, - **마스크된** 토큰은 0. [attention 마스크란?](../glossary#attention-mask)
output_attentions (`bool`, *선택 사항*) : 모든 어텐션 레이어의 어텐션 텐서를 반환할지 여부. 자세한 내용은 반환 텐서 섹션의 `attentions`를 참조하세요.
output_hidden_states (`bool`, *선택 사항*) : 모든 레이어의 hidden states를 반환할지 여부. 자세한 내용은 반환되는 텐서 중 `hidden_states` 항목을 참조하세요.
labels (`torch.LongTensor`, shape `(batch_size,)`, *선택 사항*) : 분류/회귀 손실을 계산하는 데 사용되는 라벨. 인덱스는 `[0, ..., config.num_labels - 1]` 범위에 있어야 합니다. `config.num_labels == 1`인 경우 회귀 손실(평균 제곱 손실)이 계산되고, `config.num_labels > 1`인 경우 분류 손실(크로스 엔트로피)이 계산됩니다.
return_dict (`bool`, *선택 사항*) : 일반 튜플 대신 [ModelOutput](/docs/transformers/v5.23.0/ko/main_classes/output#transformers.utils.ModelOutput)를 반환할지 여부.
input_ids (`torch.Tensor`, shape `(batch_size, sequence_length)`, *선택 사항*) : 어휘(input sequence tokens)의 인덱스입니다. 기본적으로 패딩은 무시됩니다. [AutoTokenizer](/docs/transformers/v5.23.0/ko/model_doc/auto#transformers.AutoTokenizer)를 사용하여 인덱스를 얻을 수 있습니다. 자세한 내용은 [PreTrainedTokenizer.encode()](/docs/transformers/v5.23.0/ko/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.encode) 및 [PreTrainedTokenizer.__call__()](/docs/transformers/v5.23.0/ko/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.__call__)를 참조하세요. [입력 ID란 무엇인가요?](../glossary#input-ids)
**반환값:** [PerceiverClassifierOutput](/docs/transformers/v5.23.0/ko/model_doc/perceiver#transformers.models.perceiver.modeling_perceiver.PerceiverClassifierOutput) 또는 `tuple(torch.Tensor)`
구성([PerceiverConfig](/docs/transformers/v5.23.0/ko/model_doc/perceiver#transformers.PerceiverConfig))과 입력에 따라 다양한 요소를 포함하는 [PerceiverClassifierOutput](/docs/transformers/v5.23.0/ko/model_doc/perceiver#transformers.models.perceiver.modeling_perceiver.PerceiverClassifierOutput) 또는 `torch.Tensor`의 튜플(`return_dict=False`가 전달되거나 `config.return_dict=False`인 경우).
[PerceiverForSequenceClassification](/docs/transformers/v5.23.0/ko/model_doc/perceiver#transformers.PerceiverForSequenceClassification)의 forward 메서드는 `__call__` 특수 메서드를 오버라이드합니다.
`Module` 인스턴스는 전처리 및 후처리 단계를 실행하는 것을 처리하지만, 이 함수는 해당 단계를 조용히 무시하므로, 순전파(forward pass) 레시피를 이 함수 내에서 정의해야 하더라도 이후에는 이 함수 대신 `Module` 인스턴스를 호출해야 합니다.
- **loss** (`torch.Tensor`, shape `(1,)`, *선택*, `labels`이 제공될 때 반환됨) -- 분류(또는 config.num_labels==1인 경우 회귀) 손실.
- **logits** (`torch.Tensor`, shape `(batch_size, config.num_labels)`) -- SoftMax 적용 전 분류(또는 config.num_labels==1인 경우 회귀) 점수.
- **hidden_states** (`tuple[torch.Tensor]`, *선택*, `output_hidden_states=True`가 전달되었거나 `config.output_hidden_states=True`인 경우 반환됨) -- `torch.Tensor`의 튜플(모델에 임베딩 레이어가 있는 경우 임베딩 출력용 1개 + 각 레이어의 출력용 1개)로, 모양은 `(batch_size, sequence_length, hidden_size)`입니다.
각 레이어의 출력에서 모델의 Hidden-states와 선택적 초기 임베딩 출력을 포함합니다.
- **attentions** (`tuple[torch.Tensor]`, *선택*, `output_attentions=True`가 전달되었거나 `config.output_attentions=True`인 경우 반환됨) -- 각 레이어마다 하나씩 포함된 `torch.Tensor`의 튜플로, 모양은 `(batch_size, num_heads, sequence_length, sequence_length)`입니다.
self-attention 헤드에서 가중 평균을 계산하는 데 사용되는 attention softmax 이후의 attention 가중치입니다.
- **cross_attentions** (`tuple[torch.Tensor]`, *선택*, `output_attentions=True`가 전달되거나 `config.output_attentions=True`일 때 반환) -- 각 레이어마다 하나씩 포함된 `torch.Tensor`의 튜플로, shape는 `(batch_size, num_heads, sequence_length, sequence_length)`입니다.
decoder의 cross-attention 레이어에서 attention softmax를 적용한 후, cross-attention 헤드에서 가중 평균을 계산하는 데 사용되는 attention 가중치입니다.
예:
```python
>>> from transformers import AutoTokenizer, PerceiverForSequenceClassification
>>> tokenizer = AutoTokenizer.from_pretrained("deepmind/language-perceiver")
>>> model = PerceiverForSequenceClassification.from_pretrained("deepmind/language-perceiver")
>>> text = "hello world"
>>> inputs = tokenizer(text, return_tensors="pt").input_ids
>>> outputs = model(inputs=inputs)
>>> logits = outputs.logits
>>> list(logits.shape)
[1, 2]
```
## PerceiverForImageClassificationLearned[[transformers.PerceiverForImageClassificationLearned]]
#### transformers.PerceiverForImageClassificationLearned[[transformers.PerceiverForImageClassificationLearned]]
```python
transformers.PerceiverForImageClassificationLearned(config: PerceiverConfig)
```
[소스](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/perceiver/modeling_perceiver.py#L1062)
**매개변수:**
config ([PerceiverConfig](/docs/transformers/v5.23.0/ko/model_doc/perceiver#transformers.PerceiverConfig)) : 모델의 모든 매개변수를 포함하는 모델 구성 클래스입니다. 구성 파일로 초기화하는 것은 모델과 관련된 가중치를 로드하지 않으며, 구성 정보만 로드합니다. 모델 가중치를 로드하려면 [from_pretrained()](/docs/transformers/v5.23.0/ko/main_classes/model#transformers.PreTrainedModel.from_pretrained) 메서드를 확인하세요.
ImageNet과 같은 작업에 Perceiver를 이미지 분류용으로 사용하는 예시입니다.
이 모델은 학습된 위치 임베딩을 사용합니다. 즉, 이 모델에는 이미지의 구조에 대한 특권 정보가 제공되지 않습니다. 논문에서 보여주었듯이, 이 모델은 ImageNet에서 top-1 정확도 72.7를 달성할 수 있습니다.
[PerceiverForImageClassificationLearned](/docs/transformers/v5.23.0/ko/model_doc/perceiver#transformers.PerceiverForImageClassificationLearned)는 입력 이미지를 전처리하기 위해 [PerceiverImagePreprocessor](/docs/transformers/v5.23.0/ko/model_doc/perceiver#transformers.models.perceiver.modeling_perceiver.PerceiverImagePreprocessor)(`prep_type="conv1x1"` 사용)를, 그리고 [PerceiverModel](/docs/transformers/v5.23.0/ko/model_doc/perceiver#transformers.PerceiverModel)의 잠재 표현을 분류 로짓으로 디코딩하기 위해 [PerceiverClassificationDecoder](/docs/transformers/v5.23.0/ko/model_doc/perceiver#transformers.models.perceiver.modeling_perceiver.PerceiverClassificationDecoder)를 사용합니다.
이 모델은 [PreTrainedModel](/docs/transformers/v5.23.0/ko/main_classes/model#transformers.PreTrainedModel)에서 상속됩니다. 라이브러리가 모든 모델에 대해 구현하는 일반적 메서드(다운로드 또는 저장, 입력 임베딩 크기 조정, 헤드 프루닝 등)에 대해서는 상위 클래스 문서를 확인하세요.
이 모델은 또한 PyTorch [torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module)의 하위 클래스입니다. 일반적인 PyTorch Module처럼 사용하며, 일반적인 사용법과 동작에 관한 모든 사항은 PyTorch 문서를 참조하세요.
#### forward[[transformers.PerceiverForImageClassificationLearned.forward]]
```python
forward(inputs: typing.Optional[torch.Tensor] = None, attention_mask: typing.Optional[torch.Tensor] = None, output_attentions: bool | None = None, output_hidden_states: bool | None = None, labels: typing.Optional[torch.Tensor] = None, interpolate_pos_encoding: bool = False, return_dict: bool | None = None, pixel_values: typing.Optional[torch.Tensor] = None, **kwargs)
```
[소스](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/perceiver/modeling_perceiver.py#L1093)
**매개변수:**
inputs (`torch.Tensor`, *선택 사항*) : perceiver의 입력입니다. 이미지, 텍스트, 오디오, 비디오 등 무엇이든 될 수 있습니다.
attention_mask (`torch.Tensor`, shape `(batch_size, sequence_length)`, *선택 사항*) : 패딩 토큰 인덱스에 대한 attention을 수행하지 않도록 방지하는 마스크입니다. `[0, 1]`에서 선택된 마스크 값: - **마스크되지 않은** 토큰은 1, - **마스크된** 토큰은 0. [attention 마스크란?](../glossary#attention-mask)
output_attentions (`bool`, *선택 사항*) : 모든 어텐션 레이어의 어텐션 텐서를 반환할지 여부. 자세한 내용은 반환 텐서 섹션의 `attentions`를 참조하세요.
output_hidden_states (`bool`, *선택 사항*) : 모든 레이어의 hidden states를 반환할지 여부. 자세한 내용은 반환되는 텐서 중 `hidden_states` 항목을 참조하세요.
labels (`torch.LongTensor`, shape `(batch_size,)`, *선택 사항*) : 이미지 분류/회귀 손실을 계산하는 데 사용되는 라벨. 인덱스는 `[0, ..., config.num_labels - 1]` 범위에 있어야 합니다. `config.num_labels == 1`인 경우 회귀 손실(평균 제곱 손실)이 계산되고, `config.num_labels > 1`인 경우 분류 손실(크로스 엔트로피)이 계산됩니다.
interpolate_pos_encoding (`bool`, *선택 사항*, 기본값 `False`) : 사전 학습된 위치 인코딩을 보간할지 여부.
return_dict (`bool`, *선택 사항*) : 일반 튜플 대신 [ModelOutput](/docs/transformers/v5.23.0/ko/main_classes/output#transformers.utils.ModelOutput)를 반환할지 여부.
pixel_values (`torch.Tensor`, shape `(batch_size, num_channels, image_size, image_size)`, *선택 사항*) : 입력 이미지에 해당하는 텐서입니다. 픽셀 값은 [PerceiverImageProcessor](/docs/transformers/v5.23.0/ko/model_doc/perceiver#transformers.PerceiverImageProcessor)를 사용하여 얻을 수 있습니다. 자세한 내용은 [PerceiverImageProcessor.__call__()](/docs/transformers/v5.23.0/ko/model_doc/molmo2#transformers.Molmo2ImageProcessor.__call__)를 참조하세요 (`processor_class`는 이미지 처리에 [PerceiverImageProcessor](/docs/transformers/v5.23.0/ko/model_doc/perceiver#transformers.PerceiverImageProcessor)를 사용합니다).
**반환값:** [PerceiverClassifierOutput](/docs/transformers/v5.23.0/ko/model_doc/perceiver#transformers.models.perceiver.modeling_perceiver.PerceiverClassifierOutput) 또는 `tuple(torch.Tensor)`
구성([PerceiverConfig](/docs/transformers/v5.23.0/ko/model_doc/perceiver#transformers.PerceiverConfig))과 입력에 따라 다양한 요소를 포함하는 [PerceiverClassifierOutput](/docs/transformers/v5.23.0/ko/model_doc/perceiver#transformers.models.perceiver.modeling_perceiver.PerceiverClassifierOutput) 또는 `torch.Tensor`의 튜플(`return_dict=False`가 전달되거나 `config.return_dict=False`인 경우).
[PerceiverForImageClassificationLearned](/docs/transformers/v5.23.0/ko/model_doc/perceiver#transformers.PerceiverForImageClassificationLearned)의 forward 메서드는 `__call__` 특수 메서드를 오버라이드합니다.
`Module` 인스턴스는 전처리 및 후처리 단계를 실행하는 것을 처리하지만, 이 함수는 해당 단계를 조용히 무시하므로, 순전파(forward pass) 레시피를 이 함수 내에서 정의해야 하더라도 이후에는 이 함수 대신 `Module` 인스턴스를 호출해야 합니다.
- **loss** (`torch.Tensor`, shape `(1,)`, *선택*, `labels`이 제공될 때 반환됨) -- 분류(또는 config.num_labels==1인 경우 회귀) 손실.
- **logits** (`torch.Tensor`, shape `(batch_size, config.num_labels)`) -- SoftMax 적용 전 분류(또는 config.num_labels==1인 경우 회귀) 점수.
- **hidden_states** (`tuple[torch.Tensor]`, *선택*, `output_hidden_states=True`가 전달되었거나 `config.output_hidden_states=True`인 경우 반환됨) -- `torch.Tensor`의 튜플(모델에 임베딩 레이어가 있는 경우 임베딩 출력용 1개 + 각 레이어의 출력용 1개)로, 모양은 `(batch_size, sequence_length, hidden_size)`입니다.
각 레이어의 출력에서 모델의 Hidden-states와 선택적 초기 임베딩 출력을 포함합니다.
- **attentions** (`tuple[torch.Tensor]`, *선택*, `output_attentions=True`가 전달되었거나 `config.output_attentions=True`인 경우 반환됨) -- 각 레이어마다 하나씩 포함된 `torch.Tensor`의 튜플로, 모양은 `(batch_size, num_heads, sequence_length, sequence_length)`입니다.
self-attention 헤드에서 가중 평균을 계산하는 데 사용되는 attention softmax 이후의 attention 가중치입니다.
- **cross_attentions** (`tuple[torch.Tensor]`, *선택*, `output_attentions=True`가 전달되거나 `config.output_attentions=True`일 때 반환) -- 각 레이어마다 하나씩 포함된 `torch.Tensor`의 튜플로, shape는 `(batch_size, num_heads, sequence_length, sequence_length)`입니다.
decoder의 cross-attention 레이어에서 attention softmax를 적용한 후, cross-attention 헤드에서 가중 평균을 계산하는 데 사용되는 attention 가중치입니다.
예:
```python
>>> from transformers import AutoImageProcessor, PerceiverForImageClassificationLearned
>>> from PIL import Image
>>> from huggingface_hub.utils import httpx
>>> from io import BytesIO
>>> url = "http://images.cocodataset.org/val2017/000000039769.jpg"
>>> with httpx.stream("GET", url) as response:
... image = Image.open(BytesIO(response.read()))
>>> image_processor = AutoImageProcessor.from_pretrained("deepmind/vision-perceiver-learned")
>>> model = PerceiverForImageClassificationLearned.from_pretrained("deepmind/vision-perceiver-learned")
>>> inputs = image_processor(images=image, return_tensors="pt").pixel_values
>>> outputs = model(inputs=inputs)
>>> logits = outputs.logits
>>> list(logits.shape)
[1, 1000]
>>> # model predicts one of the 1000 ImageNet classes
>>> predicted_class_idx = logits.argmax(-1).item()
>>> print("Predicted class:", model.config.id2label[predicted_class_idx])
Predicted class: tabby, tabby cat
```
## PerceiverForImageClassificationFourier[[transformers.PerceiverForImageClassificationFourier]]
#### transformers.PerceiverForImageClassificationFourier[[transformers.PerceiverForImageClassificationFourier]]
```python
transformers.PerceiverForImageClassificationFourier(config: PerceiverConfig)
```
[소스](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/perceiver/modeling_perceiver.py#L1187)
**매개변수:**
config ([PerceiverConfig](/docs/transformers/v5.23.0/ko/model_doc/perceiver#transformers.PerceiverConfig)) : 모델의 모든 매개변수를 포함하는 모델 구성 클래스입니다. 구성 파일로 초기화하는 것은 모델과 관련된 가중치를 로드하지 않으며, 구성 정보만 로드합니다. 모델 가중치를 로드하려면 [from_pretrained()](/docs/transformers/v5.23.0/ko/main_classes/model#transformers.PreTrainedModel.from_pretrained) 메서드를 확인하세요.
ImageNet과 같은 작업에 Perceiver를 이미지 분류용으로 사용하는 예시입니다.
이 모델은 고정된 2D Fourier 위치 임베딩을 사용합니다. 논문에서 보여주었듯이, 이 모델은 ImageNet에서 top-1 정확도 79.0을 달성하며, 대규모 데이터셋(예: JFT)으로 사전 학습하면 84.5를 달성합니다.
[PerceiverForImageClassificationLearned](/docs/transformers/v5.23.0/ko/model_doc/perceiver#transformers.PerceiverForImageClassificationLearned)는 입력 이미지를 전처리하기 위해 [PerceiverImagePreprocessor](/docs/transformers/v5.23.0/ko/model_doc/perceiver#transformers.models.perceiver.modeling_perceiver.PerceiverImagePreprocessor)(`prep_type="pixels"` 사용)를, 그리고 [PerceiverModel](/docs/transformers/v5.23.0/ko/model_doc/perceiver#transformers.PerceiverModel)의 잠재 표현을 분류 로짓으로 디코딩하기 위해 [PerceiverClassificationDecoder](/docs/transformers/v5.23.0/ko/model_doc/perceiver#transformers.models.perceiver.modeling_perceiver.PerceiverClassificationDecoder)를 사용합니다.
이 모델은 [PreTrainedModel](/docs/transformers/v5.23.0/ko/main_classes/model#transformers.PreTrainedModel)에서 상속됩니다. 라이브러리가 모든 모델에 대해 구현하는 일반적 메서드(다운로드 또는 저장, 입력 임베딩 크기 조정, 헤드 프루닝 등)에 대해서는 상위 클래스 문서를 확인하세요.
이 모델은 또한 PyTorch [torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module)의 하위 클래스입니다. 일반적인 PyTorch Module처럼 사용하며, 일반적인 사용법과 동작에 관한 모든 사항은 PyTorch 문서를 참조하세요.
#### forward[[transformers.PerceiverForImageClassificationFourier.forward]]
```python
forward(inputs: typing.Optional[torch.Tensor] = None, attention_mask: typing.Optional[torch.Tensor] = None, output_attentions: bool | None = None, output_hidden_states: bool | None = None, labels: typing.Optional[torch.Tensor] = None, return_dict: bool | None = None, pixel_values: typing.Optional[torch.Tensor] = None, **kwargs)
```
[소스](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/perceiver/modeling_perceiver.py#L1219)
**매개변수:**
inputs (`torch.Tensor`, *선택 사항*) : perceiver의 입력입니다. 이미지, 텍스트, 오디오, 비디오 등 무엇이든 될 수 있습니다.
attention_mask (`torch.Tensor`, shape `(batch_size, sequence_length)`, *선택 사항*) : 패딩 토큰 인덱스에 대한 attention을 수행하지 않도록 방지하는 마스크입니다. `[0, 1]`에서 선택된 마스크 값: - **마스크되지 않은** 토큰은 1, - **마스크된** 토큰은 0. [attention 마스크란?](../glossary#attention-mask)
output_attentions (`bool`, *선택 사항*) : 모든 어텐션 레이어의 어텐션 텐서를 반환할지 여부. 자세한 내용은 반환 텐서 섹션의 `attentions`를 참조하세요.
output_hidden_states (`bool`, *선택 사항*) : 모든 레이어의 hidden states를 반환할지 여부. 자세한 내용은 반환되는 텐서 중 `hidden_states` 항목을 참조하세요.
labels (`torch.LongTensor`, shape `(batch_size,)`, *선택 사항*) : 이미지 분류/회귀 손실을 계산하는 데 사용되는 라벨. 인덱스는 `[0, ..., config.num_labels - 1]` 범위에 있어야 합니다. `config.num_labels == 1`인 경우 회귀 손실(평균 제곱 손실)이 계산되고, `config.num_labels > 1`인 경우 분류 손실(크로스 엔트로피)이 계산됩니다.
return_dict (`bool`, *선택 사항*) : 일반 튜플 대신 [ModelOutput](/docs/transformers/v5.23.0/ko/main_classes/output#transformers.utils.ModelOutput)를 반환할지 여부.
pixel_values (`torch.Tensor`, shape `(batch_size, num_channels, image_size, image_size)`, *선택 사항*) : 입력 이미지에 해당하는 텐서입니다. 픽셀 값은 [PerceiverImageProcessor](/docs/transformers/v5.23.0/ko/model_doc/perceiver#transformers.PerceiverImageProcessor)를 사용하여 얻을 수 있습니다. 자세한 내용은 [PerceiverImageProcessor.__call__()](/docs/transformers/v5.23.0/ko/model_doc/molmo2#transformers.Molmo2ImageProcessor.__call__)를 참조하세요 (`processor_class`는 이미지 처리에 [PerceiverImageProcessor](/docs/transformers/v5.23.0/ko/model_doc/perceiver#transformers.PerceiverImageProcessor)를 사용합니다).
**반환값:** [PerceiverClassifierOutput](/docs/transformers/v5.23.0/ko/model_doc/perceiver#transformers.models.perceiver.modeling_perceiver.PerceiverClassifierOutput) 또는 `tuple(torch.Tensor)`
구성([PerceiverConfig](/docs/transformers/v5.23.0/ko/model_doc/perceiver#transformers.PerceiverConfig))과 입력에 따라 다양한 요소를 포함하는 [PerceiverClassifierOutput](/docs/transformers/v5.23.0/ko/model_doc/perceiver#transformers.models.perceiver.modeling_perceiver.PerceiverClassifierOutput) 또는 `torch.Tensor`의 튜플(`return_dict=False`가 전달되거나 `config.return_dict=False`인 경우).
[PerceiverForImageClassificationFourier](/docs/transformers/v5.23.0/ko/model_doc/perceiver#transformers.PerceiverForImageClassificationFourier)의 forward 메서드는 `__call__` 특수 메서드를 오버라이드합니다.
`Module` 인스턴스는 전처리 및 후처리 단계를 실행하는 것을 처리하지만, 이 함수는 해당 단계를 조용히 무시하므로, 순전파(forward pass) 레시피를 이 함수 내에서 정의해야 하더라도 이후에는 이 함수 대신 `Module` 인스턴스를 호출해야 합니다.
- **loss** (`torch.Tensor`, shape `(1,)`, *선택*, `labels`이 제공될 때 반환됨) -- 분류(또는 config.num_labels==1인 경우 회귀) 손실.
- **logits** (`torch.Tensor`, shape `(batch_size, config.num_labels)`) -- SoftMax 적용 전 분류(또는 config.num_labels==1인 경우 회귀) 점수.
- **hidden_states** (`tuple[torch.Tensor]`, *선택*, `output_hidden_states=True`가 전달되었거나 `config.output_hidden_states=True`인 경우 반환됨) -- `torch.Tensor`의 튜플(모델에 임베딩 레이어가 있는 경우 임베딩 출력용 1개 + 각 레이어의 출력용 1개)로, 모양은 `(batch_size, sequence_length, hidden_size)`입니다.
각 레이어의 출력에서 모델의 Hidden-states와 선택적 초기 임베딩 출력을 포함합니다.
- **attentions** (`tuple[torch.Tensor]`, *선택*, `output_attentions=True`가 전달되었거나 `config.output_attentions=True`인 경우 반환됨) -- 각 레이어마다 하나씩 포함된 `torch.Tensor`의 튜플로, 모양은 `(batch_size, num_heads, sequence_length, sequence_length)`입니다.
self-attention 헤드에서 가중 평균을 계산하는 데 사용되는 attention softmax 이후의 attention 가중치입니다.
- **cross_attentions** (`tuple[torch.Tensor]`, *선택*, `output_attentions=True`가 전달되거나 `config.output_attentions=True`일 때 반환) -- 각 레이어마다 하나씩 포함된 `torch.Tensor`의 튜플로, shape는 `(batch_size, num_heads, sequence_length, sequence_length)`입니다.
decoder의 cross-attention 레이어에서 attention softmax를 적용한 후, cross-attention 헤드에서 가중 평균을 계산하는 데 사용되는 attention 가중치입니다.
예:
```python
>>> from transformers import AutoImageProcessor, PerceiverForImageClassificationFourier
>>> from PIL import Image
>>> from huggingface_hub.utils import httpx
>>> from io import BytesIO
>>> url = "http://images.cocodataset.org/val2017/000000039769.jpg"
>>> with httpx.stream("GET", url) as response:
... image = Image.open(BytesIO(response.read()))
>>> image_processor = AutoImageProcessor.from_pretrained("deepmind/vision-perceiver-fourier")
>>> model = PerceiverForImageClassificationFourier.from_pretrained("deepmind/vision-perceiver-fourier")
>>> inputs = image_processor(images=image, return_tensors="pt").pixel_values
>>> outputs = model(inputs=inputs)
>>> logits = outputs.logits
>>> list(logits.shape)
[1, 1000]
>>> # model predicts one of the 1000 ImageNet classes
>>> predicted_class_idx = logits.argmax(-1).item()
>>> print("Predicted class:", model.config.id2label[predicted_class_idx])
Predicted class: tabby, tabby cat
```
## PerceiverForImageClassificationConvProcessing[[transformers.PerceiverForImageClassificationConvProcessing]]
#### transformers.PerceiverForImageClassificationConvProcessing[[transformers.PerceiverForImageClassificationConvProcessing]]
```python
transformers.PerceiverForImageClassificationConvProcessing(config: PerceiverConfig)
```
[소스](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/perceiver/modeling_perceiver.py#L1310)
**매개변수:**
config ([PerceiverConfig](/docs/transformers/v5.23.0/ko/model_doc/perceiver#transformers.PerceiverConfig)) : 모델의 모든 매개변수를 포함하는 모델 구성 클래스입니다. 구성 파일로 초기화하는 것은 모델과 관련된 가중치를 로드하지 않으며, 구성 정보만 로드합니다. 모델 가중치를 로드하려면 [from_pretrained()](/docs/transformers/v5.23.0/ko/main_classes/model#transformers.PreTrainedModel.from_pretrained) 메서드를 확인하세요.
ImageNet과 같은 작업에 Perceiver를 이미지 분류용으로 사용하는 예시입니다.
이 모델은 2D conv+maxpool 전처리 네트워크를 사용합니다. 논문에서 보여준 바와 같이, 이 모델은 ImageNet에서 top-1 정확도 82.1을 달성할 수 있습니다.
[PerceiverForImageClassificationLearned](/docs/transformers/v5.23.0/ko/model_doc/perceiver#transformers.PerceiverForImageClassificationLearned)는 입력 이미지를 전처리하기 위해 [PerceiverImagePreprocessor](/docs/transformers/v5.23.0/ko/model_doc/perceiver#transformers.models.perceiver.modeling_perceiver.PerceiverImagePreprocessor)(`prep_type="conv"` 사용)를, 그리고 [PerceiverModel](/docs/transformers/v5.23.0/ko/model_doc/perceiver#transformers.PerceiverModel)의 잠재 표현을 분류 로짓으로 디코딩하기 위해 [PerceiverClassificationDecoder](/docs/transformers/v5.23.0/ko/model_doc/perceiver#transformers.models.perceiver.modeling_perceiver.PerceiverClassificationDecoder)를 사용합니다.
이 모델은 [PreTrainedModel](/docs/transformers/v5.23.0/ko/main_classes/model#transformers.PreTrainedModel)에서 상속됩니다. 라이브러리가 모든 모델에 대해 구현하는 일반적 메서드(다운로드 또는 저장, 입력 임베딩 크기 조정, 헤드 프루닝 등)에 대해서는 상위 클래스 문서를 확인하세요.
이 모델은 또한 PyTorch [torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module)의 하위 클래스입니다. 일반적인 PyTorch Module처럼 사용하며, 일반적인 사용법과 동작에 관한 모든 사항은 PyTorch 문서를 참조하세요.
#### forward[[transformers.PerceiverForImageClassificationConvProcessing.forward]]
```python
forward(inputs: typing.Optional[torch.Tensor] = None, attention_mask: typing.Optional[torch.Tensor] = None, output_attentions: bool | None = None, output_hidden_states: bool | None = None, labels: typing.Optional[torch.Tensor] = None, return_dict: bool | None = None, pixel_values: typing.Optional[torch.Tensor] = None, **kwargs)
```
[소스](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/perceiver/modeling_perceiver.py#L1343)
**매개변수:**
inputs (`torch.Tensor`, *선택 사항*) : perceiver의 입력입니다. 이미지, 텍스트, 오디오, 비디오 등 무엇이든 될 수 있습니다.
attention_mask (`torch.Tensor`, shape `(batch_size, sequence_length)`, *선택 사항*) : 패딩 토큰 인덱스에 대한 attention을 수행하지 않도록 방지하는 마스크입니다. `[0, 1]`에서 선택된 마스크 값: - **마스크되지 않은** 토큰은 1, - **마스크된** 토큰은 0. [attention 마스크란?](../glossary#attention-mask)
output_attentions (`bool`, *선택 사항*) : 모든 어텐션 레이어의 어텐션 텐서를 반환할지 여부. 자세한 내용은 반환 텐서 섹션의 `attentions`를 참조하세요.
output_hidden_states (`bool`, *선택 사항*) : 모든 레이어의 hidden states를 반환할지 여부. 자세한 내용은 반환되는 텐서 중 `hidden_states` 항목을 참조하세요.
labels (`torch.LongTensor`, shape `(batch_size,)`, *선택 사항*) : 이미지 분류/회귀 손실을 계산하는 데 사용되는 라벨. 인덱스는 `[0, ..., config.num_labels - 1]` 범위에 있어야 합니다. `config.num_labels == 1`인 경우 회귀 손실(평균 제곱 손실)이 계산되고, `config.num_labels > 1`인 경우 분류 손실(크로스 엔트로피)이 계산됩니다.
return_dict (`bool`, *선택 사항*) : 일반 튜플 대신 [ModelOutput](/docs/transformers/v5.23.0/ko/main_classes/output#transformers.utils.ModelOutput)를 반환할지 여부.
pixel_values (`torch.Tensor`, shape `(batch_size, num_channels, image_size, image_size)`, *선택 사항*) : 입력 이미지에 해당하는 텐서입니다. 픽셀 값은 [PerceiverImageProcessor](/docs/transformers/v5.23.0/ko/model_doc/perceiver#transformers.PerceiverImageProcessor)를 사용하여 얻을 수 있습니다. 자세한 내용은 [PerceiverImageProcessor.__call__()](/docs/transformers/v5.23.0/ko/model_doc/molmo2#transformers.Molmo2ImageProcessor.__call__)를 참조하세요 (`processor_class`는 이미지 처리에 [PerceiverImageProcessor](/docs/transformers/v5.23.0/ko/model_doc/perceiver#transformers.PerceiverImageProcessor)를 사용합니다).
**반환값:** [PerceiverClassifierOutput](/docs/transformers/v5.23.0/ko/model_doc/perceiver#transformers.models.perceiver.modeling_perceiver.PerceiverClassifierOutput) 또는 `tuple(torch.Tensor)`
구성([PerceiverConfig](/docs/transformers/v5.23.0/ko/model_doc/perceiver#transformers.PerceiverConfig))과 입력에 따라 다양한 요소를 포함하는 [PerceiverClassifierOutput](/docs/transformers/v5.23.0/ko/model_doc/perceiver#transformers.models.perceiver.modeling_perceiver.PerceiverClassifierOutput) 또는 `torch.Tensor`의 튜플(`return_dict=False`가 전달되거나 `config.return_dict=False`인 경우).
[PerceiverForImageClassificationConvProcessing](/docs/transformers/v5.23.0/ko/model_doc/perceiver#transformers.PerceiverForImageClassificationConvProcessing)의 forward 메서드는 `__call__` 특수 메서드를 오버라이드합니다.
`Module` 인스턴스는 전처리 및 후처리 단계를 실행하는 것을 처리하지만, 이 함수는 해당 단계를 조용히 무시하므로, 순전파(forward pass) 레시피를 이 함수 내에서 정의해야 하더라도 이후에는 이 함수 대신 `Module` 인스턴스를 호출해야 합니다.
- **loss** (`torch.Tensor`, shape `(1,)`, *선택*, `labels`이 제공될 때 반환됨) -- 분류(또는 config.num_labels==1인 경우 회귀) 손실.
- **logits** (`torch.Tensor`, shape `(batch_size, config.num_labels)`) -- SoftMax 적용 전 분류(또는 config.num_labels==1인 경우 회귀) 점수.
- **hidden_states** (`tuple[torch.Tensor]`, *선택*, `output_hidden_states=True`가 전달되었거나 `config.output_hidden_states=True`인 경우 반환됨) -- `torch.Tensor`의 튜플(모델에 임베딩 레이어가 있는 경우 임베딩 출력용 1개 + 각 레이어의 출력용 1개)로, 모양은 `(batch_size, sequence_length, hidden_size)`입니다.
각 레이어의 출력에서 모델의 Hidden-states와 선택적 초기 임베딩 출력을 포함합니다.
- **attentions** (`tuple[torch.Tensor]`, *선택*, `output_attentions=True`가 전달되었거나 `config.output_attentions=True`인 경우 반환됨) -- 각 레이어마다 하나씩 포함된 `torch.Tensor`의 튜플로, 모양은 `(batch_size, num_heads, sequence_length, sequence_length)`입니다.
self-attention 헤드에서 가중 평균을 계산하는 데 사용되는 attention softmax 이후의 attention 가중치입니다.
- **cross_attentions** (`tuple[torch.Tensor]`, *선택*, `output_attentions=True`가 전달되거나 `config.output_attentions=True`일 때 반환) -- 각 레이어마다 하나씩 포함된 `torch.Tensor`의 튜플로, shape는 `(batch_size, num_heads, sequence_length, sequence_length)`입니다.
decoder의 cross-attention 레이어에서 attention softmax를 적용한 후, cross-attention 헤드에서 가중 평균을 계산하는 데 사용되는 attention 가중치입니다.
예:
```python
>>> from transformers import AutoImageProcessor, PerceiverForImageClassificationConvProcessing
>>> from PIL import Image
>>> from huggingface_hub.utils import httpx
>>> from io import BytesIO
>>> url = "http://images.cocodataset.org/val2017/000000039769.jpg"
>>> with httpx.stream("GET", url) as response:
... image = Image.open(BytesIO(response.read()))
>>> image_processor = AutoImageProcessor.from_pretrained("deepmind/vision-perceiver-conv")
>>> model = PerceiverForImageClassificationConvProcessing.from_pretrained("deepmind/vision-perceiver-conv")
>>> inputs = image_processor(images=image, return_tensors="pt").pixel_values
>>> outputs = model(inputs=inputs)
>>> logits = outputs.logits
>>> list(logits.shape)
[1, 1000]
>>> # model predicts one of the 1000 ImageNet classes
>>> predicted_class_idx = logits.argmax(-1).item()
>>> print("Predicted class:", model.config.id2label[predicted_class_idx])
Predicted class: tabby, tabby cat
```
## PerceiverForOpticalFlow[[transformers.PerceiverForOpticalFlow]]
#### transformers.PerceiverForOpticalFlow[[transformers.PerceiverForOpticalFlow]]
```python
transformers.PerceiverForOpticalFlow(config: PerceiverConfig)
```
[소스](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/perceiver/modeling_perceiver.py#L1434)
**매개변수:**
config ([PerceiverConfig](/docs/transformers/v5.23.0/ko/model_doc/perceiver#transformers.PerceiverConfig)) : 모델의 모든 매개변수를 포함하는 모델 구성 클래스입니다. 구성 파일로 초기화하는 것은 모델과 관련된 가중치를 로드하지 않으며, 구성 정보만 로드합니다. 모델 가중치를 로드하려면 [from_pretrained()](/docs/transformers/v5.23.0/ko/main_classes/model#transformers.PreTrainedModel.from_pretrained) 메서드를 확인하세요.
Sintel, KITTI와 같은 작업을 위한 광류(optical flow)에서 Perceiver의 사용 예시입니다. [PerceiverForOpticalFlow](/docs/transformers/v5.23.0/ko/model_doc/perceiver#transformers.PerceiverForOpticalFlow)는 입력 이미지를 전처리하기 위해 [PerceiverImagePreprocessor](/docs/transformers/v5.23.0/ko/model_doc/perceiver#transformers.models.perceiver.modeling_perceiver.PerceiverImagePreprocessor)(*prep_type="patches"* 사용)를, 그리고 [PerceiverModel](/docs/transformers/v5.23.0/ko/model_doc/perceiver#transformers.PerceiverModel)의 잠재 표현을 디코딩하기 위해 [PerceiverOpticalFlowDecoder](/docs/transformers/v5.23.0/ko/model_doc/perceiver#transformers.models.perceiver.modeling_perceiver.PerceiverOpticalFlowDecoder)를 사용합니다.
입력으로, 채널 차원을 따라 2개의 연속 프레임을 연결하고 각 픽셀 주위의 3 x 3 패치를 추출합니다(각 픽셀당 3 x 3 x 3 x 2 = 54개의 값이 됩니다). 고정된 Fourier 위치 인코딩을 사용하여 패치 내 각 픽셀의 위치를 인코딩합니다. 다음으로, Perceiver 인코더를 적용합니다. 디코딩을 위해, 입력에 사용된 동일한 인코딩을 사용하여 잠재 표현을 쿼리합니다.
이 모델은 [PreTrainedModel](/docs/transformers/v5.23.0/ko/main_classes/model#transformers.PreTrainedModel)에서 상속됩니다. 라이브러리가 모든 모델에 대해 구현하는 일반적 메서드(다운로드 또는 저장, 입력 임베딩 크기 조정, 헤드 프루닝 등)에 대해서는 상위 클래스 문서를 확인하세요.
이 모델은 또한 PyTorch [torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module)의 하위 클래스입니다. 일반적인 PyTorch Module처럼 사용하며, 일반적인 사용법과 동작에 관한 모든 사항은 PyTorch 문서를 참조하세요.
#### forward[[transformers.PerceiverForOpticalFlow.forward]]
```python
forward(inputs: typing.Optional[torch.Tensor] = None, attention_mask: typing.Optional[torch.Tensor] = None, output_attentions: bool | None = None, output_hidden_states: bool | None = None, labels: typing.Optional[torch.Tensor] = None, return_dict: bool | None = None, **kwargs)
```
[소스](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/perceiver/modeling_perceiver.py#L1484)
**매개변수:**
inputs (`torch.Tensor`, *선택 사항*) : perceiver의 입력입니다. 이미지, 텍스트, 오디오, 비디오 등 무엇이든 될 수 있습니다.
attention_mask (`torch.Tensor`, shape `(batch_size, sequence_length)`, *선택 사항*) : 패딩 토큰 인덱스에 대한 attention을 수행하지 않도록 방지하는 마스크입니다. `[0, 1]`에서 선택된 마스크 값: - **마스크되지 않은** 토큰은 1, - **마스크된** 토큰은 0. [attention 마스크란?](../glossary#attention-mask)
output_attentions (`bool`, *선택 사항*) : 모든 어텐션 레이어의 어텐션 텐서를 반환할지 여부. 자세한 내용은 반환 텐서 섹션의 `attentions`를 참조하세요.
output_hidden_states (`bool`, *선택 사항*) : 모든 레이어의 hidden states를 반환할지 여부. 자세한 내용은 반환되는 텐서 중 `hidden_states` 항목을 참조하세요.
labels (`torch.LongTensor`, shape `(batch_size,)`, *선택 사항*) : 광학 흐름 손실을 계산하기 위한 라벨. 인덱스는 `[0, ..., config.num_labels - 1]` 범위여야 합니다.
return_dict (`bool`, *선택 사항*) : 일반 튜플 대신 [ModelOutput](/docs/transformers/v5.23.0/ko/main_classes/output#transformers.utils.ModelOutput)를 반환할지 여부.
**반환값:** [PerceiverClassifierOutput](/docs/transformers/v5.23.0/ko/model_doc/perceiver#transformers.models.perceiver.modeling_perceiver.PerceiverClassifierOutput) 또는 `tuple(torch.Tensor)`
구성([PerceiverConfig](/docs/transformers/v5.23.0/ko/model_doc/perceiver#transformers.PerceiverConfig))과 입력에 따라 다양한 요소를 포함하는 [PerceiverClassifierOutput](/docs/transformers/v5.23.0/ko/model_doc/perceiver#transformers.models.perceiver.modeling_perceiver.PerceiverClassifierOutput) 또는 `torch.Tensor`의 튜플(`return_dict=False`가 전달되거나 `config.return_dict=False`인 경우).
[PerceiverForOpticalFlow](/docs/transformers/v5.23.0/ko/model_doc/perceiver#transformers.PerceiverForOpticalFlow)의 forward 메서드는 `__call__` 특수 메서드를 오버라이드합니다.
`Module` 인스턴스는 전처리 및 후처리 단계를 실행하는 것을 처리하지만, 이 함수는 해당 단계를 조용히 무시하므로, 순전파(forward pass) 레시피를 이 함수 내에서 정의해야 하더라도 이후에는 이 함수 대신 `Module` 인스턴스를 호출해야 합니다.
- **loss** (`torch.Tensor`, shape `(1,)`, *선택*, `labels`이 제공될 때 반환됨) -- 분류(또는 config.num_labels==1인 경우 회귀) 손실.
- **logits** (`torch.Tensor`, shape `(batch_size, config.num_labels)`) -- SoftMax 적용 전 분류(또는 config.num_labels==1인 경우 회귀) 점수.
- **hidden_states** (`tuple[torch.Tensor]`, *선택*, `output_hidden_states=True`가 전달되었거나 `config.output_hidden_states=True`인 경우 반환됨) -- `torch.Tensor`의 튜플(모델에 임베딩 레이어가 있는 경우 임베딩 출력용 1개 + 각 레이어의 출력용 1개)로, 모양은 `(batch_size, sequence_length, hidden_size)`입니다.
각 레이어의 출력에서 모델의 Hidden-states와 선택적 초기 임베딩 출력을 포함합니다.
- **attentions** (`tuple[torch.Tensor]`, *선택*, `output_attentions=True`가 전달되었거나 `config.output_attentions=True`인 경우 반환됨) -- 각 레이어마다 하나씩 포함된 `torch.Tensor`의 튜플로, 모양은 `(batch_size, num_heads, sequence_length, sequence_length)`입니다.
self-attention 헤드에서 가중 평균을 계산하는 데 사용되는 attention softmax 이후의 attention 가중치입니다.
- **cross_attentions** (`tuple[torch.Tensor]`, *선택*, `output_attentions=True`가 전달되거나 `config.output_attentions=True`일 때 반환) -- 각 레이어마다 하나씩 포함된 `torch.Tensor`의 튜플로, shape는 `(batch_size, num_heads, sequence_length, sequence_length)`입니다.
decoder의 cross-attention 레이어에서 attention softmax를 적용한 후, cross-attention 헤드에서 가중 평균을 계산하는 데 사용되는 attention 가중치입니다.
예:
```python
>>> from transformers import PerceiverForOpticalFlow
>>> import torch
>>> model = PerceiverForOpticalFlow.from_pretrained("deepmind/optical-flow-perceiver")
>>> # in the Perceiver IO paper, the authors extract a 3 x 3 patch around each pixel,
>>> # leading to 3 x 3 x 3 = 27 values for each pixel (as each pixel also has 3 color channels)
>>> # patches have shape (batch_size, num_frames, num_channels, height, width)
>>> # the authors train on resolutions of 368 x 496
>>> patches = torch.randn(1, 2, 27, 368, 496)
>>> outputs = model(inputs=patches)
>>> logits = outputs.logits
>>> list(logits.shape)
[1, 368, 496, 2]
```
## PerceiverForMultimodalAutoencoding[[transformers.PerceiverForMultimodalAutoencoding]]
#### transformers.PerceiverForMultimodalAutoencoding[[transformers.PerceiverForMultimodalAutoencoding]]
```python
transformers.PerceiverForMultimodalAutoencoding(config: PerceiverConfig)
```
[소스](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/perceiver/modeling_perceiver.py#L1576)
**매개변수:**
config ([PerceiverConfig](/docs/transformers/v5.23.0/ko/model_doc/perceiver#transformers.PerceiverConfig)) : 모델의 모든 매개변수를 포함하는 모델 구성 클래스입니다. 구성 파일로 초기화하는 것은 모델과 관련된 가중치를 로드하지 않으며, 구성 정보만 로드합니다. 모델 가중치를 로드하려면 [from_pretrained()](/docs/transformers/v5.23.0/ko/main_classes/model#transformers.PreTrainedModel.from_pretrained) 메서드를 확인하세요.
Kinetics-700와 같은 작업을 위해 Perceiver를 멀티모달(비디오) 오토인코딩에 사용하는 예시
[PerceiverForMultimodalAutoencoding](/docs/transformers/v5.23.0/ko/model_doc/perceiver#transformers.PerceiverForMultimodalAutoencoding)는 [PerceiverMultimodalPreprocessor](/docs/transformers/v5.23.0/ko/model_doc/perceiver#transformers.models.perceiver.modeling_perceiver.PerceiverMultimodalPreprocessor)를 사용하여 이미지, 오디오, 클래스 라벨의 3가지 모달리티를 전처리합니다. 이 전처리기는 모달리티별 전처리기를 사용해 각 모달리티를 개별적으로 전처리한 뒤, 결과를 연결합니다. 학습 가능한 위치 임베딩을 사용해 각 모달리티를 동일한 채널 수로 패딩하여 시간 차원에서의 연결을 가능하게 합니다. 이후 Perceiver 인코더를 적용합니다.
[PerceiverMultimodalDecoder](/docs/transformers/v5.23.0/ko/model_doc/perceiver#transformers.models.perceiver.modeling_perceiver.PerceiverMultimodalDecoder)는 [PerceiverModel](/docs/transformers/v5.23.0/ko/model_doc/perceiver#transformers.PerceiverModel)의 잠재 표현을 디코딩하는 데 사용됩니다. 이 디코더는 각 모달리티별 디코더를 사용하여 쿼리를 구성합니다. 디코더 쿼리는 전처리된 입력을 기반으로 생성됩니다. 그러나 단일 포워드 패스에서 전체 비디오를 오토인코딩하는 것은 계산적으로 불가능하므로, 잠재 표현과의 크로스 어텐션을 수행하기 위해 디코더 쿼리의 일부만 사용합니다. 이는 각 모달리티에 대한 하위 샘플링된 인덱스로 결정되며, [PerceiverForMultimodalAutoencoding](/docs/transformers/v5.23.0/ko/model_doc/perceiver#transformers.PerceiverForMultimodalAutoencoding)의 포워드 패스에 추가 입력으로 제공할 수 있습니다.
[PerceiverMultimodalDecoder](/docs/transformers/v5.23.0/ko/model_doc/perceiver#transformers.models.perceiver.modeling_perceiver.PerceiverMultimodalDecoder)는 시간 차원을 따라 연결하기 위해 서로 다른 모달리티의 디코더 쿼리를 동일한 채널 수로 패딩합니다. 그런 다음 [PerceiverModel](/docs/transformers/v5.23.0/ko/model_doc/perceiver#transformers.PerceiverModel)의 잠재 표현과 크로스 어텐션을 수행합니다.
마지막으로, `~models.perceiver.modeling_perceiver.PerceiverMultiModalPostprocessor`는 이 텐서를 실제 비디오로 변환하는 데 사용됩니다. 먼저 출력을 각 모달리티로 분리한 다음, 각 모달리티에 해당하는 후처리기를 적용합니다.
평가 시 분류 라벨을 마스킹(즉, "label" 모달리티에 대해 단순히 0으로 이루어진 텐서를 제공하는 것)하면, 이 자동 인코딩 모델은 Kinetics 700 비디오 분류기가 된다는 점에 유의하세요.
이 모델은 [PreTrainedModel](/docs/transformers/v5.23.0/ko/main_classes/model#transformers.PreTrainedModel)에서 상속됩니다. 라이브러리가 모든 모델에 대해 구현하는 일반적 메서드(다운로드 또는 저장, 입력 임베딩 크기 조정, 헤드 프루닝 등)에 대해서는 상위 클래스 문서를 확인하세요.
이 모델은 또한 PyTorch [torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module)의 하위 클래스입니다. 일반적인 PyTorch Module처럼 사용하며, 일반적인 사용법과 동작에 관한 모든 사항은 PyTorch 문서를 참조하세요.
#### forward[[transformers.PerceiverForMultimodalAutoencoding.forward]]
```python
forward(inputs: typing.Optional[torch.Tensor] = None, attention_mask: typing.Optional[torch.Tensor] = None, subsampled_output_points: dict[str, torch.Tensor] | None = None, output_attentions: bool | None = None, output_hidden_states: bool | None = None, labels: typing.Optional[torch.Tensor] = None, return_dict: bool | None = None, **kwargs)
```
[소스](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/perceiver/modeling_perceiver.py#L1692)
**매개변수:**
inputs (`torch.Tensor`, *선택 사항*) : perceiver의 입력입니다. 이미지, 텍스트, 오디오, 비디오 등 무엇이든 될 수 있습니다.
attention_mask (`torch.Tensor`, shape `(batch_size, sequence_length)`, *선택 사항*) : 패딩 토큰 인덱스에 대한 attention을 수행하지 않도록 방지하는 마스크입니다. `[0, 1]`에서 선택된 마스크 값: - **마스크되지 않은** 토큰은 1, - **마스크된** 토큰은 0. [attention 마스크란?](../glossary#attention-mask)
subsampled_output_points (`dict[str, torch.Tensor]`, *선택 사항*) : 디코더의 쿼리로 사용되는 텐서의 사전입니다. 디코더는 이러한 쿼리를 모델의 잠재 표현(latent representation)으로 매핑합니다. 예를 들어, 특정 이미지 패치만 디코딩하는 경우와 같이 부분 샘플링된(subsampled) 디코딩에 사용됩니다.
output_attentions (`bool`, *선택 사항*) : 모든 어텐션 레이어의 어텐션 텐서를 반환할지 여부. 자세한 내용은 반환 텐서 섹션의 `attentions`를 참조하세요.
output_hidden_states (`bool`, *선택 사항*) : 모든 레이어의 hidden states를 반환할지 여부. 자세한 내용은 반환되는 텐서 중 `hidden_states` 항목을 참조하세요.
labels (`torch.LongTensor`, shape `(batch_size,)`, *선택 사항*) : 이미지 분류/회귀 손실을 계산하는 데 사용되는 라벨. 인덱스는 `[0, ..., config.num_labels - 1]` 범위에 있어야 합니다. `config.num_labels == 1`인 경우 회귀 손실(평균 제곱 손실)이 계산되고, `config.num_labels > 1`인 경우 분류 손실(크로스 엔트로피)이 계산됩니다.
return_dict (`bool`, *선택 사항*) : 일반 튜플 대신 [ModelOutput](/docs/transformers/v5.23.0/ko/main_classes/output#transformers.utils.ModelOutput)를 반환할지 여부.
**반환값:** [PerceiverClassifierOutput](/docs/transformers/v5.23.0/ko/model_doc/perceiver#transformers.models.perceiver.modeling_perceiver.PerceiverClassifierOutput) 또는 `tuple(torch.Tensor)`
구성([PerceiverConfig](/docs/transformers/v5.23.0/ko/model_doc/perceiver#transformers.PerceiverConfig))과 입력에 따라 다양한 요소를 포함하는 [PerceiverClassifierOutput](/docs/transformers/v5.23.0/ko/model_doc/perceiver#transformers.models.perceiver.modeling_perceiver.PerceiverClassifierOutput) 또는 `torch.Tensor`의 튜플(`return_dict=False`가 전달되거나 `config.return_dict=False`인 경우).
[PerceiverForMultimodalAutoencoding](/docs/transformers/v5.23.0/ko/model_doc/perceiver#transformers.PerceiverForMultimodalAutoencoding)의 forward 메서드는 `__call__` 특수 메서드를 오버라이드합니다.
`Module` 인스턴스는 전처리 및 후처리 단계를 실행하는 것을 처리하지만, 이 함수는 해당 단계를 조용히 무시하므로, 순전파(forward pass) 레시피를 이 함수 내에서 정의해야 하더라도 이후에는 이 함수 대신 `Module` 인스턴스를 호출해야 합니다.
- **loss** (`torch.Tensor`, shape `(1,)`, *선택*, `labels`이 제공될 때 반환됨) -- 분류(또는 config.num_labels==1인 경우 회귀) 손실.
- **logits** (`torch.Tensor`, shape `(batch_size, config.num_labels)`) -- SoftMax 적용 전 분류(또는 config.num_labels==1인 경우 회귀) 점수.
- **hidden_states** (`tuple[torch.Tensor]`, *선택*, `output_hidden_states=True`가 전달되었거나 `config.output_hidden_states=True`인 경우 반환됨) -- `torch.Tensor`의 튜플(모델에 임베딩 레이어가 있는 경우 임베딩 출력용 1개 + 각 레이어의 출력용 1개)로, 모양은 `(batch_size, sequence_length, hidden_size)`입니다.
각 레이어의 출력에서 모델의 Hidden-states와 선택적 초기 임베딩 출력을 포함합니다.
- **attentions** (`tuple[torch.Tensor]`, *선택*, `output_attentions=True`가 전달되었거나 `config.output_attentions=True`인 경우 반환됨) -- 각 레이어마다 하나씩 포함된 `torch.Tensor`의 튜플로, 모양은 `(batch_size, num_heads, sequence_length, sequence_length)`입니다.
self-attention 헤드에서 가중 평균을 계산하는 데 사용되는 attention softmax 이후의 attention 가중치입니다.
- **cross_attentions** (`tuple[torch.Tensor]`, *선택*, `output_attentions=True`가 전달되거나 `config.output_attentions=True`일 때 반환) -- 각 레이어마다 하나씩 포함된 `torch.Tensor`의 튜플로, shape는 `(batch_size, num_heads, sequence_length, sequence_length)`입니다.
decoder의 cross-attention 레이어에서 attention softmax를 적용한 후, cross-attention 헤드에서 가중 평균을 계산하는 데 사용되는 attention 가중치입니다.
예:
```python
>>> from transformers import PerceiverForMultimodalAutoencoding
>>> import torch
>>> import numpy as np
>>> # create multimodal inputs
>>> images = torch.randn((1, 16, 3, 224, 224))
>>> audio = torch.randn((1, 30720, 1))
>>> inputs = dict(image=images, audio=audio, label=torch.zeros((images.shape[0], 700)))
>>> model = PerceiverForMultimodalAutoencoding.from_pretrained("deepmind/multimodal-perceiver")
>>> # in the Perceiver IO paper, videos are auto-encoded in chunks
>>> # each chunk subsamples different index dimensions of the image and audio modality decoder queries
>>> nchunks = 128
>>> image_chunk_size = np.prod((16, 224, 224)) // nchunks
>>> audio_chunk_size = audio.shape[1] // model.config.samples_per_patch // nchunks
>>> # process the first chunk
>>> chunk_idx = 0
>>> subsampling = {
... "image": torch.arange(image_chunk_size * chunk_idx, image_chunk_size * (chunk_idx + 1)),
... "audio": torch.arange(audio_chunk_size * chunk_idx, audio_chunk_size * (chunk_idx + 1)),
... "label": None,
... }
>>> outputs = model(inputs=inputs, subsampled_output_points=subsampling)
>>> logits = outputs.logits
>>> list(logits["audio"].shape)
[1, 240]
>>> list(logits["image"].shape)
[1, 6272, 3]
>>> list(logits["label"].shape)
[1, 700]
```