# Swin2SR
## Ikhtisar
Model Swin2SR diusulkan dalam [Swin2SR: SwinV2 Transformer for Compressed Image Super-Resolution and Restoration](https://huggingface.co/papers/2209.11345) oleh Marcos V. Conde, Ui-Jin Choi, Maxime Burchi, Radu Timofte. Swin2SR meningkatkan model [SwinIR](https://github.com/JingyunLiang/SwinIR/) dengan mengintegrasikan lapisan [Swin Transformer v2](swinv2) yang memitigasi masalah seperti ketidakstabilan pelatihan, kesenjangan resolusi antara pra-pelatihan dan penyesuaian halus, serta kebutuhan data yang besar.
Abstrak dari makalah tersebut adalah sebagai berikut:
*Kompresi memainkan peran penting dalam transmisi dan penyimpanan gambar serta video yang efisien melalui sistem berbatas pita seperti layanan streaming, realitas virtual, atau video game. Namun, kompresi secara tak terhindarkan menyebabkan artefak dan hilangnya informasi asli, yang dapat sangat menurunkan kualitas visual. Karena alasan ini, peningkatan kualitas gambar terkompresi telah menjadi topik penelitian yang populer. Meskipun sebagian besar metode restorasi gambar terkini berbasis jaringan saraf konvolusional, metode berbasis transformer lainnya seperti SwinIR menunjukkan kinerja yang mengesankan pada tugas-tugas ini. Dalam makalah ini, kami mengeksplorasi Swin Transformer V2 yang baru untuk meningkatkan SwinIR pada super-resolusi gambar, dan khususnya pada skenario input terkompresi. Dengan menggunakan metode ini, kami dapat mengatasi masalah utama dalam pelatihan model visi transformer, seperti ketidakstabilan pelatihan, kesenjangan resolusi antara pra-pelatihan dan penyesuaian halus, serta kebutuhan data yang besar. Kami melakukan eksperimen pada tiga tugas representatif: penghilangan artefak kompresi JPEG, super-resolusi gambar (klasik dan ringan), dan super-resolusi gambar terkompresi. Hasil eksperimen menunjukkan bahwa metode kami, Swin2SR, dapat meningkatkan konvergensi pelatihan dan kinerja SwinIR, serta merupakan solusi top-5 pada "AIM 2022 Challenge on Super-Resolution of Compressed Image and Video".*
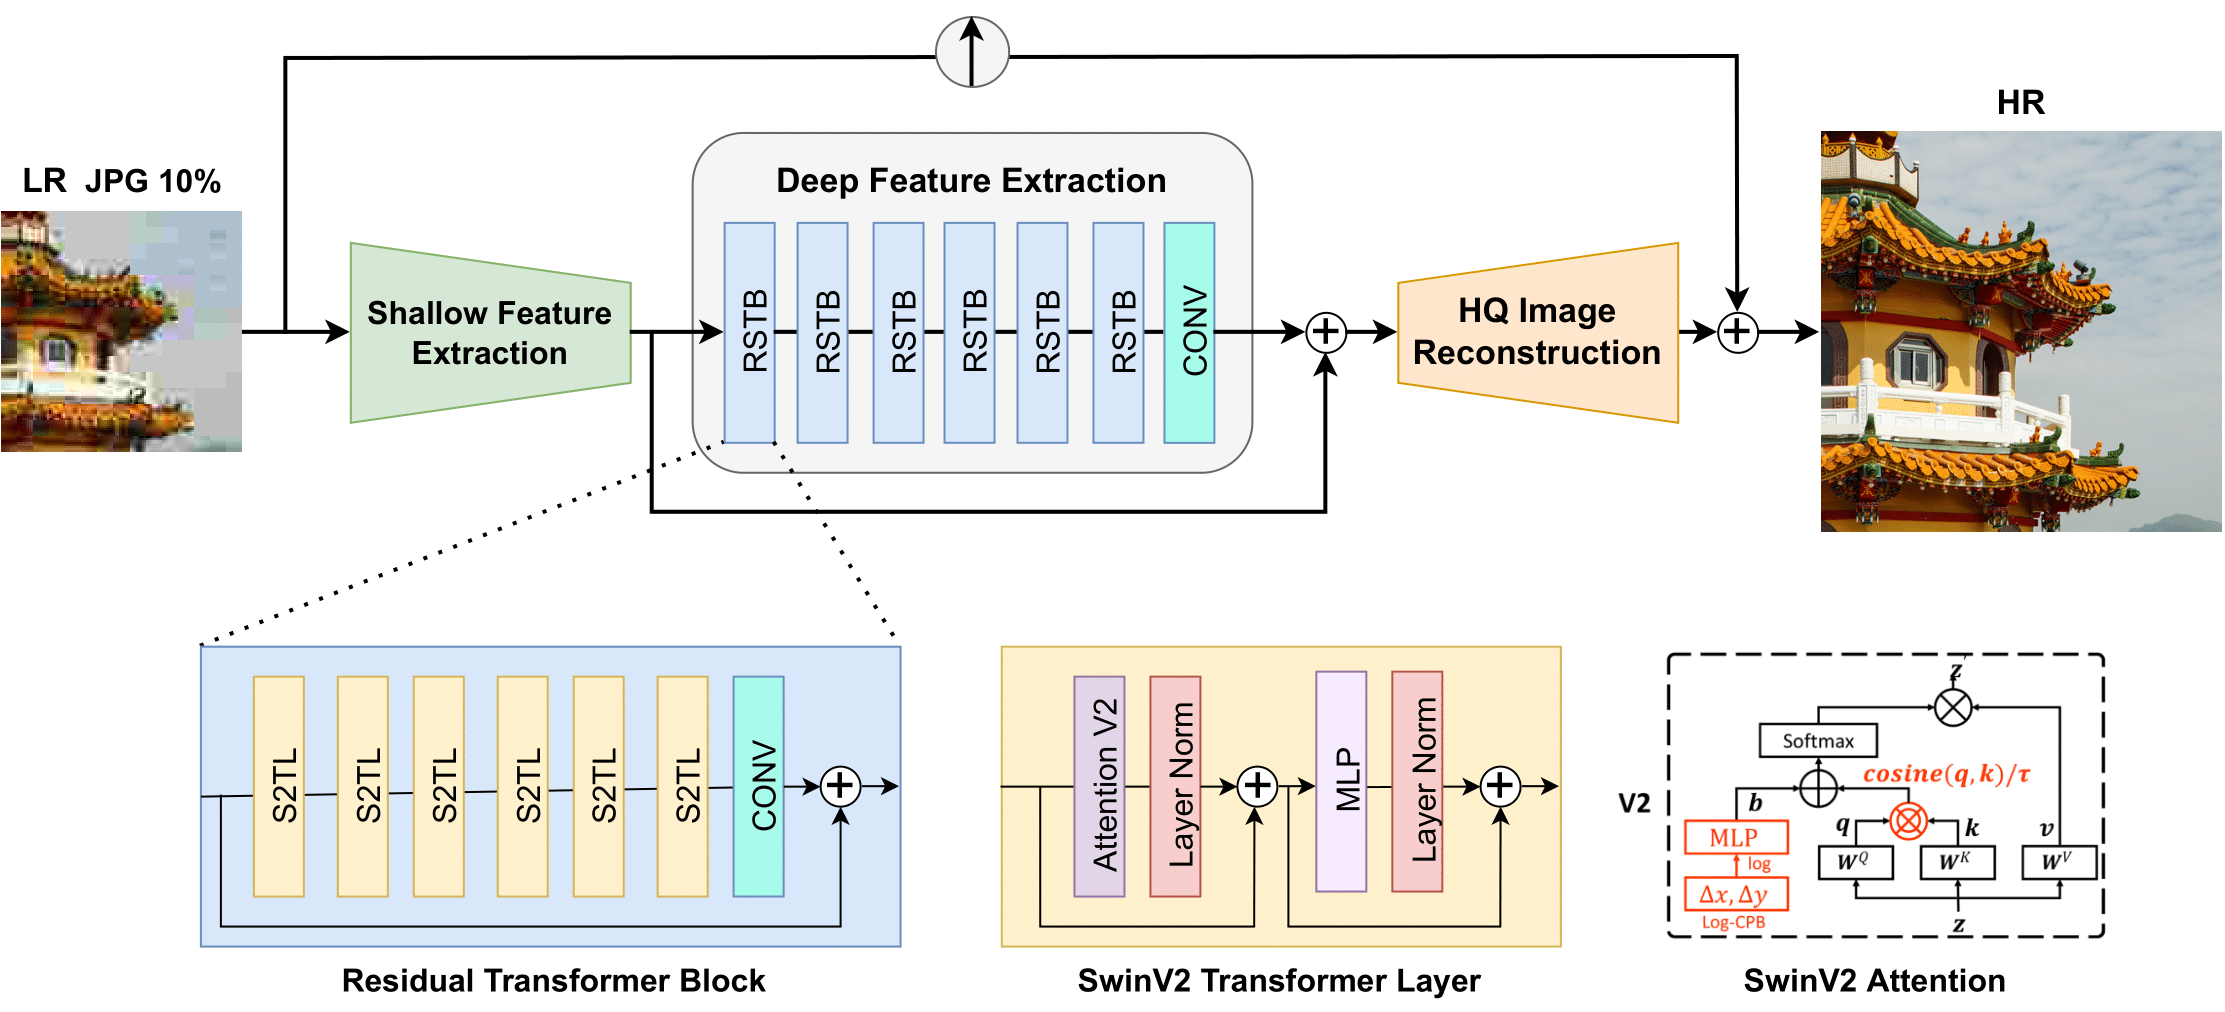 Arsitektur Swin2SR. Diambil dari paper aslinya.
Model ini disumbangkan oleh [nielsr](https://huggingface.co/nielsr). Kode aslinya dapat ditemukan [di sini](https://github.com/mv-lab/swin2sr).
## Sumber daya
Notebook demo untuk Swin2SR dapat ditemukan [di sini](https://github.com/NielsRogge/Transformers-Tutorials/tree/master/Swin2SR).
Demo Space untuk super-resolusi gambar dengan SwinSR dapat ditemukan [di sini](https://huggingface.co/spaces/jjourney1125/swin2sr).
## Swin2SRImageProcessor[[transformers.Swin2SRImageProcessor]]
#### transformers.Swin2SRImageProcessor[[transformers.Swin2SRImageProcessor]]
```python
transformers.Swin2SRImageProcessor(**kwargs: *)
```
[Sumber](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/swin2sr/image_processing_swin2sr.py#L41)
**Parameter:**
do_convert_rgb (`bool`, *kwargs*, *opsional*) : Apakah akan mengkonversi gambar ke RGB.
do_resize (`bool`, *kwargs*, *opsional*) : Apakah akan mengubah ukuran gambar.
size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Menjelaskan dimensi input maksimum ke model.
default_to_square (`bool`, *kwargs*, *opsional*, defaultnya `True`) : Apakah secara default menggunakan gambar persegi saat mengubah ukuran, jika size berupa int.
crop_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Ukuran gambar keluaran setelah menerapkan `center_crop`.
resample (`Annotated[Union[int, PILImageResampling, NoneType], None]`, *kwargs*) : Filter resampling yang digunakan saat mengubah ukuran gambar. Nilai ini dapat berupa salah satu enum `PILImageResampling`. Hanya berpengaruh jika `do_resize` diatur ke `True`.
do_rescale (`bool`, *kwargs*, *opsional*, defaultnya `True`) : Apakah akan melakukan penskalaan ulang pada gambar.
rescale_factor (`float`, *kwargs*, *opsional*, defaultnya `0.00392156862745098`) : Faktor rescale untuk melakukan rescale pada gambar jika `do_rescale` diatur ke `True`.
do_normalize (`bool`, *kwargs*, *opsional*) : Apakah akan menormalisasi gambar.
image_mean (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *opsional*) : Rata-rata gambar yang digunakan untuk normalisasi. Hanya berpengaruh jika `do_normalize` diatur ke `True`.
image_std (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *opsional*) : Standar deviasi gambar yang digunakan untuk normalisasi. Hanya berpengaruh jika `do_normalize` diatur ke `True`.
do_pad (`bool`, *kwargs*, *opsional*, defaultnya `True`) : Apakah akan melakukan padding pada gambar. Padding dilakukan hingga ukuran terbesar dalam batch atau hingga ukuran persegi tetap per gambar. Strategi padding yang tepat bergantung pada model.
pad_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Ukuran dalam `{"height": int, "width" int}` untuk melakukan padding pada gambar. Harus lebih besar dari ukuran gambar mana pun yang diberikan untuk pra-pemrosesan. Jika `pad_size` tidak diberikan, gambar akan di-pad hingga tinggi dan lebar terbesar dalam batch. Diterapkan hanya ketika `do_pad=True.`
do_center_crop (`bool`, *kwargs*, *opsional*) : Apakah akan melakukan center crop pada gambar.
data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *opsional*) : Hanya `ChannelDimension.FIRST` yang didukung. Ditambahkan untuk kompatibilitas dengan prosesor lambat.
input_data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *opsional*) : Format dimensi channel untuk gambar input. Jika tidak disetel, format dimensi channel akan disimpulkan dari gambar input. Bisa berupa salah satu dari: - `"channels_first"` atau `ChannelDimension.FIRST`: gambar dalam format (num_channels, height, width). - `"channels_last"` atau `ChannelDimension.LAST`: gambar dalam format (height, width, num_channels). - `"none"` atau `ChannelDimension.NONE`: gambar dalam format (height, width).
device (`Annotated[Union[str, torch.device, NoneType], None]`, *kwargs*) : Perangkat untuk memproses video. Jika tidak disetel, perangkat akan disimpulkan dari video input.
return_tensors (`Annotated[str | ~utils.generic.TensorType | None, None]`, *kwargs*) : Mengembalikan tensor yang ditumpuk jika disetel ke `'pt'`, selain itu mengembalikan daftar tensor.
disable_grouping (`bool`, *kwargs*, *opsional*) : Apakah akan menonaktifkan pengelompokan gambar berdasarkan ukuran untuk memprosesnya secara individual dan tidak dalam batch. Jika None, akan diset ke True jika gambar berada di CPU, dan False selain itu. Pilihan ini didasarkan pada pengamatan empiris, seperti yang dijelaskan di sini: https://github.com/huggingface/transformers/pull/38157
image_seq_length (`int`, *kwargs*, *opsional*) : Jumlah token gambar yang akan digunakan untuk setiap gambar dalam input. Ditambahkan untuk kompatibilitas mundur, tetapi ini sebaiknya diatur sebagai atribut prosesor pada model-model mendatang.
size_divisor (`int`, *kwargs*, *opsional*, defaultnya `self.size_divisor`) : Ukuran untuk membuat tinggi dan lebar dapat dibagi rata saat padding.
Membangun pemroses gambar Swin2SRImageProcessor.
#### preprocess[[transformers.Swin2SRImageProcessor.preprocess]]
```python
preprocess(images: typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor']], **kwargs: *)
```
[Sumber](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/swin2sr/image_processing_swin2sr.py#L58)
**Parameter:**
images (`Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor]]`) : Gambar yang akan dipreprocess. Mengharapkan satu gambar atau batch gambar dengan nilai piksel berkisar dari 0 hingga 255. Jika memasukkan gambar dengan nilai piksel antara 0 dan 1, atur `do_rescale=False`.
do_convert_rgb (`bool`, *kwargs*, *opsional*) : Apakah akan mengkonversi gambar ke RGB.
do_resize (`bool`, *kwargs*, *opsional*) : Apakah akan mengubah ukuran gambar.
size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Menjelaskan dimensi input maksimum ke model.
default_to_square (`bool`, *kwargs*, *opsional*) : Apakah secara default menggunakan gambar persegi saat mengubah ukuran, jika size berupa int.
crop_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Ukuran gambar keluaran setelah menerapkan `center_crop`.
resample (`Annotated[Union[int, PILImageResampling, NoneType], None]`, *kwargs*) : Filter resampling yang digunakan saat mengubah ukuran gambar. Nilai ini dapat berupa salah satu enum `PILImageResampling`. Hanya berpengaruh jika `do_resize` diatur ke `True`.
do_rescale (`bool`, *kwargs*, *opsional*) : Apakah akan melakukan penskalaan ulang pada gambar.
rescale_factor (`float`, *kwargs*, *opsional*) : Faktor penskalaan ulang untuk menskalakan ulang gambar jika `do_rescale` diatur ke `True`.
do_normalize (`bool`, *kwargs*, *opsional*) : Apakah akan menormalisasi gambar.
image_mean (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *opsional*) : Rata-rata gambar yang digunakan untuk normalisasi. Hanya berpengaruh jika `do_normalize` diatur ke `True`.
image_std (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *opsional*) : Standar deviasi gambar yang digunakan untuk normalisasi. Hanya berpengaruh jika `do_normalize` diatur ke `True`.
do_pad (`bool`, *kwargs*, *opsional*) : Apakah akan melakukan padding pada gambar. Padding dilakukan hingga ukuran terbesar dalam batch atau hingga ukuran persegi tetap per gambar. Strategi padding yang tepat bergantung pada model.
pad_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Ukuran dalam `{"height": int, "width" int}` untuk melakukan padding pada gambar. Harus lebih besar dari ukuran gambar mana pun yang diberikan untuk pra-pemrosesan. Jika `pad_size` tidak diberikan, gambar akan di-pad hingga tinggi dan lebar terbesar dalam batch. Diterapkan hanya ketika `do_pad=True.`
do_center_crop (`bool`, *kwargs*, *opsional*) : Apakah akan melakukan center crop pada gambar.
data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *opsional*) : Hanya `ChannelDimension.FIRST` yang didukung. Ditambahkan untuk kompatibilitas dengan prosesor lambat.
input_data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *opsional*) : Format dimensi channel untuk gambar input. Jika tidak disetel, format dimensi channel akan disimpulkan dari gambar input. Bisa berupa salah satu dari: - `"channels_first"` atau `ChannelDimension.FIRST`: gambar dalam format (num_channels, height, width). - `"channels_last"` atau `ChannelDimension.LAST`: gambar dalam format (height, width, num_channels). - `"none"` atau `ChannelDimension.NONE`: gambar dalam format (height, width).
device (`Annotated[Union[str, torch.device, NoneType], None]`, *kwargs*) : Perangkat untuk memproses video. Jika tidak disetel, perangkat akan disimpulkan dari video input.
return_tensors (`Annotated[str | ~utils.generic.TensorType | None, None]`, *kwargs*) : Mengembalikan tensor yang ditumpuk jika disetel ke `'pt'`, selain itu mengembalikan daftar tensor.
disable_grouping (`bool`, *kwargs*, *opsional*) : Apakah akan menonaktifkan pengelompokan gambar berdasarkan ukuran untuk memprosesnya secara individual dan tidak dalam batch. Jika None, akan diset ke True jika gambar berada di CPU, dan False selain itu. Pilihan ini didasarkan pada pengamatan empiris, seperti yang dijelaskan di sini: https://github.com/huggingface/transformers/pull/38157
image_seq_length (`int`, *kwargs*, *opsional*) : Jumlah token gambar yang akan digunakan untuk setiap gambar dalam input. Ditambahkan untuk kompatibilitas mundur, tetapi ini sebaiknya diatur sebagai atribut prosesor pada model-model mendatang.
size_divisor (`int`, *kwargs*, *opsional*, defaultnya `self.size_divisor`) : Ukuran untuk membuat tinggi dan lebar dapat dibagi rata saat padding.
**Mengembalikan:** `~image_processing_base.BatchFeature`
- **data** (`dict`) -- Dictionary berisi list/array/tensor yang dikembalikan oleh metode __call__ ('pixel_values', dll.).
- **tensor_type** (`Union[None, str, TensorType]`, *opsional*) -- Anda dapat memberikan tensor_type di sini untuk mengonversi daftar bilangan bulat menjadi Tensor PyTorch/Numpy saat inisialisasi.
## Swin2SRImageProcessorPil[[transformers.Swin2SRImageProcessorPil]]
#### transformers.Swin2SRImageProcessorPil[[transformers.Swin2SRImageProcessorPil]]
```python
transformers.Swin2SRImageProcessorPil(**kwargs: *)
```
[Sumber](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/swin2sr/image_processing_pil_swin2sr.py#L42)
**Parameter:**
do_convert_rgb (`bool`, *kwargs*, *opsional*) : Apakah akan mengkonversi gambar ke RGB.
do_resize (`bool`, *kwargs*, *opsional*) : Apakah akan mengubah ukuran gambar.
size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Menjelaskan dimensi input maksimum ke model.
default_to_square (`bool`, *kwargs*, *opsional*, defaultnya `True`) : Apakah secara default menggunakan gambar persegi saat mengubah ukuran, jika size berupa int.
crop_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Ukuran gambar keluaran setelah menerapkan `center_crop`.
resample (`Annotated[Union[int, PILImageResampling, NoneType], None]`, *kwargs*) : Filter resampling yang digunakan saat mengubah ukuran gambar. Nilai ini dapat berupa salah satu enum `PILImageResampling`. Hanya berpengaruh jika `do_resize` diatur ke `True`.
do_rescale (`bool`, *kwargs*, *opsional*, defaultnya `True`) : Apakah akan melakukan penskalaan ulang pada gambar.
rescale_factor (`float`, *kwargs*, *opsional*, defaultnya `0.00392156862745098`) : Faktor rescale untuk melakukan rescale pada gambar jika `do_rescale` diatur ke `True`.
do_normalize (`bool`, *kwargs*, *opsional*) : Apakah akan menormalisasi gambar.
image_mean (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *opsional*) : Rata-rata gambar yang digunakan untuk normalisasi. Hanya berpengaruh jika `do_normalize` diatur ke `True`.
image_std (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *opsional*) : Standar deviasi gambar yang digunakan untuk normalisasi. Hanya berpengaruh jika `do_normalize` diatur ke `True`.
do_pad (`bool`, *kwargs*, *opsional*, defaultnya `True`) : Apakah akan melakukan padding pada gambar. Padding dilakukan hingga ukuran terbesar dalam batch atau hingga ukuran persegi tetap per gambar. Strategi padding yang tepat bergantung pada model.
pad_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Ukuran dalam `{"height": int, "width" int}` untuk melakukan padding pada gambar. Harus lebih besar dari ukuran gambar mana pun yang diberikan untuk pra-pemrosesan. Jika `pad_size` tidak diberikan, gambar akan di-pad hingga tinggi dan lebar terbesar dalam batch. Diterapkan hanya ketika `do_pad=True.`
do_center_crop (`bool`, *kwargs*, *opsional*) : Apakah akan melakukan center crop pada gambar.
data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *opsional*) : Hanya `ChannelDimension.FIRST` yang didukung. Ditambahkan untuk kompatibilitas dengan prosesor lambat.
input_data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *opsional*) : Format dimensi channel untuk gambar input. Jika tidak disetel, format dimensi channel akan disimpulkan dari gambar input. Bisa berupa salah satu dari: - `"channels_first"` atau `ChannelDimension.FIRST`: gambar dalam format (num_channels, height, width). - `"channels_last"` atau `ChannelDimension.LAST`: gambar dalam format (height, width, num_channels). - `"none"` atau `ChannelDimension.NONE`: gambar dalam format (height, width).
device (`Annotated[Union[str, torch.device, NoneType], None]`, *kwargs*) : Perangkat untuk memproses video. Jika tidak disetel, perangkat akan disimpulkan dari video input.
return_tensors (`Annotated[str | ~utils.generic.TensorType | None, None]`, *kwargs*) : Mengembalikan tensor yang ditumpuk jika disetel ke `'pt'`, selain itu mengembalikan daftar tensor.
disable_grouping (`bool`, *kwargs*, *opsional*) : Apakah akan menonaktifkan pengelompokan gambar berdasarkan ukuran untuk memprosesnya secara individual dan tidak dalam batch. Jika None, akan diset ke True jika gambar berada di CPU, dan False selain itu. Pilihan ini didasarkan pada pengamatan empiris, seperti yang dijelaskan di sini: https://github.com/huggingface/transformers/pull/38157
image_seq_length (`int`, *kwargs*, *opsional*) : Jumlah token gambar yang akan digunakan untuk setiap gambar dalam input. Ditambahkan untuk kompatibilitas mundur, tetapi ini sebaiknya diatur sebagai atribut prosesor pada model-model mendatang.
size_divisor (`int`, *kwargs*, *opsional*, defaultnya `self.size_divisor`) : Ukuran untuk membuat tinggi dan lebar dapat dibagi rata saat padding.
Membangun pemroses gambar Swin2SRImageProcessor.
#### preprocess[[transformers.Swin2SRImageProcessorPil.preprocess]]
```python
preprocess(images: typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor']], **kwargs: *)
```
[Sumber](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/swin2sr/image_processing_pil_swin2sr.py#L59)
**Parameter:**
images (`Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor]]`) : Gambar yang akan dipreprocess. Mengharapkan satu gambar atau batch gambar dengan nilai piksel berkisar dari 0 hingga 255. Jika memasukkan gambar dengan nilai piksel antara 0 dan 1, atur `do_rescale=False`.
do_convert_rgb (`bool`, *kwargs*, *opsional*) : Apakah akan mengkonversi gambar ke RGB.
do_resize (`bool`, *kwargs*, *opsional*) : Apakah akan mengubah ukuran gambar.
size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Menjelaskan dimensi input maksimum ke model.
default_to_square (`bool`, *kwargs*, *opsional*) : Apakah secara default menggunakan gambar persegi saat mengubah ukuran, jika size berupa int.
crop_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Ukuran gambar keluaran setelah menerapkan `center_crop`.
resample (`Annotated[Union[int, PILImageResampling, NoneType], None]`, *kwargs*) : Filter resampling yang digunakan saat mengubah ukuran gambar. Nilai ini dapat berupa salah satu enum `PILImageResampling`. Hanya berpengaruh jika `do_resize` diatur ke `True`.
do_rescale (`bool`, *kwargs*, *opsional*) : Apakah akan melakukan penskalaan ulang pada gambar.
rescale_factor (`float`, *kwargs*, *opsional*) : Faktor penskalaan ulang untuk menskalakan ulang gambar jika `do_rescale` diatur ke `True`.
do_normalize (`bool`, *kwargs*, *opsional*) : Apakah akan menormalisasi gambar.
image_mean (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *opsional*) : Rata-rata gambar yang digunakan untuk normalisasi. Hanya berpengaruh jika `do_normalize` diatur ke `True`.
image_std (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *opsional*) : Standar deviasi gambar yang digunakan untuk normalisasi. Hanya berpengaruh jika `do_normalize` diatur ke `True`.
do_pad (`bool`, *kwargs*, *opsional*) : Apakah akan melakukan padding pada gambar. Padding dilakukan hingga ukuran terbesar dalam batch atau hingga ukuran persegi tetap per gambar. Strategi padding yang tepat bergantung pada model.
pad_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Ukuran dalam `{"height": int, "width" int}` untuk melakukan padding pada gambar. Harus lebih besar dari ukuran gambar mana pun yang diberikan untuk pra-pemrosesan. Jika `pad_size` tidak diberikan, gambar akan di-pad hingga tinggi dan lebar terbesar dalam batch. Diterapkan hanya ketika `do_pad=True.`
do_center_crop (`bool`, *kwargs*, *opsional*) : Apakah akan melakukan center crop pada gambar.
data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *opsional*) : Hanya `ChannelDimension.FIRST` yang didukung. Ditambahkan untuk kompatibilitas dengan prosesor lambat.
input_data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *opsional*) : Format dimensi channel untuk gambar input. Jika tidak disetel, format dimensi channel akan disimpulkan dari gambar input. Bisa berupa salah satu dari: - `"channels_first"` atau `ChannelDimension.FIRST`: gambar dalam format (num_channels, height, width). - `"channels_last"` atau `ChannelDimension.LAST`: gambar dalam format (height, width, num_channels). - `"none"` atau `ChannelDimension.NONE`: gambar dalam format (height, width).
device (`Annotated[Union[str, torch.device, NoneType], None]`, *kwargs*) : Perangkat untuk memproses video. Jika tidak disetel, perangkat akan disimpulkan dari video input.
return_tensors (`Annotated[str | ~utils.generic.TensorType | None, None]`, *kwargs*) : Mengembalikan tensor yang ditumpuk jika disetel ke `'pt'`, selain itu mengembalikan daftar tensor.
disable_grouping (`bool`, *kwargs*, *opsional*) : Apakah akan menonaktifkan pengelompokan gambar berdasarkan ukuran untuk memprosesnya secara individual dan tidak dalam batch. Jika None, akan diset ke True jika gambar berada di CPU, dan False selain itu. Pilihan ini didasarkan pada pengamatan empiris, seperti yang dijelaskan di sini: https://github.com/huggingface/transformers/pull/38157
image_seq_length (`int`, *kwargs*, *opsional*) : Jumlah token gambar yang akan digunakan untuk setiap gambar dalam input. Ditambahkan untuk kompatibilitas mundur, tetapi ini sebaiknya diatur sebagai atribut prosesor pada model-model mendatang.
size_divisor (`int`, *kwargs*, *opsional*, defaultnya `self.size_divisor`) : Ukuran untuk membuat tinggi dan lebar dapat dibagi rata saat padding.
**Mengembalikan:** `~image_processing_base.BatchFeature`
- **data** (`dict`) -- Dictionary berisi list/array/tensor yang dikembalikan oleh metode __call__ ('pixel_values', dll.).
- **tensor_type** (`Union[None, str, TensorType]`, *opsional*) -- Anda dapat memberikan tensor_type di sini untuk mengonversi daftar bilangan bulat menjadi Tensor PyTorch/Numpy saat inisialisasi.
## Swin2SRConfig[[transformers.Swin2SRConfig]]
#### transformers.Swin2SRConfig[[transformers.Swin2SRConfig]]
```python
transformers.Swin2SRConfig(transformers_version: str | None = None, architectures: list[str] | None = None, output_hidden_states: bool | None = False, return_dict: bool | None = True, dtype: str | torch.dtype | None = None, chunk_size_feed_forward: int = 0, is_encoder_decoder: bool = False, id2label: dict[int, str] | dict[str, str] | None = None, label2id: dict[str, int] | dict[str, str] | None = None, problem_type: Literal['regression', 'single_label_classification', 'multi_label_classification'] | None = None, image_size: int | list[int] | tuple[int, int] = 64, patch_size: int | list[int] | tuple[int, int] = 1, num_channels: int = 3, num_channels_out: int | None = None, embed_dim: int = 180, depths: list[int] | tuple[int, ...] = (6, 6, 6, 6, 6, 6), num_heads: list[int] | tuple[int, ...] = (6, 6, 6, 6, 6, 6), window_size: int = 8, mlp_ratio: float = 2.0, qkv_bias: bool = True, hidden_dropout_prob: float | int = 0.0, attention_probs_dropout_prob: float | int = 0.0, drop_path_rate: float | int = 0.1, hidden_act: str = 'gelu', use_absolute_embeddings: bool = False, initializer_range: float = 0.02, layer_norm_eps: float = 1e-05, upscale: int = 2, img_range: float = 1.0, resi_connection: str = '1conv', upsampler: str = 'pixelshuffle')
```
[Sumber](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/swin2sr/configuration_swin2sr.py#L24)
**Parameter:**
image_size (`Union[int, list[int], tuple[int, int]]`, *opsional*, defaultnya `64`) : Ukuran (resolusi) dari setiap gambar.
patch_size (`Union[int, list[int], tuple[int, int]]`, *opsional*, defaultnya `1`) : Ukuran (resolusi) dari setiap patch.
num_channels (`int`, *opsional*, default `3`) : Jumlah saluran input.
num_channels_out (`int`, *opsional*, defaultnya `num_channels`) : Jumlah saluran output. Jika tidak diatur, nilainya akan diset ke `num_channels`.
embed_dim (`int`, *opsional*, defaultnya `180`) : Dimensi dari embedding dan hidden states.
depths (`list(int)`, *opsional*, defaultnya `[6, 6, 6, 6, 6, 6]`) : Kedalaman setiap lapisan dalam encoder Transformer.
num_heads (`list(int)`, *opsional*, defaultnya `[6, 6, 6, 6, 6, 6]`) : Jumlah kepala perhatian di setiap lapisan encoder Transformer.
window_size (`int`, *opsional*, defaultnya 8) : Ukuran jendela.
mlp_ratio (`float`, *opsional*, defaultnya `2.0`) : Rasio dimensi tersembunyi MLP terhadap dimensi embedding.
qkv_bias (`bool`, *opsional*, defaultnya `True`) : Apakah akan menambahkan bias ke queries, keys, dan values.
hidden_dropout_prob (`Union[float, int]`, *opsional*, defaultnya `0.0`) : Probabilitas dropout untuk semua lapisan fully connected di embeddings, encoder, dan pooler.
attention_probs_dropout_prob (`Union[float, int]`, *opsional*, defaultnya `0.0`) : Rasio dropout untuk probabilitas perhatian.
drop_path_rate (`Union[float, int]`, *opsional*, defaultnya `0.1`) : Tingkat drop path untuk fusi patch.
hidden_act (`str`, *opsional*, defaultnya `gelu`) : Fungsi aktivasi non-linear (fungsi atau string) di decoder. Misalnya, `"gelu"`, `"relu"`, `"silu"`, dan sebagainya.
use_absolute_embeddings (`bool`, *opsional*, defaultnya `False`) : Apakah akan menggunakan embedding posisi absolut.
initializer_range (`float`, *opsional*, defaultnya `0.02`) : Deviasi standar dari truncated_normal_initializer untuk menginisialisasi semua matriks bobot.
layer_norm_eps (`float`, *opsional*, defaultnya `1e-05`) : Epsilon yang digunakan oleh lapisan normalisasi lapisan.
upscale (`int`, *opsional*, default 2) : Faktor upscale untuk gambar. 2/3/4/8 untuk super resolusi gambar, 1 untuk denoising dan pengurangan artefak kompresi
img_range (`float`, *opsional*, default 1.0) : Rentang nilai dari gambar input.
resi_connection (`str`, *opsional*, defaultnya `"1conv"`) : Blok konvolusi yang digunakan sebelum koneksi residual di setiap tahap.
upsampler (`str`, *opsional*, defaultnya `"pixelshuffle"`) : Modul rekonstruksi. Bisa berupa 'pixelshuffle'/'pixelshuffledirect'/'nearest+conv'/None.
Ini adalah kelas konfigurasi untuk menyimpan konfigurasi dari Swin2SRModel. Kelas ini digunakan untuk membuat instans model Swin2Sr berdasarkan argumen yang ditentukan, yang mendefinisikan arsitektur model. Membuat instans konfigurasi dengan nilai bawaan akan menghasilkan konfigurasi yang serupa dengan konfigurasi dari [caidas/swin2sr-classicalsr-x2-64](https://huggingface.co/caidas/swin2sr-classicalsr-x2-64)
Objek konfigurasi mewarisi dari [PreTrainedConfig](/docs/transformers/v5.23.0/id/main_classes/configuration#transformers.PreTrainedConfig) dan dapat digunakan untuk mengontrol keluaran model. Baca dokumentasi dari [PreTrainedConfig](/docs/transformers/v5.23.0/id/main_classes/configuration#transformers.PreTrainedConfig) untuk informasi lebih lanjut.
Contoh:
```python
>>> from transformers import Swin2SRConfig, Swin2SRModel
>>> # Initializing a Swin2SR caidas/swin2sr-classicalsr-x2-64 style configuration
>>> configuration = Swin2SRConfig()
>>> # Initializing a model (with random weights) from the caidas/swin2sr-classicalsr-x2-64 style configuration
>>> model = Swin2SRModel(configuration)
>>> # Accessing the model configuration
>>> configuration = model.config
```
## Swin2SRModel[[transformers.Swin2SRModel]]
#### transformers.Swin2SRModel[[transformers.Swin2SRModel]]
```python
transformers.Swin2SRModel(config: Swin2SRConfig)
```
[Sumber](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/swin2sr/modeling_swin2sr.py#L710)
**Parameter:**
config ([Swin2SRConfig](/docs/transformers/v5.23.0/id/model_doc/swin2sr#transformers.Swin2SRConfig)) : Kelas konfigurasi model dengan semua parameter model. Inisialisasi dengan file konfigurasi tidak memuat bobot yang terkait dengan model, hanya konfigurasinya. Lihat metode [from_pretrained()](/docs/transformers/v5.23.0/id/main_classes/model#transformers.PreTrainedModel.from_pretrained) untuk memuat bobot model.
Model Swin2Sr polos yang menghasilkan hidden-states mentah tanpa head spesifik di atasnya.
Model ini mewarisi dari [PreTrainedModel](/docs/transformers/v5.23.0/id/main_classes/model#transformers.PreTrainedModel). Periksa dokumentasi kelas induk untuk metode generik yang diimplementasikan oleh pustaka ini untuk semua model (seperti mengunduh atau menyimpan, mengubah ukuran input embeddings, memangkas heads, dll.)
Model ini juga merupakan subclass dari [torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module) PyTorch. Gunakan sebagai PyTorch Module biasa dan merujuk ke dokumentasi PyTorch untuk semua hal yang berkaitan dengan penggunaan dan perilaku umum.
#### forward[[transformers.Swin2SRModel.forward]]
```python
forward(pixel_values: Tensor, output_attentions: bool | None = None, output_hidden_states: bool | None = None, return_dict: bool | None = None, **kwargs)
```
[Sumber](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/swin2sr/modeling_swin2sr.py#L752)
**Parameter:**
pixel_values (`torch.Tensor` dengan bentuk `(batch_size, num_channels, image_size, image_size)`) : Tensor yang sesuai dengan gambar input. Nilai piksel dapat diperoleh menggunakan [Swin2SRImageProcessor](/docs/transformers/v5.23.0/id/model_doc/swin2sr#transformers.Swin2SRImageProcessor). Lihat [Swin2SRImageProcessor.__call__()](/docs/transformers/v5.23.0/id/model_doc/molmo2#transformers.Molmo2ImageProcessor.__call__) untuk detailnya (`processor_class` menggunakan [Swin2SRImageProcessor](/docs/transformers/v5.23.0/id/model_doc/swin2sr#transformers.Swin2SRImageProcessor) untuk memproses gambar).
output_attentions (`bool`, *opsional*) : Apakah akan mengembalikan tensor perhatian dari semua lapisan perhatian. Lihat `attentions` di bawah tensor yang dikembalikan untuk detail lebih lanjut.
output_hidden_states (`bool`, *opsional*) : Apakah akan mengembalikan hidden states dari semua lapisan. Lihat `hidden_states` di bawah tensor yang dikembalikan untuk detail lebih lanjut.
return_dict (`bool`, *opsional*) : Apakah akan mengembalikan [ModelOutput](/docs/transformers/v5.23.0/id/main_classes/output#transformers.utils.ModelOutput) alih-alih tuple biasa.
**Mengembalikan:** [BaseModelOutput](/docs/transformers/v5.23.0/id/main_classes/output#transformers.modeling_outputs.BaseModelOutput) atau `tuple(torch.Tensor)`
[BaseModelOutput](/docs/transformers/v5.23.0/id/main_classes/output#transformers.modeling_outputs.BaseModelOutput) atau tuple dari `torch.Tensor` (jika `return_dict=False` dilewatkan atau ketika `config.return_dict=False`) yang terdiri dari berbagai elemen tergantung pada konfigurasi ([Swin2SRConfig](/docs/transformers/v5.23.0/id/model_doc/swin2sr#transformers.Swin2SRConfig)) dan input.
Metode forward dari [Swin2SRModel](/docs/transformers/v5.23.0/id/model_doc/swin2sr#transformers.Swin2SRModel) menimpa metode khusus `__call__`.
Meskipun resep untuk forward pass perlu didefinisikan di dalam fungsi ini, sebaiknya panggil instance `Module` setelahnya alih-alih fungsi ini, karena yang pertama menangani langkah-langkah pra-pemrosesan dan pasca-pemrosesan, sedangkan yang kedua mengabaikannya secara diam-diam.
- **last_hidden_state** (`torch.Tensor` dengan bentuk `(batch_size, sequence_length, hidden_size)`) -- Urutan hidden-states pada keluaran lapisan terakhir model.
- **hidden_states** (`tuple(torch.Tensor)`, *opsional*, dikembalikan saat `output_hidden_states=True` dilewatkan atau saat `config.output_hidden_states=True`) -- Tuple dari `torch.Tensor` (satu untuk output dari embeddings, jika model memiliki lapisan embedding, + satu untuk output dari setiap lapisan) dengan bentuk `(batch_size, sequence_length, hidden_size)`.
Hidden-states model pada output setiap layer ditambah output embedding awal yang opsional.
- **attentions** (`tuple(torch.Tensor)`, *opsional*, dikembalikan ketika `output_attentions=True` dilewatkan atau ketika `config.output_attentions=True`) -- Tuple dari `torch.Tensor` (satu untuk setiap layer) dengan bentuk `(batch_size, num_heads, sequence_length, sequence_length)`.
Bobot perhatian setelah softmax perhatian, digunakan untuk menghitung rata-rata berbobot di kepala self-attention.
Contoh:
```python
```
## Swin2SRForImageSuperResolution[[transformers.Swin2SRForImageSuperResolution]]
#### transformers.Swin2SRForImageSuperResolution[[transformers.Swin2SRForImageSuperResolution]]
```python
transformers.Swin2SRForImageSuperResolution(config: Swin2SRConfig)
```
[Sumber](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/swin2sr/modeling_swin2sr.py#L943)
**Parameter:**
config ([Swin2SRConfig](/docs/transformers/v5.23.0/id/model_doc/swin2sr#transformers.Swin2SRConfig)) : Kelas konfigurasi model dengan semua parameter model. Inisialisasi dengan file konfigurasi tidak memuat bobot yang terkait dengan model, hanya konfigurasinya. Lihat metode [from_pretrained()](/docs/transformers/v5.23.0/id/main_classes/model#transformers.PreTrainedModel.from_pretrained) untuk memuat bobot model.
Model transformer Swin2SR dengan kepala upsampler di atasnya untuk super resolusi dan restorasi gambar.
Model ini mewarisi dari [PreTrainedModel](/docs/transformers/v5.23.0/id/main_classes/model#transformers.PreTrainedModel). Periksa dokumentasi kelas induk untuk metode generik yang diimplementasikan oleh pustaka ini untuk semua model (seperti mengunduh atau menyimpan, mengubah ukuran input embeddings, memangkas heads, dll.)
Model ini juga merupakan subclass dari [torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module) PyTorch. Gunakan sebagai PyTorch Module biasa dan merujuk ke dokumentasi PyTorch untuk semua hal yang berkaitan dengan penggunaan dan perilaku umum.
#### forward[[transformers.Swin2SRForImageSuperResolution.forward]]
```python
forward(pixel_values: typing.Optional[torch.Tensor] = None, labels: typing.Optional[torch.LongTensor] = None, output_attentions: bool | None = None, output_hidden_states: bool | None = None, return_dict: bool | None = None, **kwargs)
```
[Sumber](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/swin2sr/modeling_swin2sr.py#L970)
**Parameter:**
pixel_values (`torch.Tensor` dengan bentuk `(batch_size, num_channels, image_size, image_size)`, *opsional*) : Tensor yang sesuai dengan gambar input. Nilai piksel dapat diperoleh menggunakan [Swin2SRImageProcessor](/docs/transformers/v5.23.0/id/model_doc/swin2sr#transformers.Swin2SRImageProcessor). Lihat [Swin2SRImageProcessor.__call__()](/docs/transformers/v5.23.0/id/model_doc/molmo2#transformers.Molmo2ImageProcessor.__call__) untuk detailnya (`processor_class` menggunakan [Swin2SRImageProcessor](/docs/transformers/v5.23.0/id/model_doc/swin2sr#transformers.Swin2SRImageProcessor) untuk memproses gambar).
labels (`torch.LongTensor` dengan bentuk `(batch_size, sequence_length)`, *opsional*) : Label untuk menghitung kerugian pemodelan bahasa yang disamarkan. Indeks harus berada di `[0, ..., config.vocab_size]` atau -100 (lihat docstring `input_ids`). Token dengan indeks yang disetel ke `-100` diabaikan (disamarkan), kerugian hanya dihitung untuk token dengan label di `[0, ..., config.vocab_size]`.
output_attentions (`bool`, *opsional*) : Apakah akan mengembalikan tensor perhatian dari semua lapisan perhatian. Lihat `attentions` di bawah tensor yang dikembalikan untuk detail lebih lanjut.
output_hidden_states (`bool`, *opsional*) : Apakah akan mengembalikan hidden states dari semua lapisan. Lihat `hidden_states` di bawah tensor yang dikembalikan untuk detail lebih lanjut.
return_dict (`bool`, *opsional*) : Apakah akan mengembalikan [ModelOutput](/docs/transformers/v5.23.0/id/main_classes/output#transformers.utils.ModelOutput) alih-alih tuple biasa.
**Mengembalikan:** `ImageSuperResolutionOutput` atau `tuple(torch.Tensor)`
A `ImageSuperResolutionOutput` atau tuple dari `torch.Tensor` (jika `return_dict=False` dilewatkan atau ketika `config.return_dict=False`) yang terdiri dari berbagai elemen tergantung pada konfigurasi ([Swin2SRConfig](/docs/transformers/v5.23.0/id/model_doc/swin2sr#transformers.Swin2SRConfig)) dan input.
Metode forward dari [Swin2SRForImageSuperResolution](/docs/transformers/v5.23.0/id/model_doc/swin2sr#transformers.Swin2SRForImageSuperResolution) menimpa metode khusus `__call__`.
Meskipun resep untuk forward pass perlu didefinisikan di dalam fungsi ini, sebaiknya panggil instance `Module` setelahnya alih-alih fungsi ini, karena yang pertama menangani langkah-langkah pra-pemrosesan dan pasca-pemrosesan, sedangkan yang kedua mengabaikannya secara diam-diam.
- **loss** (`torch.Tensor` dengan bentuk `(1,)`, *opsional*, dikembalikan ketika `labels` disediakan) -- Loss rekonstruksi.
- **rekonstruksi** (`torch.Tensor` dengan bentuk `(batch_size, num_channels, height, width)`) -- Gambar yang direkonstruksi, mungkin telah di-upscale.
- **hidden_states** (`tuple(torch.Tensor)`, *opsional*, dikembalikan saat `output_hidden_states=True` dilewatkan atau saat `config.output_hidden_states=True`) -- Tuple dari `torch.Tensor` (satu untuk output dari embeddings, jika model memiliki lapisan embedding, + satu untuk output dari setiap tahap) dengan bentuk `(batch_size, sequence_length, hidden_size)`. Hidden-states (juga disebut feature maps) dari model pada output dari setiap tahap.
- **attentions** (`tuple(torch.Tensor)`, *opsional*, dikembalikan ketika `output_attentions=True` dilewatkan atau ketika `config.output_attentions=True`) -- Tuple dari `torch.Tensor` (satu untuk setiap layer) dengan bentuk `(batch_size, num_heads, patch_size, sequence_length)`.
Bobot perhatian setelah softmax perhatian, digunakan untuk menghitung rata-rata berbobot di kepala self-attention.
Contoh:
```python
>>> import torch
>>> import numpy as np
>>> from PIL import Image
>>> from huggingface_hub.utils import httpx
>> from io import BytesIO
>>> from transformers import AutoImageProcessor, Swin2SRForImageSuperResolution
>>> processor = AutoImageProcessor.from_pretrained("caidas/swin2SR-classical-sr-x2-64")
>>> model = Swin2SRForImageSuperResolution.from_pretrained("caidas/swin2SR-classical-sr-x2-64")
>>> url = "https://huggingface.co/spaces/jjourney1125/swin2sr/resolve/main/samples/butterfly.jpg"
>>> with httpx.stream("GET", url) as response:
... image = Image.open(BytesIO(response.read()))
>>> # prepare image for the model
>>> inputs = processor(image, return_tensors="pt")
>>> # forward pass
>>> with torch.no_grad():
... outputs = model(**inputs)
>>> output = outputs.reconstruction.data.squeeze().float().cpu().clamp_(0, 1).numpy()
>>> output = np.moveaxis(output, source=0, destination=-1)
>>> output = (output * 255.0).round().astype(np.uint8) # float32 to uint8
>>> # you can visualize `output` with `Image.fromarray`
```